La question qui reste après l’exposé
Le 15 octobre 2026, j’ai écouté Yves Zumbühl, de botts.ai, parler de développement de solutions souveraines. En sortant, une question d’achat toute simple ne me quittait plus : qu’obtenons-nous vraiment pour l’argent que nous dépensons en IA ? L’exposé a déclenché cette enquête. L’analyse et les conclusions qui suivent sont les miennes ; ce n’est ni une citation ni une caution d’Yves.12
On peut comparer des abonnements. On peut compter des jetons. On peut discuter fenêtres de contexte, remises à zéro, familles de modèles et niveaux de raisonnement. Pour qui manie ces outils, tous ces détails comptent.
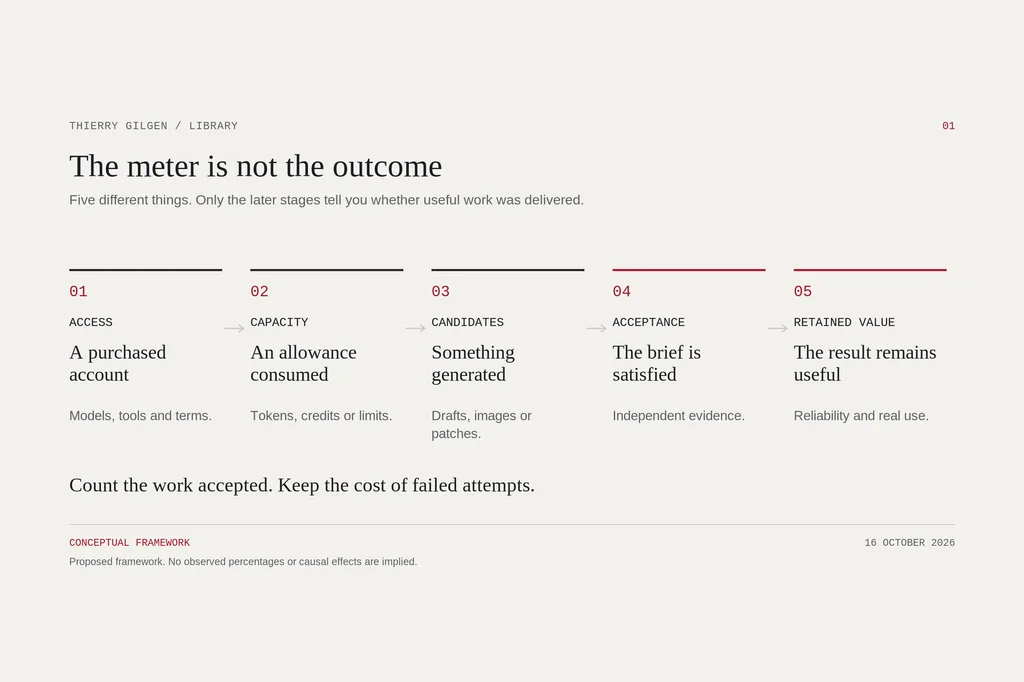
Mais aucun n’est ce que le client est venu acheter.
Le client a besoin d’un document qu’il peut envoyer. D’une image qu’il peut utiliser. D’un problème réglé. D’une fonction qui marche dans l’application existante. D’une version qui tient le choc de la production.
Une machine peut être très occupée sans rapprocher le moins du monde l’un de ces résultats.
Ce n’est pas un plaidoyer contre l’IA. C’est un plaidoyer pour prendre sa valeur assez au sérieux pour mesurer la bonne chose. Un abonnement bon marché qui renvoie sans cesse du travail inachevé à un humain peut coûter cher. Un modèle coûteux qui épargne une heure de reprise à un expert peut être une excellente affaire. Ni l’une ni l’autre conclusion ne se déduit de la taille du quota.
L’unité qui compte, c’est le travail accepté, dans des conditions énoncées, à un coût total connu.
Ce que ce volume établit
Quotas d’abonnement, prix d’API et scores de benchmark décrivent des achats différents. On ne doit pas les fondre en un chiffre inventé de « tâches terminées par mois ». Les données publiques aident à choisir quoi tester, mais elles ne désignent aucun abonnement supérieur en toutes circonstances. Ce qui manque, c’est la mesure du chemin complet entre la commande et l’acceptation, puis, quand c’est important, de la fiabilité du travail par la suite.
1. Quatre achats cachés dans un seul abonnement
Un abonnement IA regroupe au moins quatre choses : l’accès à des modèles, un logiciel qui leur permet de travailler, un quota d’utilisation et des conditions qui régissent les données et l’administration.
Le modèle n’est pas tout le produit. Un agent de programmation a aussi besoin du contexte du dépôt, d’outils qui fonctionnent, d’instructions utiles et d’un environnement d’exécution fiable. Un assistant qui produit un tableur doit faire plus que bien raisonner : le fichier doit s’ouvrir, les formules doivent tomber juste et le destinataire doit comprendre le résultat.
Le quota n’est pas non plus une unité commune. Claude décrit des multiplicateurs de session assortis de plafonds hebdomadaires. OpenAI publie des estimations d’usage qui varient selon le modèle. Les abonnements actuels de Cursor mettent l’usage en commun entre plusieurs produits, tandis que les anciens comptes gardent une autre structure. Chez Google, les limites des modèles et les crédits créatifs ne s’échangent pas.34567
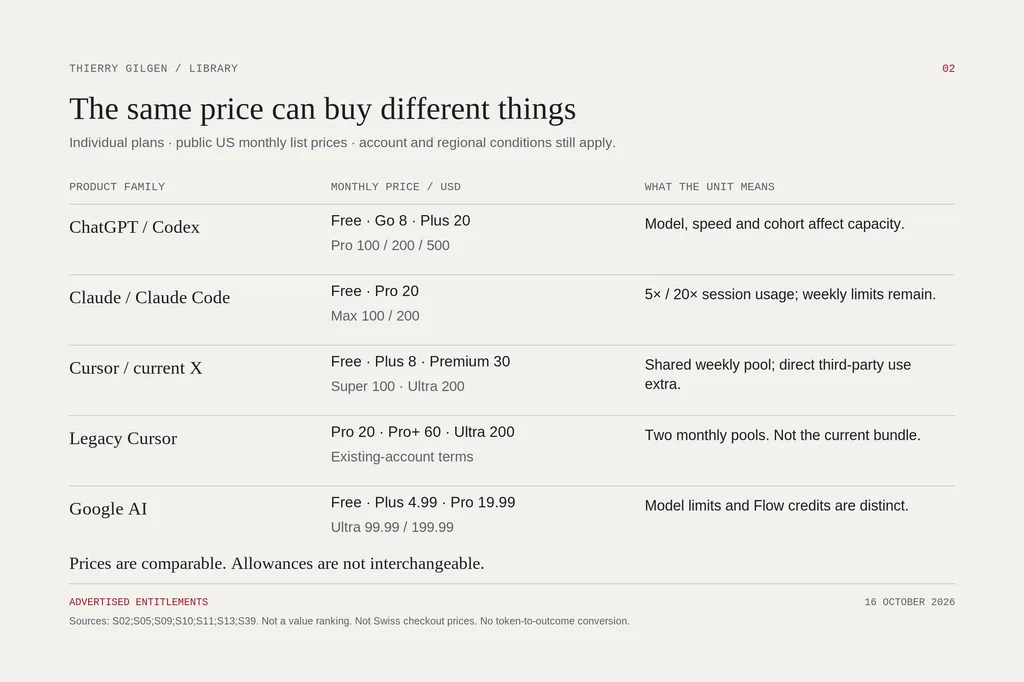
Voici la carte des prix des abonnements individuels à la date d’arrêt de cette édition. Ce sont des prix catalogue publics américains, pas des montants facturés en Suisse. Taxes, canal de paiement, région et historique du compte peuvent changer ce que paie réellement un client.
| Famille de produits | Prix catalogue mensuels | La distinction à garder |
|---|---|---|
| ChatGPT / Codex | Free ; Go USD 8 ; Plus USD 20 ; Pro USD 100 / 200 / 500 | Formule, modèle, mode de vitesse et cohorte du compte déterminent la capacité utilisable. |
| Claude / Claude Code | Free ; Pro USD 20 ; Max USD 100 / 200 | Les multiplicateurs de session 5× / 20× de Max ne multiplient pas le travail livré. |
| Cursor / abonnement X actuel | Free ; Plus USD 8 ; Premium USD 30 ; Super USD 100 ; Ultra USD 200 | Usage hebdomadaire partagé ; les modèles tiers choisis directement sont facturés à part sur les niveaux concernés. |
| Ancien Cursor | Pro USD 20 ; Pro+ USD 60 ; Ultra USD 200 | Deux réserves mensuelles, pas l’actuel forfait hebdomadaire partagé. |
| Google AI | Free ; Plus USD 4,99 ; Pro USD 19,99 ; Ultra USD 99,99 / 199,99 | Usage de Gemini, crédits Flow et services pour développeurs obéissent à des conditions distinctes. |
Sources des prix : les pages officielles des abonnements et la documentation des droits.891061112
Trois détails montrent pourquoi le nom de la formule ne suffit pas.
D’abord, les abonnés OpenAI Pro 200 existants qui font partie de la cohorte concernée conservent leur ancien quota jusqu’au 29 octobre 2026. Les nouveaux comptes hors de cette cohorte peuvent recevoir un autre quota au même prix. Le mode Fast consomme la capacité incluse 2,5 fois plus vite que le mode Standard ; Ultrafast, là où il existe, huit fois plus vite. Ce sont des facteurs de consommation, pas des promesses d’un gain de vitesse équivalent.38
Ensuite, les chiffres 5× et 20× de Claude Max portent sur le quota d’une session de cinq heures, comparé à Pro. Les plafonds hebdomadaires partagés continuent de s’appliquer. Multiplier par vingt un vieux décompte anecdotique de requêtes et présenter le résultat comme un droit mensuel contractuel serait faux.94
Enfin, un ancien Cursor Ultra et un Ultra actuel peuvent tous deux coûter USD 200 sans acheter la même chose. L’ancien garde des réserves séparées pour les modèles Cursor et pour les autres ; le nouveau partage une réserve hebdomadaire avec l’usage de Grok. Migrer change la facturation, y compris la couverture des modèles tiers.56
Avant de comparer deux tests d’une même formule, demandez-vous si les deux testeurs ont vraiment acheté la même chose.
2. Un cadeau ne vaut que s’il remplace une facture
Les promotions peuvent changer sensiblement le calcul. Elles peuvent aussi fausser une comparaison ordinaire.
Claude Max offre actuellement des crédits API mensuels de USD 100 ou USD 200 selon le niveau. Les nouveaux abonnés doivent avoir sept jours d’abonnement, et l’organisation Console concernée doit être liée. Les crédits non utilisés expirent. Ils ne paient pas les dépassements dans Claude Code en mode interactif ni dans l’application Claude ; l’usage API admissible et les traitements sans interface correctement authentifiés passent par une autre voie de facturation.13
Pour qui achèterait de toute façon cet usage API, c’est une vraie valeur. Pour qui n’utilise que Claude Code en interactif, compter la valeur faciale du crédit comme un remboursement de l’abonnement, c’est tenir une comptabilité fausse.
Les remises à zéro mises en réserve chez OpenAI sont des avantages promotionnels conditionnels, pas une dotation mensuelle permanente. Utiliser une remise complète décale le calendrier hebdomadaire ; la remise prévue à l’origine n’arrive pas en plus. Les remises immédiates payantes sont des achats à part, dont la disponibilité et le prix dépendent du compte.1415
Une offre d’Anthropic d’une ampleur inhabituelle, pour la revue de code en entreprise, rend la distinction plus nette encore. Les organisations admissibles peuvent obtenir USD 10 000–50 000, à réclamer avant le 15 janvier 2027 et à utiliser dans une fenêtre de 30 jours. Ce n’est pas de l’argent API général. Plusieurs configurations sont exclues, dont certaines installations GitHub Enterprise Server, GitHub avec résidence des données et les dispositifs sans conservation des données. Une fois le crédit épuisé, la revue peut continuer, mais payante.16
Il y a aussi le calendrier. La promotion sur les artefacts de Claude a pris fin le 15 octobre à 23:59, heure du Pacifique, soit le 16 octobre à 08:59 en Suisse. Elle ne réduisait ni les plafonds hebdomadaires ni Claude Code. Cursor a fermé les nouvelles inscriptions à son ancienne offre étudiante le 25 juin 2026 ; les offres déjà activées courent jusqu’à leur propre échéance.1718
Un registre des promotions bien tenu distingue avantages inclus, offres conditionnelles, promotions échues et extensions payantes. Le calcul devrait montrer à la fois la dépense réelle et ce que coûterait la même charge de travail sans promotion.
Un crédit inutilisé est une option, pas une économie.
3. « Texte, images et code » ne suffit pas pour classer le travail
Il faut d’abord découper le travail. Ensuite seulement, on peut comparer les produits.
Une courte traduction, une note de recherche à jour et un document pour un conseil d’administration sont tous du « texte ». Ils échouent pourtant de façons différentes. Une traduction peut déplacer le sens sans bruit. Une recherche peut accrocher une vraie référence à une affirmation qu’elle ne soutient pas. Un document de conseil peut être élégamment écrit et omettre la décision que ses lecteurs doivent prendre.
En visuel, une image de concept n’est pas une retouche précise de produit. Une belle image isolée n’est pas une campagne cohérente de huit images. Un schéma qui paraît plausible n’est pas un dessin technique modifiable aux légendes justes.
En logiciel, une fonction bien délimitée n’est pas une fonctionnalité qui traverse l’interface, l’API, la base de données et le chemin de migration. Une revue de code n’est pas une faille corrigée. Une pull request fusionnée n’est pas un service rétabli.
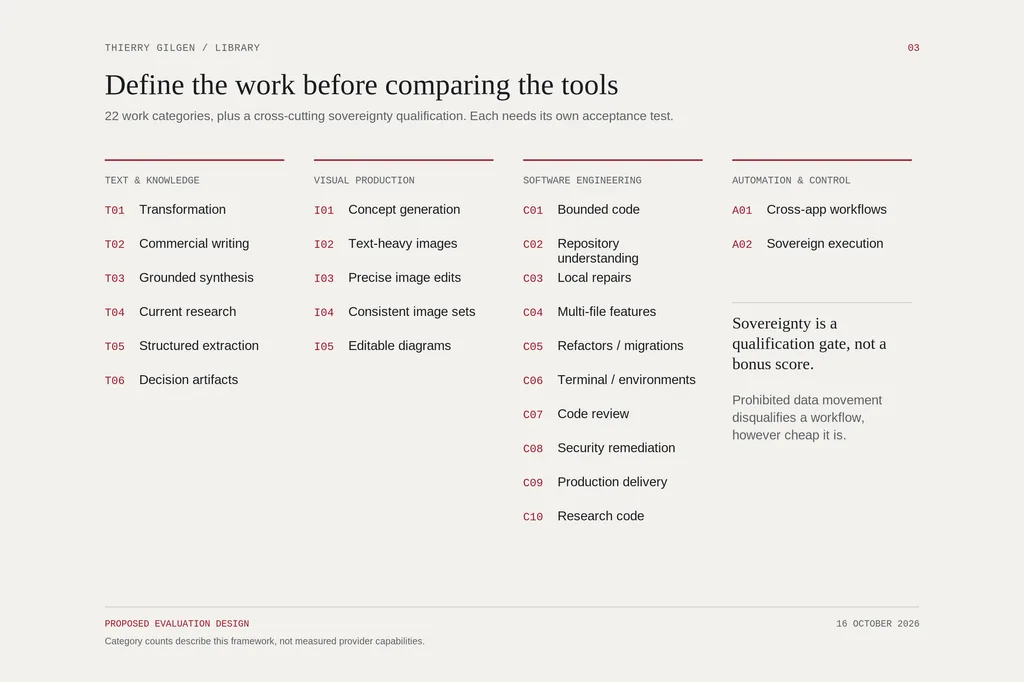
Ce volume retient donc 23 catégories d’évaluation. Vingt-deux décrivent des types de travail ; la vingt-troisième, l’exécution souveraine, est aussi une condition d’admissibilité qui traverse toutes les autres, et non une tâche de plus à fondre dans une moyenne.
| Famille | Catégories | L’acceptation doit établir |
|---|---|---|
| Écriture et travail intellectuel | Reformulation ; rédaction commerciale ; synthèse sourcée ; recherche d’actualité ; extraction ; documents de décision | Sens, preuves, champs, calculs et usage prévu sont corrects. |
| Production visuelle | Concepts ; compositions chargées de texte ; retouches précises ; séries cohérentes ; schémas modifiables | La commande réelle est remplie, y compris ce qui doit être préservé et rester cohérent. |
| Génie logiciel | Code délimité ; compréhension du dépôt ; réparation locale ; fonctionnalités sur plusieurs fichiers ; refonte/migration ; travail en terminal ; revue ; correction de failles ; mise en production ; code de recherche | Les tests, l’intégration, la vérification et les conditions d’exploitation pertinents tiennent. |
| Automatisation et contrôle | Enchaînements entre applications ; exécution souveraine | L’état final autorisé est atteint sans action ni flux de données interdits. |
Pour chaque catégorie, on fixe le test d’acceptation avant que l’agent commence. On le garde séparé du compte rendu que l’agent fait de sa propre performance. Et on exige la même norme de chaque candidat.
« Produis un correctif » appelle un correctif. « Corrige ce bogue, préserve ces comportements et prouve-le par un test de non-régression » décrit un travail que l’on peut juger.
Ce n’est pas de la bureaucratie ajoutée à la productivité. C’est ainsi que l’on sait si la productivité a eu lieu.
4. Programmation : modèle plus fort et travail moins cher sont deux questions
Le Coding Agent Index v1.5 d’Artificial Analysis offre une comparaison utile et explicitement bornée. Il couvre 113 tâches d’ingénierie sur dépôt, 66 tâches en terminal et 124 questions sur des dépôts, avec trois essais par tâche. L’indice composite fait la moyenne à parts égales des trois benchmarks. Ses coûts sont des moyennes au tarif API par essai noté, ni des frais d’abonnement ni des coûts de mise en production.19
La sélection ci-dessous réunit des configurations performantes et des niveaux d’effort contrastés. Ce n’est pas tout le classement, et de petits écarts de score ne prouvent pas des écarts de fiabilité.
| Agent et configuration | Indice | Tâches sur dépôt | Tâches en terminal | USD par essai | Minutes d’agent |
|---|---|---|---|---|---|
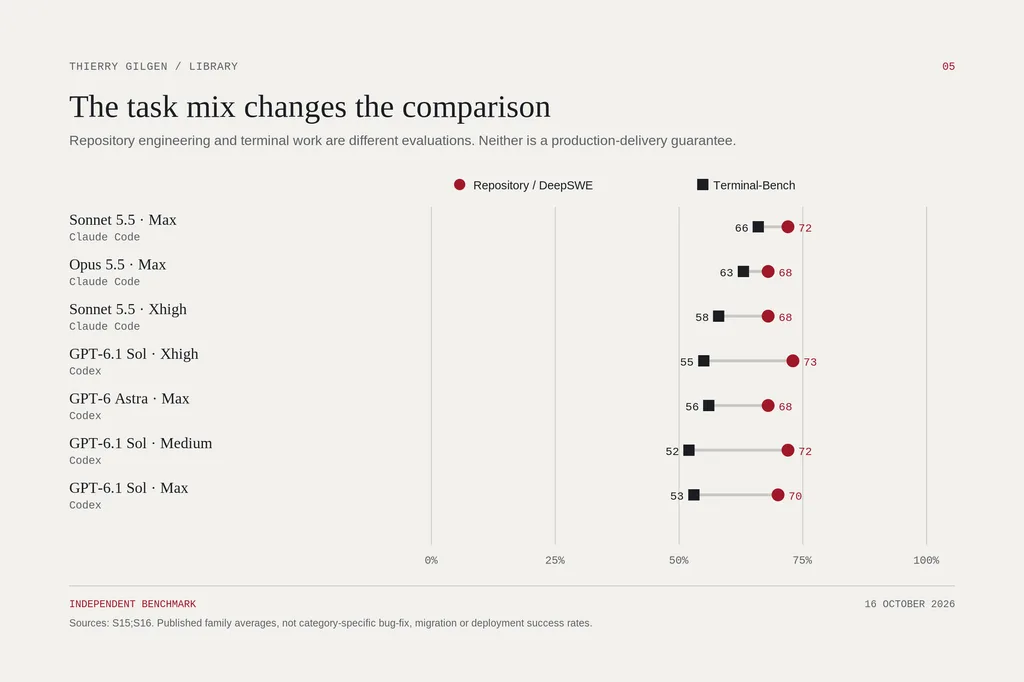
| Claude Code · Sonnet 5.5 Max | 68 | 72 % | 66 % | 14,19 | ≈90 |
| Claude Code · Opus 5.5 Max | 66 | 68 % | 63 % | 13,04 | ≈66 |
| Claude Code · Sonnet 5.5 Xhigh | 63 | 68 % | 58 % | 3,33 | 27,0 |
| Codex · GPT-6.1 Sol Xhigh | 63 | 73 % | 55 % | 1,04 | 15,5 |
| Codex · GPT-6 Astra Max | 62 | 68 % | 56 % | 7,47 | 29,4 |
| Codex · GPT-6.1 Sol Medium | 61 | 72 % | 52 % | 0,70 | 10,9 |
| Codex · GPT-6.1 Sol Max | 60 | 70 % | 53 % | 1,55 | 24,4 |
Ce sont les résultats arrondis publiés par l’évaluateur, pas des mesures faites pour ce texte. « Tâches sur dépôt » désigne DeepSWE v1.1 ; « tâches en terminal », Terminal-Bench 4.0.20
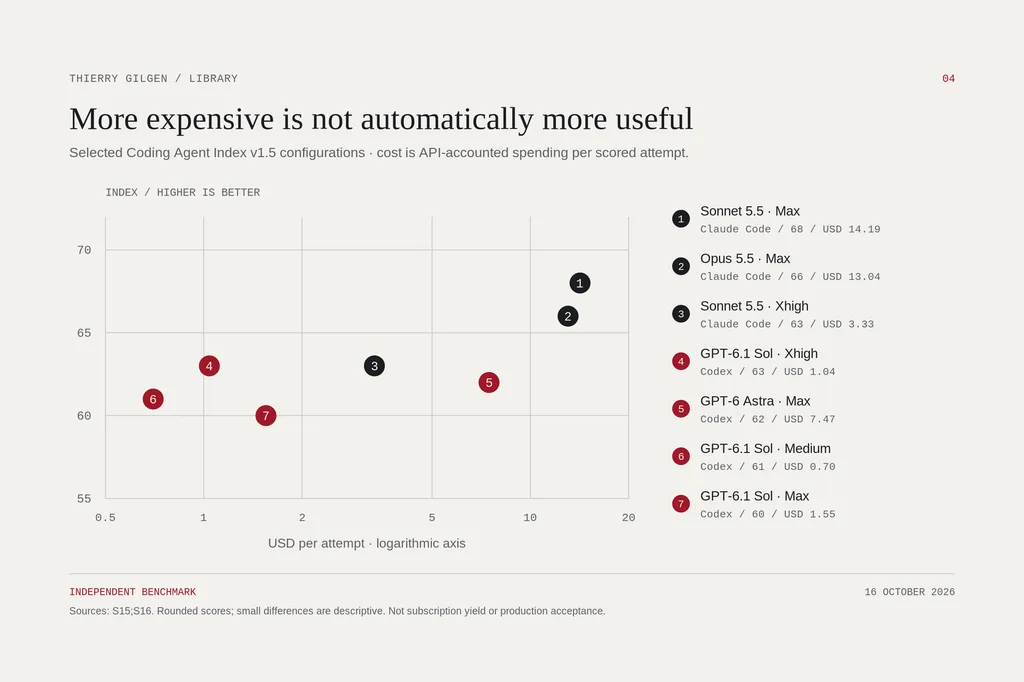
Ces résultats soutiennent deux hypothèses utiles pour un essai avant achat. Les réglages Sol modérés méritent d’être testés pour un travail sur dépôt économique. Les configurations Claude à effort élevé méritent d’être testées quand une meilleure tenue en terminal pourrait épargner assez de reprises pour justifier la dépense. Ils n’établissent pas que l’un des deux produits soit toujours meilleur.20
Remarquez ce que « Max » ne garantit pas. Dans cet instantané, Sol Medium obtient un score légèrement supérieur à Sol Max, pour moins cher et en moins de temps. Chez Sonnet, réduire nettement l’effort a aussi fait baisser le score. L’effort est un réglage à tester tâche par tâche, pas un label de qualité.20
Pour Cursor, la prudence s’impose. Cette recherche n’a pas obtenu de tableau de résultats complet, actuel et comparable pour Cursor CLI. Les anciens résultats de Composer reposent sur une série de tests antérieure et ne doivent pas être greffés sur la comparaison actuelle. Grok Build est un autre agent, pas une mesure de substitution pour Cursor.2122
Cette lacune n’est pas un verdict contre Cursor. L’intégration à l’éditeur, la gestion du contexte et la continuité du travail peuvent créer une valeur que le score d’un autre agent ne saisit pas. L’honnêteté consiste à mesurer ces avantages sur le vrai travail, pas à prêter à Cursor un chiffre emprunté.
La revue de code a, elle aussi, besoin de son propre dénominateur. Au lancement en mars, Anthropic estimait USD 15–25 par revue ; ce n’est pas un tarif fixe valable partout. La documentation actuelle décrit des coûts à l’usage et des déclencheurs qui peuvent produire plusieurs revues sur une même pull request. La revue hébergée analyse le code sans le compiler ni l’exécuter.2324
Comptez les défauts importants confirmés et l’effort humain de relecture, pas seulement les commentaires produits. Un relecteur qui invente trois inquiétudes pour chaque trouvaille utile peut occuper l’équipe sans rendre le logiciel plus sûr.
5. Écriture : un texte fluide n’est pas un travail intellectuel achevé
Des données crédibles montrent que l’assistance peut améliorer une écriture bien délimitée. Dans l’expérience de Noy et Zhang en 2023, 453 diplômés de l’enseignement supérieur ont reçu des tâches d’écriture professionnelle. L’étude rapporte 40 % de temps en moins et des notes de qualité supérieures de 18 %. Cela plaide pour l’utilité de la technologie dans le cadre testé ; cela ne classe pas les abonnements d’octobre 2026.2526
Pour les livrables professionnels d’aujourd’hui, GDPval-AA se rapproche davantage d’un vrai travail de bureau qu’un quiz de culture générale. Il couvre 220 tâches publiques, 44 métiers et neuf secteurs. Ses entrées actuelles Opus 5.5 Max et Sonnet 5.5 Max obtiennent respectivement 1866 et 1838 Elo, et l’évaluateur qualifie explicitement les deux configurations de Default Fallback. Ce sont des configurations outillées, évaluées par des comparaisons jugées par un modèle, ni des abonnements grand public ni des probabilités d’acceptation humaine.27
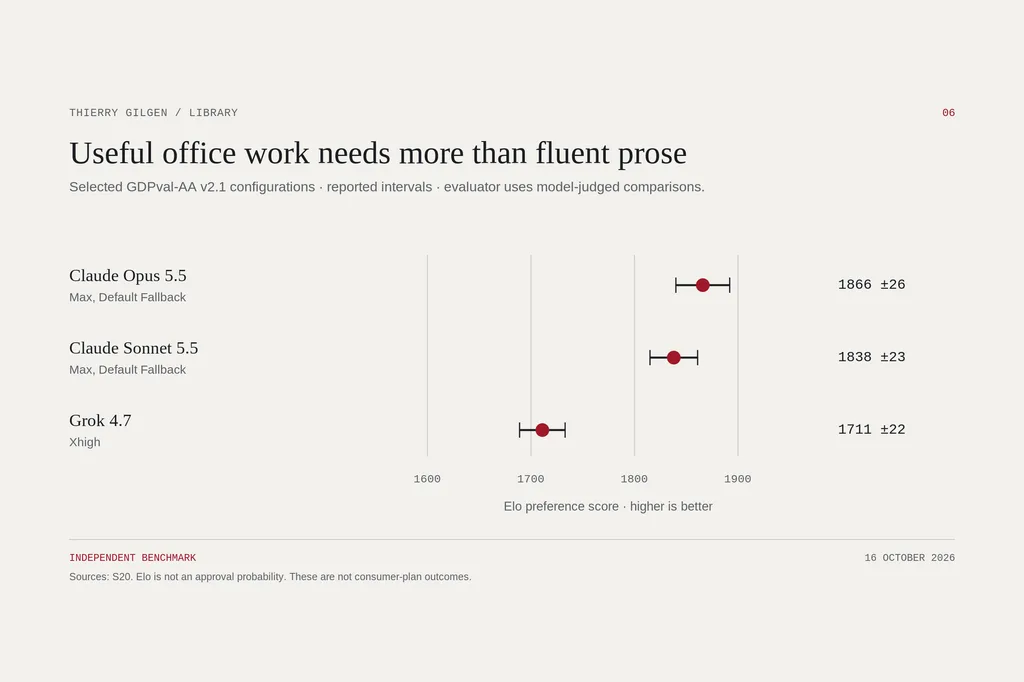
L’évaluation pratique doit rester plus près de la commande du client.
Pour une reformulation, on vérifie que le sens et la terminologie survivent, puis on note les minutes de retouche. Pour une note de recherche, on contrôle que les sources existent, qu’elles sont assez récentes et qu’elles soutiennent vraiment les affirmations. Pour une extraction, on compare les champs à un jeu de réponses connu. Pour un tableur, les formules doivent fonctionner et les totaux tomber juste.
Ne récompensez pas un assistant qui fabrique des mots en plus que quelqu’un d’autre devra vérifier. Et ne pénalisez pas un résultat concis et juste parce qu’un autre modèle a produit un document plus impressionnant à l’œil.
Le travail intellectuel échoue souvent à la frontière entre le plausible et le défendable. Cette frontière mérite son propre test d’acceptation.
6. Images : la génération n’est pas encore l’image dont on a besoin
L’image illustre assez clairement l’écart entre qualité du modèle et économie de la production.
Dans les résultats de préférence d’Artificial Analysis consultés, GPT Image 2.5 Sunburst Max obtient 1218 en création, Nano Banana 2.1 obtient 1172 et Grok Imagine Image 2.0 obtient 1165. Les intervalles à 95 % publiés sont de ±10, ±12 et ±13. La même page indique des prix API de référence équivalant à USD 0,2107, USD 0,0336 et USD 0,0600 par image générée.28
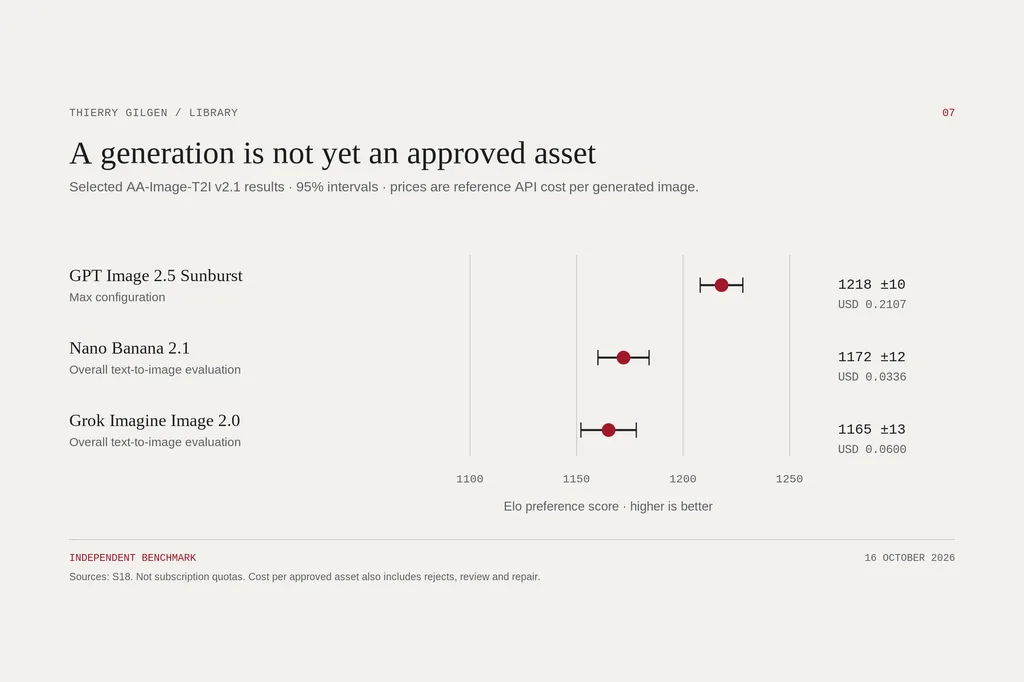
La retouche fait l’objet d’une évaluation distincte : Sunburst obtient 1199 ±11, Nano Banana 1152 ±13 et Grok 1117 ±13 dans l’instantané actualisé.29
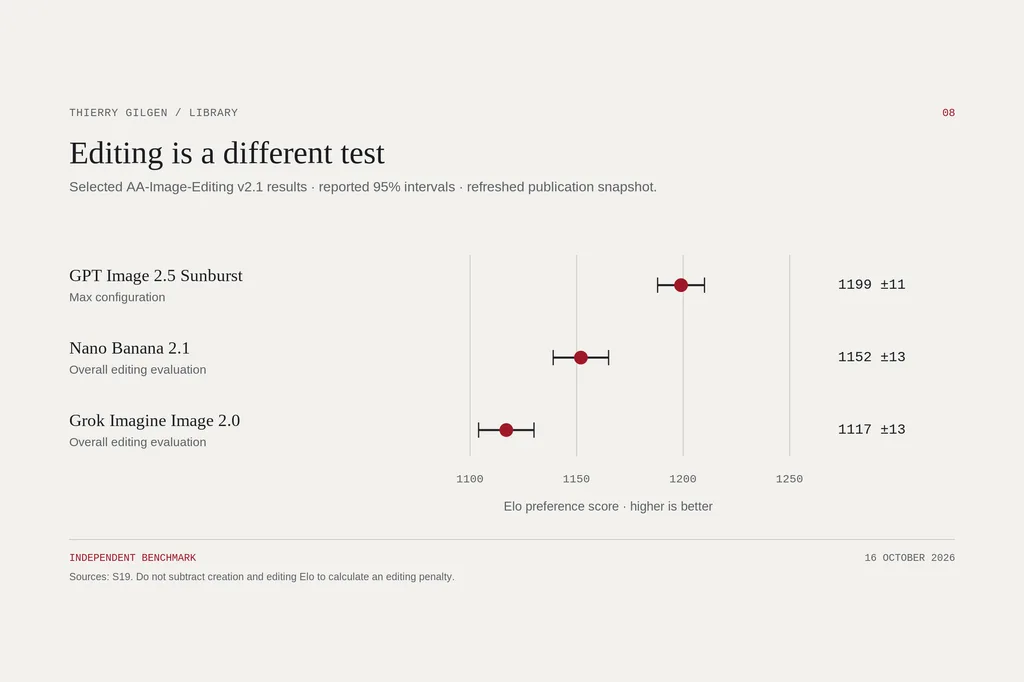
Ces résultats aident à repérer des candidats. Ils ne tranchent pas le choix de production. Le modèle le moins cher peut convenir pour explorer des idées. Le plus fort peut revenir moins cher au total quand une retouche exigeante coûterait sinon de nombreux essais et des reprises à la main. C’est une hypothèse sur le flux de travail, pas un résultat mesuré par le classement de préférence.
Pour une campagne, on compte la série cohérente. Pour une retouche de produit, on contrôle ce qui doit rester inchangé. Pour un schéma, on exige des légendes justes et un fichier source modifiable. Et on compte le coût des images rejetées, de la relecture, des retouches et des outils externes.
Claude peut aussi piloter des outils d’image externes par des intégrations. Cela ne crée pas de quota d’images propre dans l’abonnement Claude ; le service externe reste dans le calcul de l’accès et des coûts.30
L’unité, c’est l’image validée, pas l’image générée.
7. Pourquoi les études de productivité se contredisent
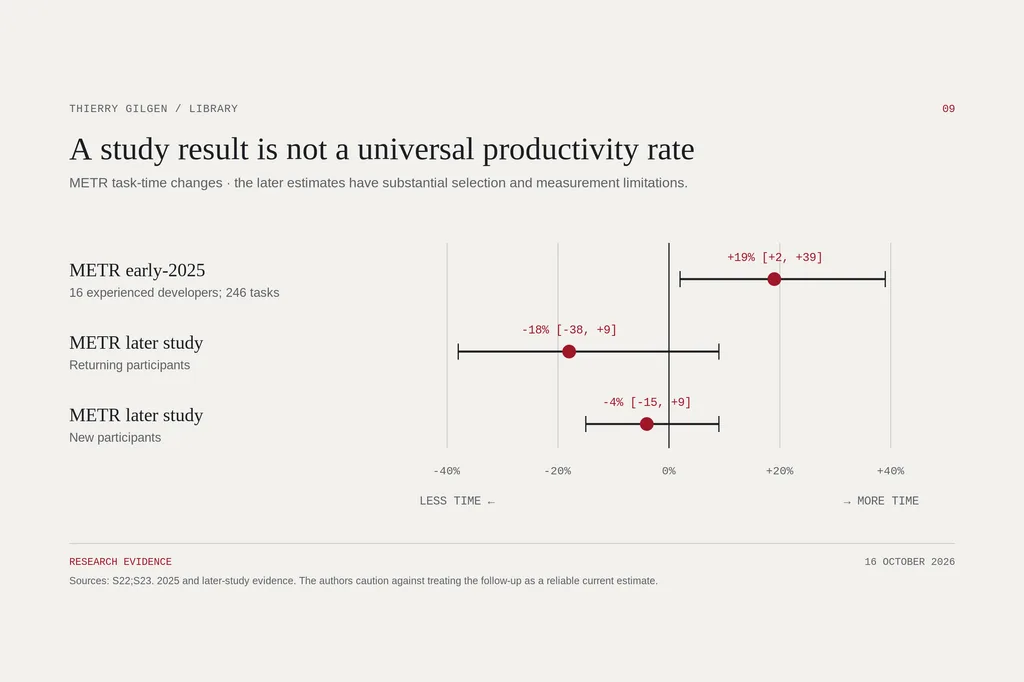
Une expérience bornée avec GitHub Copilot a fait état d’un achèvement 55,8 % plus rapide d’une tâche consistant à écrire un serveur HTTP en JavaScript. L’étude de METR du début de 2025 a trouvé autre chose : 16 développeurs expérimentés travaillant sur 246 tâches dans leurs propres dépôts ont mis 19 % plus de temps quand l’IA était autorisée.3132
Ce n’étaient ni les mêmes outils, ni les mêmes personnes, ni les mêmes tâches, ni les mêmes conditions d’acceptation. Ces chiffres ne sont pas deux estimations rivales d’une constante universelle de productivité de l’IA.
Le suivi publié par METR en février 2026 est particulièrement instructif. Il estime une réduction du temps de 18 % pour les participants revenus et de 4 % pour les nouveaux, mais les deux intervalles englobent zéro. Les auteurs décrivent aussi des effets de sélection et la difficulté de mesurer le travail d’agents menés en parallèle, ce qui rend ces résultats peu fiables comme estimation actuelle de la productivité.33
Une enquête distincte de METR auprès de 349 travailleurs techniques recense des bénéfices perçus, pas des gains de temps mesurés par rapport à une situation de référence. La synthèse d’observation publiée par DX elle-même fait état d’une hausse médiane de 7,76 % du nombre de pull requests ; ce débit n’équivaut pas à la valeur du logiciel, et une association observée n’est pas un effet causal universel.3435
Les témoignages de praticiens restent utiles. Ils révèlent des frictions qu’un benchmark ne voit pas : interruptions, limites qui changent, charge de relecture, intégrations ratées et factures inattendues. Mais les récits enthousiastes ou furieux sont des expériences sélectionnées. Sans définition de la tâche, registre des coûts, relevé des échecs ni norme d’acceptation, ils ne peuvent pas dire à un autre acheteur combien de travail un abonnement fournira.
La bonne question n’est pas : « L’IA donne-t-elle l’impression d’aller plus vite ? » C’est : « Où le temps est-il passé ? »
De la réalisation à la relecture ? De l’écriture à la vérification des faits ? De la génération de code à la remise en état de l’environnement ? Ou l’effort total a-t-il vraiment baissé, pour un résultat aussi bon ?
8. La souveraineté passe avant la comparaison des prix
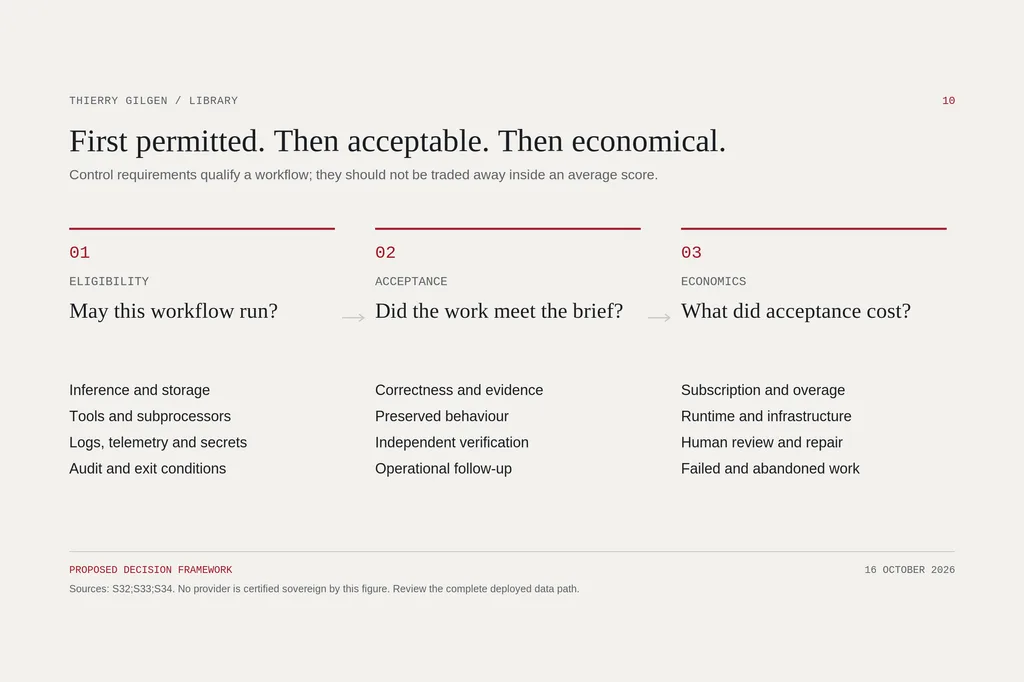
La question de la souveraineté décide d’abord quels flux de travail ont le droit d’être comparés.
Faire tourner un agent dans un terminal local ne prouve pas que l’inférence se fait en local. Cursor documente l’envoi des requêtes et du contexte de code à des fournisseurs de modèles ou d’inférence. Chez Claude, la conservation des données dépend du compte et du contrat. OpenAI distingue résidence des données et résidence de l’inférence.363738
Pas d’entraînement, pas de conservation, stockage régional et maîtrise de l’inférence sont des engagements différents. Un produit peut tenir l’un sans tenir l’autre.
Il faut cartographier tout le chemin : inférence, exécution des outils, livrables, journaux, télémétrie, sous-traitants, identifiants, accès d’audit et sortie. Une interface hébergée en local ne suffit pas si un outil connecté envoie en silence des contenus protégés ailleurs.
La promotion sur la revue de code en entreprise illustre le problème pratique : certaines configurations de maîtrise des données en sont exclues. Un gros quota que l’on ne peut pas utiliser dans les conditions requises n’a aucune valeur utilisable pour ce travail.16
Les systèmes auto-hébergés ont leur place dans la comparaison économique, mais pas à un coût fictif nul. On compte le matériel ou l’hébergement, le taux d’utilisation, l’électricité le cas échéant, la maintenance, l’exploitation de la sécurité et le support humain. Et on compte les mêmes échecs d’acceptation que pour un service cloud.
L’ordre devrait être simple : Le flux est-il autorisé ? Le résultat atteint-il la norme ? Combien coûte-t-il ? Un flux bon marché mais interdit ne devient pas acceptable parce qu’il gagne un score pondéré.
9. Le coût qui reste après l’acceptation
Deux calculs méritent d’être tenus côte à côte.
Le coût monétaire par résultat accepté additionne la part d’abonnement allouée, les dépassements ou frais API réels et les dépenses d’exécution, puis divise par le nombre de résultats acceptés.
Le coût complet par résultat accepté y ajoute le coût humain de la commande, de la relecture, des reprises et du suivi imputable après livraison, avant de diviser par le même dénominateur.
On retient une seule période comptable. Les essais ratés ou abandonnés comptent. Un abonnement partagé est réparti une fois, pas imputé en entier à chaque catégorie. Le travail humain se compte de la même façon avec et sans IA. Quand aucun résultat n’est accepté, on le dit, plutôt que d’afficher un zéro rassurant.
Voici un exemple délibérément hypothétique. Ce ne sont pas des résultats de fournisseurs.
| Un mois ; 40 résultats acceptés équivalents | Flux A | Flux B |
|---|---|---|
| Abonnement | USD 20 | USD 200 |
| Autres coûts monétaires | USD 120 | USD 80 |
| Effort humain | 24 heures | 9 heures |
| Taux horaire supposé | USD 60/heure | USD 60/heure |
| Coût complet | USD 1 580 | USD 820 |
| Coût par résultat accepté | USD 39,50 | USD 20,50 |
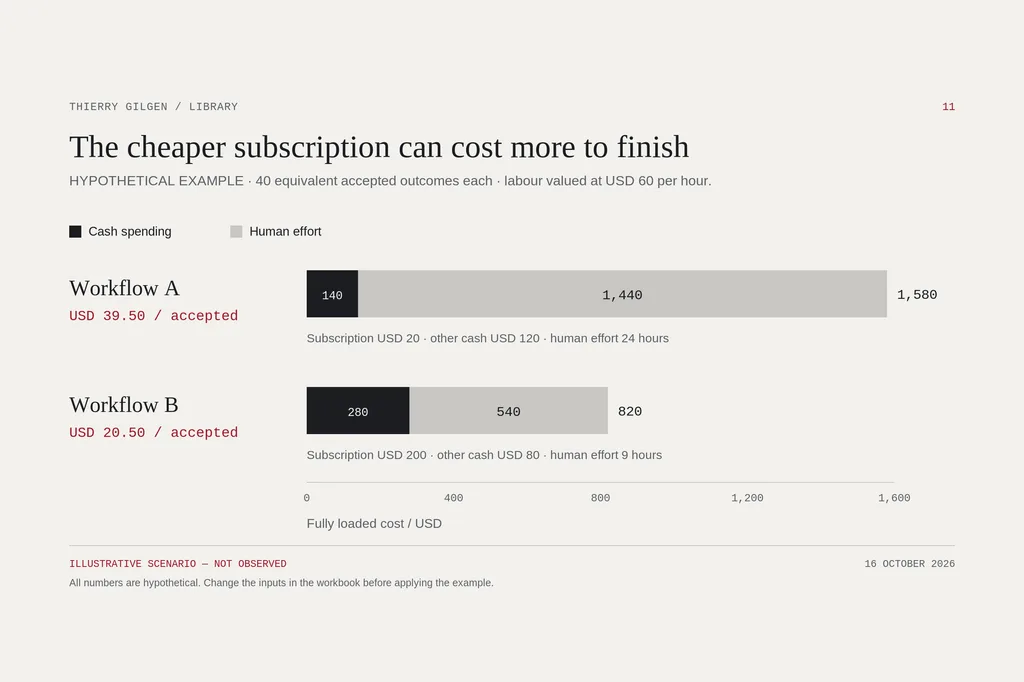
L’abonnement qui paraît cher sur la page des prix est le moins coûteux dans ce flux construit. Inversez la charge des reprises, et le résultat peut s’inverser.
Un travail accepté n’est pas pour autant un travail rentable. Une campagne peut respecter sa commande et échouer commercialement. Une fonctionnalité peut être juste et ne servir à personne. L’acceptation est un dénominateur opérationnel nécessaire, pas une créance sur le chiffre d’affaires. La valeur commerciale demande une mesure de résultat supplémentaire, adaptée à l’activité.
Il faut aussi séparer le temps écoulé du temps humain. Un agent qui travaille une heure pendant que son opératrice fait autre chose d’utile n’a pas consommé une heure de son travail. À l’inverse, un flux sans cesse interrompu peut imposer des coûts de coordination qu’aucune facture de jetons n’enregistre.
10. L’expérience qu’un acheteur peut vraiment mener
Les données publiques suffisent pour dresser une présélection. Elles ne suffisent pas pour publier un nombre audité de versions acceptées, d’images validées ou de notes de recherche défendables par abonnement.
Un plan de tri pratique pourrait réunir 30 tâches internes représentatives, trois flux candidats et deux essais indépendants : 180 essais. C’est un pilote proposé, pas un benchmark sectoriel doté d’une puissance statistique. Deux répétitions sont bien trop peu pour établir des probabilités d’échec fiables par tâche.
On choisit des tâches couvrant l’écriture, la recherche et les livrables, la production visuelle, le code délimité, l’ingénierie sur dépôt et le travail de mise en production ou d’exploitation. On gèle les entrées. On fixe l’acceptation avant le test. On tire au sort l’ordre d’exécution et, si possible, les relecteurs ignorent quel flux a produit quoi. On garde des versions de tâches séparées pour limiter l’apprentissage et les fuites de réponses.
Surtout, on mène deux comparaisons différentes. Un test du modèle et de l’agent fixe la tâche, les outils, le niveau d’effort et le budget, puis mesure qualité, coût et temps. Un test de l’abonnement observe le compte réellement acheté sur un cycle de facturation, avec plafonds partagés, remises à zéro, ralentissements, promotions et frais supplémentaires. L’un dit quelle configuration est efficace ; l’autre, ce que l’abonnement achète vraiment.
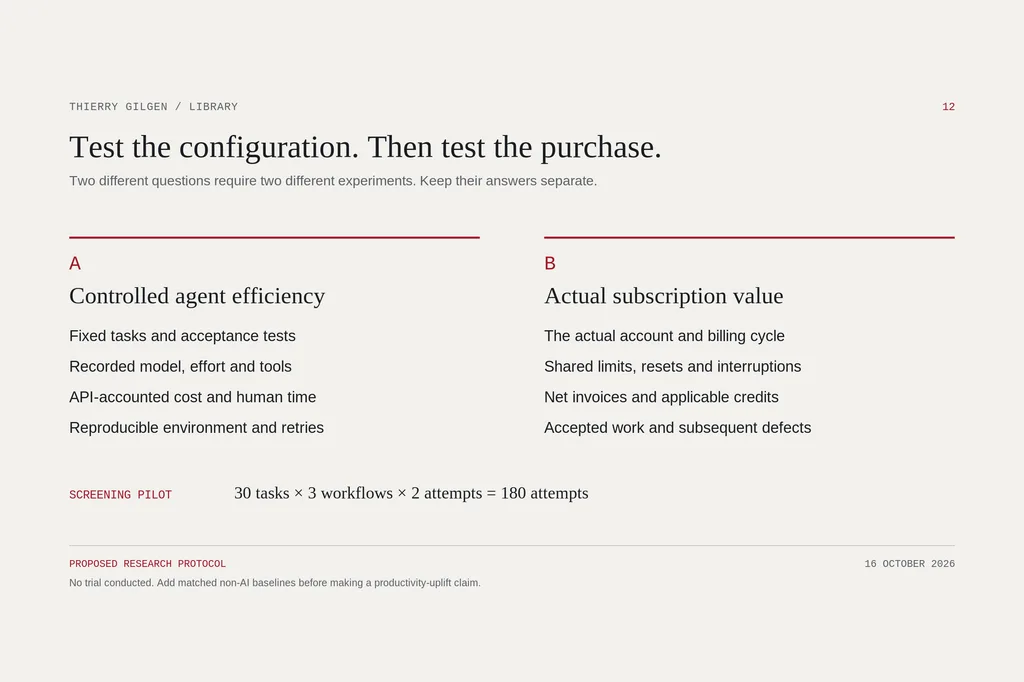
Si l’on veut affirmer un gain de productivité, il faut ajouter une référence comparable sans IA. Sinon, l’étude peut comparer des flux IA entre eux, mais pas établir de combien l’IA a fait mieux que l’alternative.
On relève l’acceptation au premier passage, l’acceptation après reprise plafonnée, les minutes humaines, le temps écoulé, le coût monétaire, le coût complet, les interventions et les défauts apparus ensuite. On consigne les échecs avec le même soin que les réussites. Un modèle qui supprime le test n’a pas réussi le test.
On fixe une règle d’arrêt avant de commencer. Un troisième essai doit avoir une raison : un élément nouveau, une autre configuration ou un environnement corrigé. Répéter une boucle stérile avec un quota plus grand n’est pas une stratégie d’optimisation. Des plafonds de budget stricts comptent justement parce que les agents peuvent continuer à consommer des ressources sans produire de résultat acceptable.3940
Le travail, pas le compteur
Le modèle le moins cher n’est pas toujours le flux le moins cher. La configuration la plus forte au benchmark n’est pas toujours le meilleur achat. Et l’abonnement au plus gros quota n’est pas forcément celui qui donne à son titulaire la capacité la plus utile.
La réponse dépend du travail, de la norme d’acceptation, des outils autour, de la personne aux commandes et des conditions dans lesquelles le système a le droit de tourner.
C’est moins commode qu’un classement universel. C’est aussi plus utile.
Ne commencez pas par demander quel fournisseur vous laissera consommer le plus d’intelligence. Commencez par définir ce qui doit être vrai quand le travail est fini. Cherchez ensuite le flux admissible le moins cher qui atteint cette norme de façon fiable.
La valeur de l’IA, ce n’est pas l’intelligence consommée. C’est le travail utile accepté, et la valeur qui demeure après l’acceptation.
Méthode et limites
Cette édition croise documentation des fournisseurs, résultats d’évaluateurs indépendants, études originales et données de terrain ou d’observation explicitement signalées. Elle ne rend compte d’aucun nouvel essai d’installation, test de charge d’abonnement ou expérience en production. Les droits officiels établissent un accès annoncé, pas des résultats livrés. Les benchmarks établissent une performance sur leurs propres tâches et selon leurs propres règles de calcul, pas le rendement d’un abonnement grand public.
Prix et classements ont été vérifiés pour cette édition datée. Les pages dynamiques peuvent changer ; les valeurs citées ici sont celles retenues à la date de consultation, avec leurs sources et leurs réserves. Les scores de retouche d’image ont été actualisés lors de la finalisation. Les noms de configuration des livrables professionnels gardent la mention de repli de l’évaluateur. Les données anciennes sont datées et ne sont pas présentées comme un verdict sur les modèles actuels.
Le champ porte sur ChatGPT/Codex, Claude/Claude Code et Cursor, complétés par Google et des données sur les modèles d’image quand c’est pertinent. Ce n’est pas un catalogue complet du marché. Vidéo, audio, offres régionales, contrats d’entreprise et alternatives auto-hébergées sortent du cadre de la comparaison chiffrée. Là où les données publiques ne fournissent ni dotation mensuelle universelle de jetons ni quota de travail achevé, aucun n’a été inventé.
L’exposé du début repose sur le souvenir de l’auteur, pas sur une transcription vérifiée de façon indépendante. Les entrées de sources distinguent cette provenance de la documentation publique. L’IA a aidé à la recherche, à la rédaction et à la production des figures. L’image d’ouverture est une illustration conceptuelle générée ; les figures de données sont tracées de façon déterministe à partir des données sources datées. Publié le 16 octobre 2026 avec l’accord de l’auteur.
Sources
Footnotes
-
Récit de l’auteur sur l’exposé du 15 octobre 2026, consigné dans la commande de recherche du 16 octobre. Aucune transcription indépendante consultée. Le texte mentionne une inspiration, pas une caution. ↩
-
botts.ai. About us: Yves Zumbühl. Consulté le 16 octobre 2026. Confirme seulement le nom et l’affiliation, ni l’exposé ni une adhésion à cet essai. ↩
-
OpenAI. Codex / Work pricing. Consulté le 16 octobre 2026. ↩ ↩2
-
Anthropic. Claude Code on Pro or Max. Consulté le 16 octobre 2026. ↩ ↩2
-
Cursor. Models and pricing. Consulté le 16 octobre 2026. ↩ ↩2
-
Cursor. Legacy Cursor plans. Consulté le 16 octobre 2026. ↩ ↩2 ↩3
-
Google. Gemini usage limits. Consulté le 16 octobre 2026. ↩
-
OpenAI. About ChatGPT Pro tiers. Consulté le 16 octobre 2026. ↩ ↩2
-
Anthropic. Claude pricing. Consulté le 16 octobre 2026. ↩ ↩2
-
Cursor. New X subscription pricing. Consulté le 16 octobre 2026. ↩
-
Google. AI subscriptions. Consulté le 16 octobre 2026. ↩
-
OpenAI. ChatGPT pricing. Consulté le 16 octobre 2026. ↩
-
Anthropic. Monthly API credits. Consulté le 16 octobre 2026. ↩
-
OpenAI. Banked Codex resets. Consulté le 16 octobre 2026. ↩
-
OpenAI. Paid weekly resets. Consulté le 16 octobre 2026. ↩
-
Anthropic. Enterprise Code Review promotional credits. Consulté le 16 octobre 2026. ↩ ↩2
-
Anthropic. Artifact promotion. Consulté le 16 octobre 2026. ↩
-
Cursor. Student discount. Consulté le 16 octobre 2026. ↩
-
Artificial Analysis. Coding Agent Index methodology v1.5. Consulté le 16 octobre 2026. ↩
-
Artificial Analysis. Claude Code versus Codex. Consulté le 16 octobre 2026. ↩ ↩2 ↩3
-
Artificial Analysis. Claude Code versus Grok Build. Consulté le 16 octobre 2026. ↩
-
Artificial Analysis. Cursor’s Composer 2.5: third on the Coding Agent Index and ~10–60x lower cost than rivals. Consulté le 16 octobre 2026. ↩
-
Anthropic. Code Review costs and usage. Consulté le 16 octobre 2026. ↩
-
Anthropic. Code Review launch. Consulté le 16 octobre 2026. ↩
-
Noy and Zhang / CEPR. Productivity effects of generative AI. Consulté le 16 octobre 2026. ↩
-
Noy and Zhang / Science. Experimental evidence on the productivity effects of generative artificial intelligence. Consulté le 16 octobre 2026. Étude originale ; vérifiée par le résumé indexé et le compte rendu des auteurs au CEPR, pas par le texte intégral de la revue. ↩
-
Artificial Analysis. GDPval-AA v2.1. Consulté le 16 octobre 2026. ↩
-
Artificial Analysis. Text-to-image v2.1. Consulté le 16 octobre 2026. ↩
-
Artificial Analysis. Image editing v2.1. Consulté le 16 octobre 2026. ↩
-
Hugging Face. Claude and MCP image generation. Consulté le 16 octobre 2026. ↩
-
Microsoft Research / Peng et al.. Impact of AI on developer productivity. Consulté le 16 octobre 2026. ↩
-
METR. Early-2025 experienced developer RCT. Consulté le 16 octobre 2026. ↩
-
METR. Experiment-design update. Consulté le 16 octobre 2026. ↩
-
METR. AI usage survey. Consulté le 16 octobre 2026. ↩
-
DX. AI coding pricing and ROI guide. Consulté le 16 octobre 2026. ↩
-
Cursor. Privacy and data governance. Consulté le 16 octobre 2026. ↩
-
Anthropic. Claude Code data usage. Consulté le 16 octobre 2026. ↩
-
OpenAI. Data and inference residency. Consulté le 16 octobre 2026. ↩
-
Simon Willison. Default hard budget caps. Consulté le 16 octobre 2026. ↩
-
Anthropic. Claude Code costs. Consulté le 16 octobre 2026. ↩