Neuf personnes, douze questions
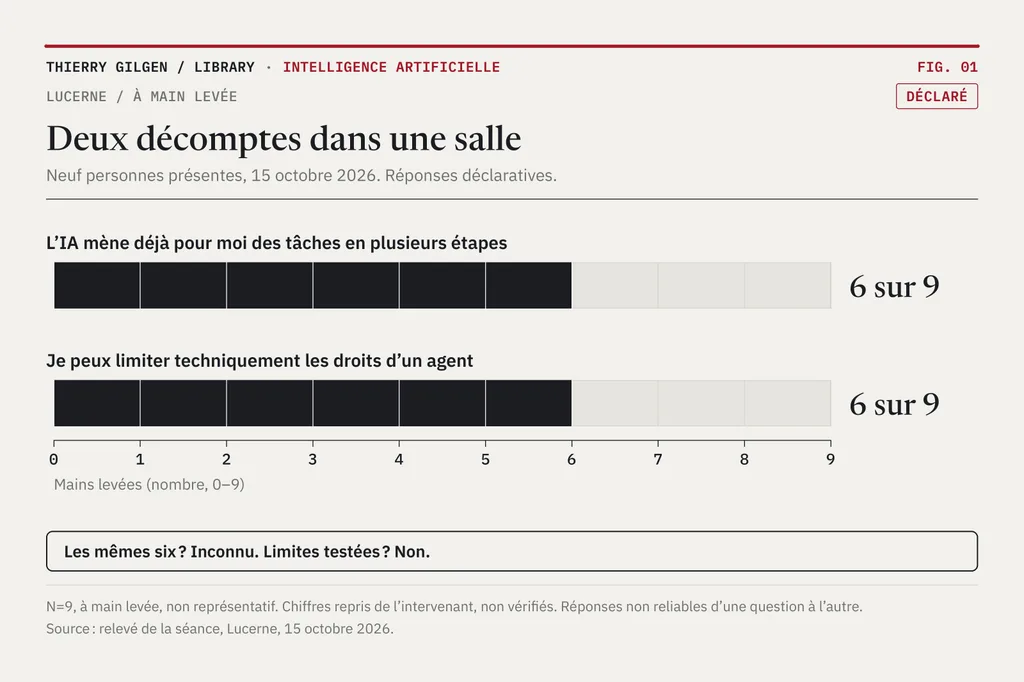
Le 15 octobre 2026, à Lucerne, neuf personnes réunies dans une salle ont répondu à douze questions en levant la main. Elles étaient venues à une petite séance de rédaction intitulée « AI-First. Mais pas à l’aveugle. » Toutes ont affaire à l’IA dans leur travail, d’une manière ou d’une autre. C’était tout l’échantillon. Pas d’institut de sondage, pas de baromètre du secteur. Neuf personnes dans une salle.
Six d’entre elles ont dit confier déjà à l’IA des tâches en plusieurs étapes, qu’elle mène seule. Six ont dit aussi pouvoir limiter techniquement les droits d’un agent d’IA, et pas seulement en lui demandant de s’abstenir. S’agissait-il des mêmes six ? Nous l’ignorons. Les chiffres sont repris tels que l’intervenant les a comptés dans la salle, et personne ne les a vérifiés. Quant aux limites techniques, nous n’en avons contrôlé aucune.
Il n’y a rien là à cacher. C’est même ici que commence la bonne question. Que veut dire contrôler, quand un logiciel ne se contente plus de répondre, mais agit ?
Le titre de ce volume vient de la salle. We Gave AI the Keys a été approuvé de vive voix, sans décompte des voix. Peut-être parce que l’image est si familière. On confie une clé à quelqu’un pour qu’un travail soit fait. À un agent, on remet parfois en même temps le passe-partout, en espérant qu’une consigne bien tournée suffira.
Du texte utile à l’acte accompli
Un chatbot qui propose un brouillon, c’est une chose. Un agent qui modifie des fichiers, envoie des messages, interroge une base de données ou prépare des changements dans un dépôt de code, c’en est une autre. Le premier produit surtout de l’information. Le second peut changer l’état d’un système. Une maladresse qui serait simplement gênante dans un brouillon peut avoir de vraies conséquences dans un processus doté de droits étendus.
L’incertitude ne loge pas dans le seul modèle de langage. Un agent passe par des interfaces, des outils, des jetons, des API et des validations humaines. Ce qu’il peut réellement faire découle de tout cet assemblage. Une phrase dans le prompt système, « Tu ne dois rien supprimer », n’offre pas la même garantie qu’un compte dont les droits ne comportent tout simplement aucune opération de suppression.
L’OWASP appelle ce risque Excessive Agency, un pouvoir d’agir excessif. Il apparaît par exemple quand un outil possède plus de fonctions que la tâche n’en demande, quand les droits vont trop loin ou quand des actions lourdes de conséquences peuvent s’exécuter sans contrôle effectif.1 La liste plus récente de l’OWASP consacrée aux applications agentiques range l’abus d’outils et l’abus d’identité et de privilèges parmi ses catégories propres.2 Ces listes classent des types de risques. Elles ne disent pas combien d’incidents réels se produisent.
Le texte d’un inconnu n’est pas un nouveau chef
Une autre faille s’ouvre là où l’agent lit. Un courriel, une page web ou un fichier peut contenir des données dont la tâche a vraiment besoin. Il peut aussi contenir des ordres que l’utilisateur réel n’a jamais donnés.
L’équipe de sécurité de Google DeepMind décrit ce phénomène comme une indirect prompt injection, terme que le billet de Google attribue lui-même à Greshake et à ses coauteurs : un attaquant glisse des instructions manipulatrices dans un contenu extérieur que le système traite au cours d’une tâche légitime.3 Greshake et ses coauteurs ont montré en 2023 que ces attaques fonctionnaient contre des applications réelles, et constaté l’absence de parades efficaces.4 Le modèle de menace publié par Google imagine un agent chargé de résumer un courriel et que le contenu même de ce courriel pourrait pousser à envoyer des informations confidentielles à une adresse étrangère. Cet exemple est un modèle de sécurité. Il ne prouve pas que tout agent puisse être compromis de cette façon. Le problème n’est pas réglé pour autant : dans un rapport ultérieur, Google DeepMind constate que des attaques adaptatives, qui évoluent avec la défense, ont rendu nettement moins efficaces des défenses de base qui semblaient tenir face à des tests figés.5
On voit alors où passe la frontière de la confiance. Le texte d’un courriel peut servir de matière à son résumé. Il ne doit pas acquérir le pouvoir d’envoyer d’autres données où que ce soit. Une architecture solide décide hors du modèle de langage quelle opération est permise, avec quelles données et pour quelle mission. Des identités limitées techniquement, des outils taillés au plus juste et un second contrôle des actions critiques pèsent donc plus lourd que l’assurance que l’agent sera prudent.
Qui tient la clé, et qui en répond ?
Il serait commode de laisser la responsabilité à l’agent. Mais confier le travail à un agent ne revient pas forcément à lui en confier la responsabilité. Quelqu’un doit délimiter la mission, accorder les accès, vérifier le résultat et pouvoir tout arrêter en cas de doute.
Le cadre de gestion des risques de l’IA du NIST, l’AI Risk Management Framework, répartit cette gestion en quatre fonctions : Govern, Map, Measure et Manage.6 Il n’impose aucune architecture technique particulière. Mais il garde en vue les questions décisives. Qui fixe les règles ? Quels risques sont plausibles dans cet usage précis ? Comment savoir si les protections fonctionnent ? Qui agit quand quelque chose tourne mal ?
Un document publié par Google en 2025 sur la sécurité des agents d’IA pose trois principes liés : des responsables humains bien définis, des pouvoirs limités, des actions et une planification que l’on peut observer.7 Tout tient à leur combinaison. La journalisation seule ne rend pas sûre une autorisation dangereuse. Un accès restreint ne dit pas, à lui seul, si le résultat est juste. Et une validation humaine donnée d’un simple clic ne protège guère mieux que pas de validation du tout.
On peut en tirer un modèle de contrôle praticable.
Le moins de droits possible. Un agent de recherche a d’ordinaire besoin de lire. Il n’a pas à réécrire ses sources ni à modifier des systèmes de production. Un agent de rédaction n’a pas d’office le droit de publier lui-même son travail.
Des limites à chaque exécution. Chaque tâche demande un périmètre défini, un budget de temps et de coût, et des règles pour les données sensibles. Les droits devraient être de courte durée et attachés au but précis.
Des résultats vérifiables. « Tâche terminée » ne vaut pas réception. Un processus devrait fixer d’avance ce qui doit être vérifié et quelles erreurs l’arrêtent.
Une validation indépendante. Les actions lourdes de conséquences, comme publier, payer, supprimer ou déployer en production, ne doivent pas avoir lieu au seul motif que le même agent les juge bonnes.
Un vrai arrêt. Un système doit pouvoir interrompre une action techniquement, et non prier poliment l’agent de s’arrêter.
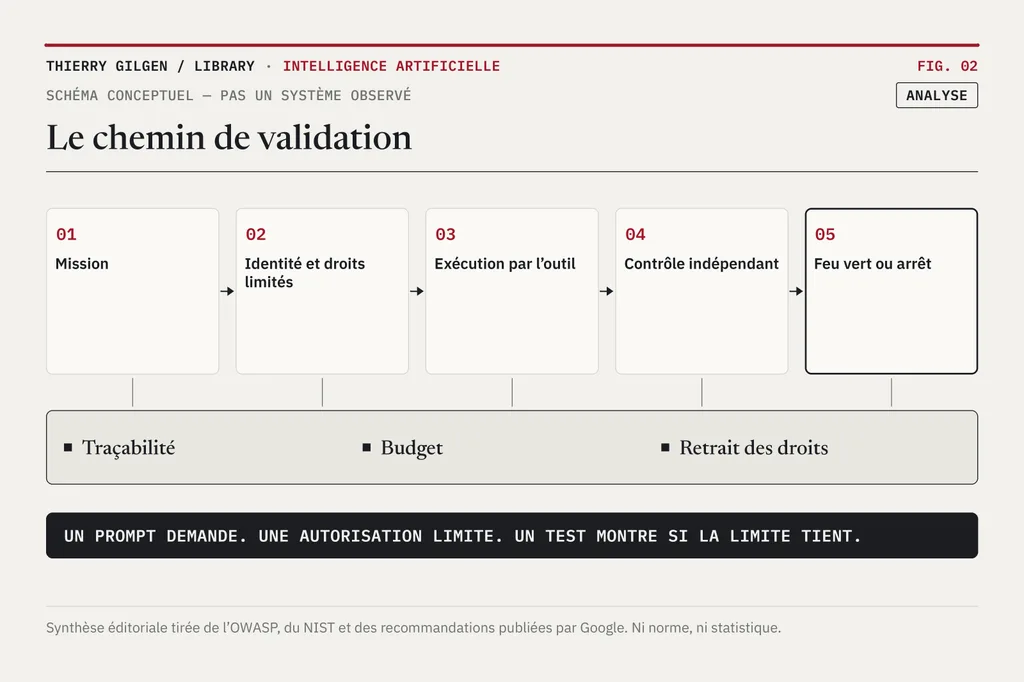
Ces cinq points sont notre propre synthèse éditoriale de la littérature sur la sécurité et la gestion des risques. Ils ne citent aucune norme mot pour mot.
L’objection la plus forte : trop de contrôle rend l’IA inutile
L’objection est légitime. Chaque validation supplémentaire ralentit le travail. Des droits trop étroits entraînent des questions sans fin, et un agent qui a besoin d’un humain à chaque étape n’automatise peut-être presque rien. Les logiciels ordinaires, eux aussi, tournent avec des comptes de service, des files d’attente et des tâches planifiées, sans que quiconque approuve chaque action.
Sur un point, l’objection a raison : toutes les actions ne méritent pas le même degré de contrôle. Une ébauche interne n’est pas un déploiement en production. Une requête dans une base de données n’est pas sa suppression. La réponse raisonnable n’est donc pas de rendre les agents incapables d’agir. Elle consiste à graduer droits et vérifications selon l’effet et le risque. Les tâches à faible risque peuvent tourner de façon largement autonome, tandis que les frontières critiques restent protégées, techniquement et dans l’organisation.
Ce modèle ne suffit pas pour autant. Les droits peuvent être mal configurés. Les chaînes de validation peuvent être contournées. Les agents peuvent combiner des outils d’une manière que personne n’avait prévue. Et la validation humaine s’use. À qui l’on demande de confirmer une action de routine après l’autre finit par confirmer par habitude, et l’on se fie vite à un système qui a souvent eu raison. La validation devient alors un tampon : elle figure toujours sur le schéma, mais ne vérifie plus rien. Raison de plus pour la réserver aux rares actions qui l’exigent vraiment. Les équipes doivent donc tester non seulement les chemins permis, mais surtout les chemins interdits. L’agent de recherche est-il vraiment incapable d’écrire ? Un document extérieur ne peut-il vraiment pas l’amener à livrer des données ? L’arrêt fonctionne-t-il quand le budget est épuisé ? Une règle de sécurité dont personne n’a éprouvé l’application n’est, pour l’instant, qu’une affirmation.
Là où la responsabilité nous revient
Les mains levées à Lucerne n’ont rien mesuré de la sécurité du secteur de l’IA. Elles ont pourtant mis au jour une question que chaque équipe devrait se poser avant de confier davantage à ses agents : quand nous leur donnons des clés, savons-nous exactement quelles portes elles ouvrent ?
Travail autonome et travail sans contrôle ne sont pas la même chose. Un bon système d’agents ne vaut pas parce que plus personne ne regarde, mais parce que les gens font moins de routine tout en sachant qui décide de ce qui est permis, et quand il faut s’arrêter.
Un prompt demande. Une autorisation limite. Un test montre si la limite tient.
Méthode et limites
Les chiffres proviennent d’une seule séance en direct, à Lucerne, en Suisse, le 15 octobre 2026, avec neuf personnes présentes dont le travail, selon la description de l’événement, touche à l’IA. Ce n’était pas un échantillon aléatoire. Douze questions ont été posées l’une après l’autre et une main levée valait oui ; tout le reste peut signifier non, indécis, abstention ou main passée inaperçue. C’est l’intervenant qui a compté ; les chiffres sont repris de lui et n’ont pas été vérifiés de façon indépendante. Les réponses ne peuvent pas être reliées d’une question à l’autre : nous ne savons donc pas si les six de l’une sont les six de l’autre. Toutes les réponses sont déclaratives ; aucun contrôle technique n’a été testé. Neuf voix dans une salle ne permettent aucune généralisation à Lucerne, aux entreprises, aux métiers ou au secteur de l’IA. Aucune photo des participants n’a été prise pour ce volume.
La plupart des sources de sécurité citées ici viennent de Google, qui décrit ses propres systèmes et ses propres recherches ; l’OWASP, le NIST et l’étude universitaire de Greshake et de ses coauteurs font contrepoids de manière indépendante. Le profil du NIST consacré à l’IA générative n’a servi que d’arrière-plan.8 Ces sources décrivent des types de risques et des façons de les gérer. Aucune ne donne de fréquence d’incidents ou de dommages, et ce volume n’en donne pas non plus.
Sources
Footnotes
-
OWASP Gen AI Security Project, 2025. LLM06:2025 Excessive Agency. Fonctions, droits et autonomie excessifs, avec les mesures d’atténuation. Une typologie des risques, pas une mesure de la fréquence des incidents. ↩
-
OWASP Gen AI Security Project, 9 décembre 2025. OWASP Top 10 for Agentic Applications. Cite notamment le détournement d’objectif, l’abus d’outils et l’abus d’identité et de privilèges. Une typologie, sans chiffres de fréquence. ↩
-
Agentic AI Security Team, Google DeepMind, janvier 2025. How we estimate the risk from prompt injection attacks on AI systems. Modèle de menace avec un agent qui résume des courriels et un message piégé ; attribue le terme indirect prompt injection à Greshake et al. Présentation du fournisseur lui-même. ↩
-
Kai Greshake, Sahar Abdelnabi, Shailesh Mishra, Christoph Endres, Thorsten Holz, Mario Fritz, arXiv:2302.12173, février 2023 (v2 mai 2023). Not what you’ve signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. Étude universitaire indépendante : indirect prompt injection démontrée sur des systèmes réels ; le résumé constate l’absence de parades efficaces. Instantané de 2023, pas une mesure actuelle de fréquence. ↩
-
Google DeepMind, 20 mai 2025. Advancing Gemini’s security safeguards. Défense en profondeur et tests face à des attaques adaptatives ; indique que des défenses de base étaient nettement moins efficaces face à ces attaques. Rapport du fournisseur sur ses propres modèles. ↩
-
NIST, 26 janvier 2023. AI Risk Management Framework 1.0, Core. Les quatre fonctions Govern, Map, Measure et Manage. Un cadre volontaire, ni obligation légale ni certification. ↩
-
Santiago Díaz, Christoph Kern, Kara Olive, Google, 2025. An Introduction to Google’s Approach for Secure AI Agents. Trois principes : des responsables humains bien définis, des pouvoirs limités, des actions et une planification observables. Cadre du fournisseur lui-même. ↩
-
NIST, 26 juillet 2024 (NIST AI 600-1). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Simple arrière-plan ; aucun chiffre d’incident n’en est tiré. ↩