Die Frage nach dem Vortrag
Am 15. Oktober 2026 hörte ich Yves Zumbühl von botts.ai über souveräne Lösungsentwicklung sprechen. Danach liess mich eine ganz gewöhnliche Einkaufsfrage nicht mehr los: Was bekommen wir eigentlich für das Geld, das wir für KI ausgeben? Der Vortrag hat diese Recherche angestossen. Analyse und Schlüsse sind meine eigenen; sie sind weder ein Zitat noch eine Empfehlung von Yves.12
Abos lassen sich vergleichen. Tokens lassen sich zählen. Man kann über Kontextfenster reden, über Resets, Modellfamilien und Denkstufen. Wer die Werkzeuge bedient, braucht all diese Details.
Gekauft hat die Kundin aber etwas anderes.
Sie braucht ein Dokument, das sie verschicken kann. Ein Bild, das sie verwenden darf. Ein Problem, das gelöst ist. Eine Funktion, die in der bestehenden Anwendung läuft. Ein Release, das den Betrieb übersteht.
Eine Maschine kann sehr beschäftigt sein, ohne dass eines dieser Ergebnisse näher rückt.
Das ist kein Argument gegen KI. Es ist ein Argument dafür, ihren Wert ernst genug zu nehmen, um das Richtige zu messen. Ein billiges Abo, das unfertige Arbeit immer wieder an einen Menschen zurückreicht, kann teuer werden. Ein teures Modell, das einer Fachperson eine Stunde Nacharbeit erspart, kann sein Geld mehr als wert sein. Keiner dieser Schlüsse folgt aus der Grösse des Kontingents.
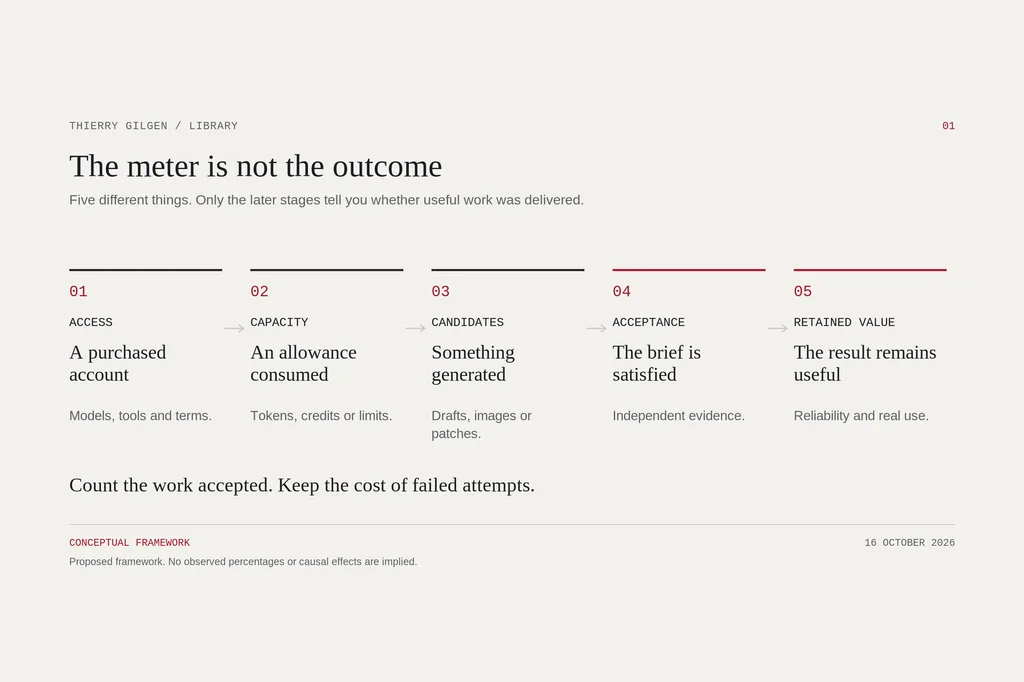
Die Einheit, die zählt, ist abgenommene Arbeit, unter genannten Bedingungen, zu bekannten Gesamtkosten.
Was dieser Band festhält
Abo-Kontingente, API-Preise und Benchmark-Werte beschreiben verschiedene Käufe. Man darf sie nicht zu einer erfundenen Zahl «erledigter Aufgaben pro Monat» verrechnen. Öffentliche Belege helfen bei der Wahl dessen, was man testen sollte. Ein Abo, das überall überlegen wäre, zeigen sie nicht. Was fehlt, ist die Messung des ganzen Wegs vom Auftrag bis zur Abnahme und, wo es darauf ankommt, der Verlässlichkeit der Arbeit danach.
1. Vier Käufe in einem Abo
Ein KI-Abo bündelt mindestens vier Dinge: Zugang zu Modellen, Software, mit der diese Modelle arbeiten können, ein Kontingent für die Nutzung und Bedingungen für Daten und Verwaltung.
Das Modell ist nicht das ganze Produkt. Ein Coding-Agent braucht auch den Kontext des Repositorys, funktionierende Werkzeuge, brauchbare Anweisungen und eine verlässliche Ausführungsumgebung. Ein Assistent, der eine Tabelle erstellt, braucht mehr als flüssiges Denken. Die Datei muss sich öffnen lassen, die Formeln müssen aufgehen, und wer sie bekommt, muss sie verstehen.
Auch das Kontingent ist keine gemeinsame Einheit. Claude beschreibt Sitzungsmultiplikatoren neben wöchentlichen Grenzen. OpenAI veröffentlicht modellabhängige Schätzungen. Die aktuellen Cursor-Abos legen die Nutzung über mehrere Produkte zusammen, ältere Konten behalten eine andere Struktur. Googles Modelllimiten und Kreativ-Credits lassen sich nicht gegeneinander tauschen.34567
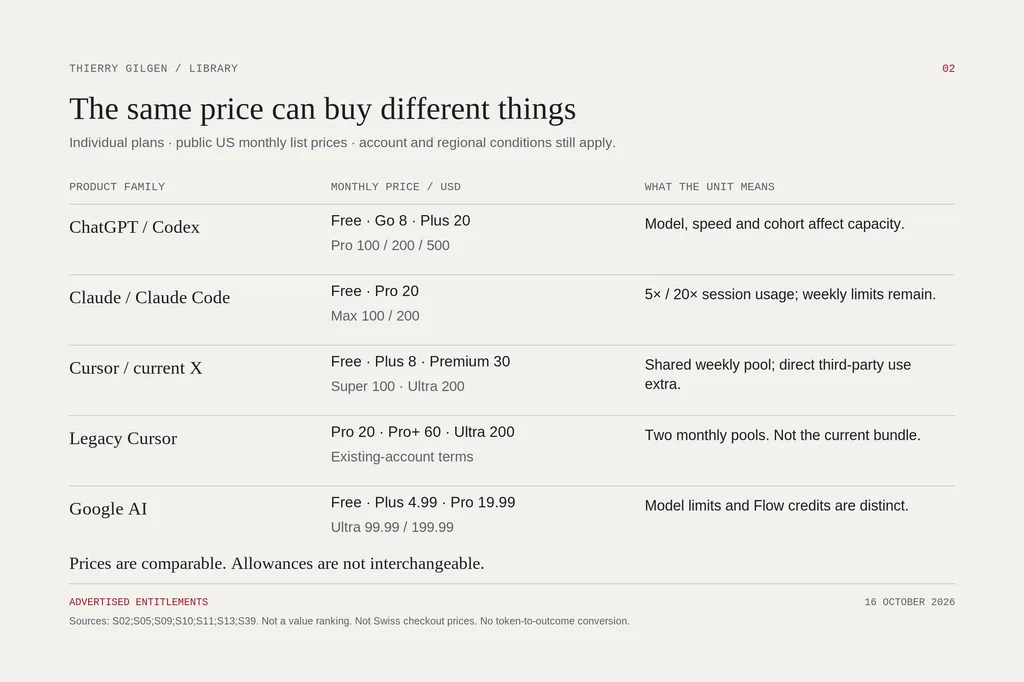
So sahen die Preise für Einzelabos zum Stichtag dieser Ausgabe aus. Es sind öffentliche US-Listenpreise, keine Schweizer Endpreise. Steuern, Bezahlweg, Region und Kontogeschichte können verändern, was jemand tatsächlich bezahlt.
| Produktfamilie | Öffentliche Monatspreise | Was man auseinanderhalten muss |
|---|---|---|
| ChatGPT / Codex | Free; Go USD 8; Plus USD 20; Pro USD 100 / 200 / 500 | Abo, Modell, Geschwindigkeitsmodus und Kontokohorte bestimmen die nutzbare Kapazität. |
| Claude / Claude Code | Free; Pro USD 20; Max USD 100 / 200 | Die Sitzungsmultiplikatoren 5× / 20× von Max vervielfachen nicht die gelieferte Arbeit. |
| Cursor / aktuelles X-Abo | Free; Plus USD 8; Premium USD 30; Super USD 100; Ultra USD 200 | Gemeinsames Wochenkontingent; direkt gewählte Fremdmodelle werden auf berechtigten Stufen separat verrechnet. |
| Cursor (Altabo) | Pro USD 20; Pro+ USD 60; Ultra USD 200 | Zwei monatliche Kontingente, nicht das heutige gemeinsame Wochenpaket. |
| Google AI | Free; Plus USD 4.99; Pro USD 19.99; Ultra USD 99.99 / 199.99 | Gemini-Nutzung, Flow-Credits und Entwicklerdienste haben je eigene Bedingungen. |
Preisquellen: die offiziellen Abo-Seiten und die Dokumentation zu den Leistungen.891061112
Drei Einzelheiten zeigen, warum der Name des Abos nicht genügt.
Erstens behalten bestehende OpenAI-Kunden mit Pro 200, die zur berechtigten Kohorte gehören, ihr bisheriges Kontingent bis zum 29. Oktober 2026. Neue Konten ausserhalb dieser Kohorte können zum gleichen Preis ein anderes bekommen. Der Fast-Modus verbraucht die enthaltene Kapazität 2.5-mal so schnell wie Standard, Ultrafast, wo unterstützt, achtmal so schnell. Das sind Verbrauchsfaktoren. Gleich viel Tempo versprechen sie nicht.38
Zweitens beziehen sich die Angaben 5× und 20× bei Claude Max auf das Kontingent einer fünfstündigen Sitzung im Vergleich zu Pro. Die gemeinsamen Wochengrenzen gelten weiter. Wer eine alte, anekdotische Zahl von Prompts mal zwanzig nimmt und das Ergebnis als vertragliches Monatskontingent ausgibt, rechnet falsch.94
Drittens können ein altes und ein aktuelles Cursor Ultra beide USD 200 kosten und doch Verschiedenes enthalten. Das alte behält getrennte Töpfe für Cursor-Modelle und andere Modelle. Das neue teilt einen Wochentopf mit der Nutzung von Grok. Wer wechselt, ändert die Abrechnung, auch für Fremdmodelle.56
Bevor man zwei Testberichte zum selben Abo vergleicht, lohnt die Frage, ob beide wirklich dasselbe gekauft haben.
2. Ein Geschenk ist nur etwas wert, wenn es eine Rechnung ersetzt
Aktionen können die Rechnung spürbar verändern. Sie können einen gewöhnlichen Vergleich aber auch irreführend machen.
Claude Max bietet derzeit monatliche API-Credits von USD 100 oder USD 200, je nach Stufe. Neue Abonnenten müssen sieben Tage im Abo sein, und die zugehörige Console-Organisation muss verknüpft werden. Nicht genutzte Credits verfallen. Sie bezahlen keine Mehrnutzung im interaktiven Claude Code oder in der Claude-App. Berechtigte API-Nutzung und korrekt authentifizierte Abläufe ohne Oberfläche laufen über einen anderen Abrechnungsweg.13
Wer diese API-Nutzung sonst ohnehin kaufen würde, gewinnt echten Wert. Wer nur interaktiv mit Claude Code arbeitet und den Nennwert der Credits als Rabatt aufs Abo verbucht, führt falsch Buch.
Die angesparten Resets von OpenAI sind an Bedingungen geknüpfte Aktionsleistungen, keine feste monatliche Zuteilung. Wer einen vollen Reset einlöst, verschiebt den wöchentlichen Rhythmus; der ursprünglich geplante Reset kommt nicht zusätzlich. Bezahlte Sofort-Resets sind eigene Käufe, deren Verfügbarkeit und Preis vom Konto abhängen.1415
Ein ungewöhnlich grosses Angebot von Anthropic für Code Review im Unternehmen macht den Unterschied noch deutlicher. Berechtigte Organisationen können USD 10 000–50 000 beanspruchen, mit Frist bis zum 15. Januar 2027 und einem Nutzungsfenster von 30 Tagen. Allgemeines API-Geld ist das nicht. Mehrere Konfigurationen sind ausgeschlossen, darunter bestimmte Installationen von GitHub Enterprise Server, GitHub mit Datenresidenz und Vereinbarungen ohne Datenspeicherung. Nach Ablauf der Credits kann die Prüfung kostenpflichtig weiterlaufen.16
Dazu kommt der Kalender. Die Artefakt-Aktion von Claude endete am 15. Oktober um 23:59 Uhr pazifischer Zeit, in der Schweiz am 16. Oktober um 08:59 Uhr. Wochengrenzen und Claude Code waren nicht vergünstigt. Cursor nahm ab dem 25. Juni 2026 keine neuen Anmeldungen für das alte Studentenangebot mehr an; bestehende Einlösungen laufen bis zu ihrem eigenen Ablaufdatum.1718
Ein sauberes Aktionsverzeichnis trennt enthaltene Leistungen, bedingte Angebote, abgelaufene Aktionen und bezahlte Erweiterungen. Die Rechnung sollte beides zeigen: was tatsächlich bezahlt wird und was dieselbe Arbeitslast ohne Aktion kosten würde.
Ein ungenutzter Credit ist eine Option, keine Ersparnis.
3. «Text, Bilder und Code» taugt nicht als Einteilung der Arbeit
Erst muss man die Arbeit auseinandernehmen, dann kann man die Produkte vergleichen.
Eine kurze Übersetzung, ein aktuelles Recherchedossier und eine Vorlage für den Verwaltungsrat sind alle «Text». Sie scheitern aber auf verschiedene Weise. Eine Übersetzung verschiebt still den Sinn. Eine Recherche hängt ein echtes Zitat an eine Aussage, die es nicht stützt. Eine Vorlage ist elegant geschrieben und lässt die Entscheidung weg, die der Rat treffen muss.
Bei Bildern ist ein Konzeptbild keine präzise Produktretusche. Ein schönes Einzelbild ist keine stimmige Kampagne aus acht Bildern. Ein Diagramm, das plausibel aussieht, ist keine bearbeitbare technische Zeichnung mit korrekten Beschriftungen.
Bei Software ist eine abgegrenzte Funktion kein Feature, das Oberfläche, API, Datenbank und Migrationspfad umfasst. Ein Code-Review ist keine behobene Schwachstelle. Ein gemergter Pull-Request ist kein wiederhergestellter Dienst.
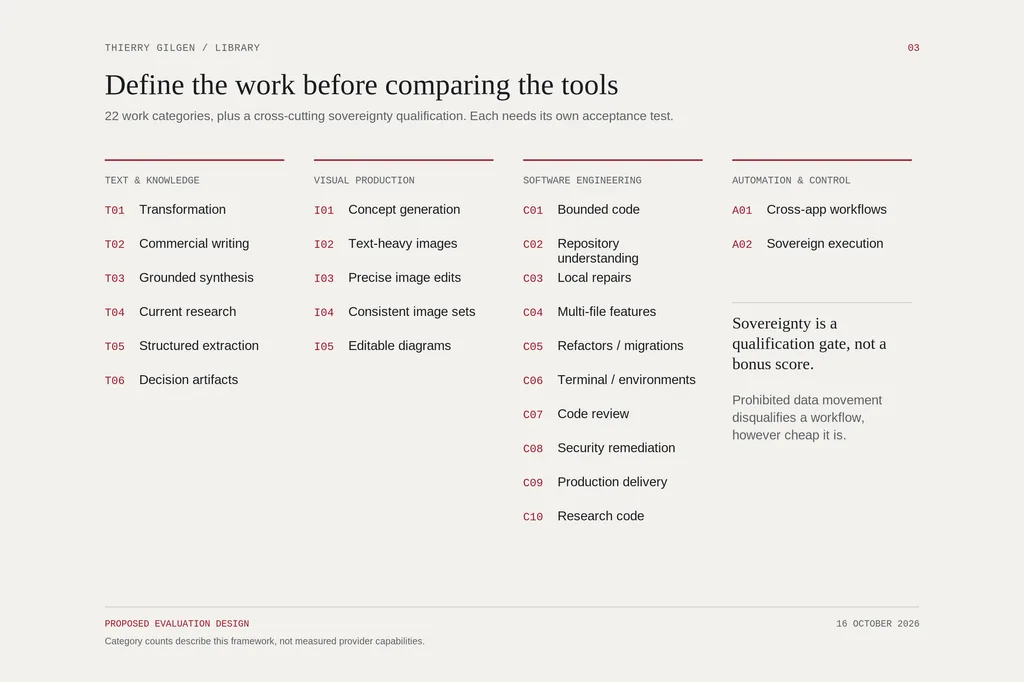
Dieser Band arbeitet darum mit 23 Bewertungskategorien. Zweiundzwanzig beschreiben Arten von Arbeit. Die dreiundzwanzigste, souveräne Ausführung, ist zugleich eine Zulassungsbedingung, die quer über allen liegt, und nicht einfach eine weitere Aufgabe, die man in einen Durchschnitt einrechnet.
| Familie | Kategorien | Die Abnahme muss zeigen |
|---|---|---|
| Schreiben und Wissensarbeit | Umformen; kommerzielle Texte; belegte Synthese; aktuelle Recherche; Extraktion; Entscheidungsgrundlagen | Sinn, Belege, Felder, Berechnungen und Verwendungszweck stimmen. |
| Visuelle Produktion | Konzepte; textlastige Kompositionen; präzise Retuschen; stimmige Serien; bearbeitbare Diagramme | Der tatsächliche Auftrag ist erfüllt, einschliesslich dessen, was erhalten und einheitlich bleiben muss. |
| Software-Entwicklung | Abgegrenzter Code; Verständnis des Repositorys; lokale Reparatur; Features über mehrere Dateien; Refactoring/Migration; Arbeit im Terminal; Review; Behebung von Sicherheitslücken; Auslieferung in den Betrieb; Forschungscode | Die massgeblichen Tests, Integration, Prüfung und Betriebsbedingungen halten. |
| Automatisierung und Kontrolle | Abläufe über mehrere Anwendungen; souveräne Ausführung | Der erlaubte Endzustand ist erreicht, ohne verbotene Handlungen oder Datenflüsse. |
Für jede Kategorie gilt: Den Abnahmetest legt man fest, bevor der Agent beginnt. Man hält ihn getrennt von dem, was der Agent über seine eigene Leistung berichtet. Und man verlangt von jedem Kandidaten denselben Massstab.
«Erstelle einen Patch» lädt zu einem Patch ein. «Behebe diesen Fehler, erhalte dieses Verhalten und belege es mit einem Regressionstest» beschreibt Arbeit, die sich beurteilen lässt.
Das ist keine Bürokratie, die der Produktivität im Weg steht. So erfahren wir überhaupt erst, ob Produktivität stattgefunden hat.
4. Programmieren: stärkere Modelle und günstigere Arbeit sind zwei Fragen
Der Coding Agent Index v1.5 von Artificial Analysis bietet einen nützlichen, ausdrücklich begrenzten Vergleich. Er umfasst 113 Aufgaben im Repository, 66 Aufgaben im Terminal und 124 Fragen zu Repositorys, mit je drei Versuchen pro Aufgabe. Der Gesamtwert mittelt die drei Benchmarks gleich gewichtet. Die Kosten sind API-Durchschnitte pro gewertetem Versuch, keine Abogebühren und keine Kosten einer Auslieferung in den Betrieb.19
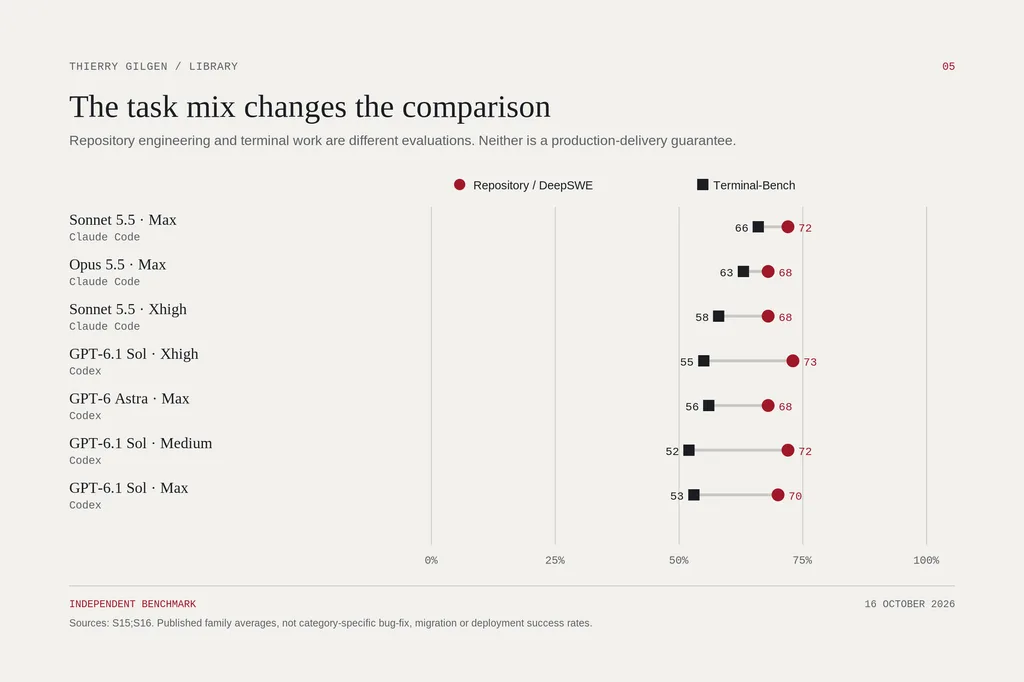
Die folgende Auswahl zeigt starke Konfigurationen und unterschiedliche Aufwandsstufen. Sie ist nicht die ganze Rangliste. Kleine Unterschiede im Wert sind keine belegten Unterschiede in der Verlässlichkeit.
| Agent und Konfiguration | Index | Repository-Aufgaben | Terminal-Aufgaben | USD pro Versuch | Agent-Minuten |
|---|---|---|---|---|---|
| Claude Code · Sonnet 5.5 Max | 68 | 72% | 66% | 14.19 | ≈90 |
| Claude Code · Opus 5.5 Max | 66 | 68% | 63% | 13.04 | ≈66 |
| Claude Code · Sonnet 5.5 Xhigh | 63 | 68% | 58% | 3.33 | 27.0 |
| Codex · GPT-6.1 Sol Xhigh | 63 | 73% | 55% | 1.04 | 15.5 |
| Codex · GPT-6 Astra Max | 62 | 68% | 56% | 7.47 | 29.4 |
| Codex · GPT-6.1 Sol Medium | 61 | 72% | 52% | 0.70 | 10.9 |
| Codex · GPT-6.1 Sol Max | 60 | 70% | 53% | 1.55 | 24.4 |
Es sind die gerundeten, veröffentlichten Werte des Prüfers, keine Messungen für diesen Text. «Repository-Aufgaben» steht für DeepSWE v1.1, «Terminal-Aufgaben» für Terminal-Bench 4.0.20
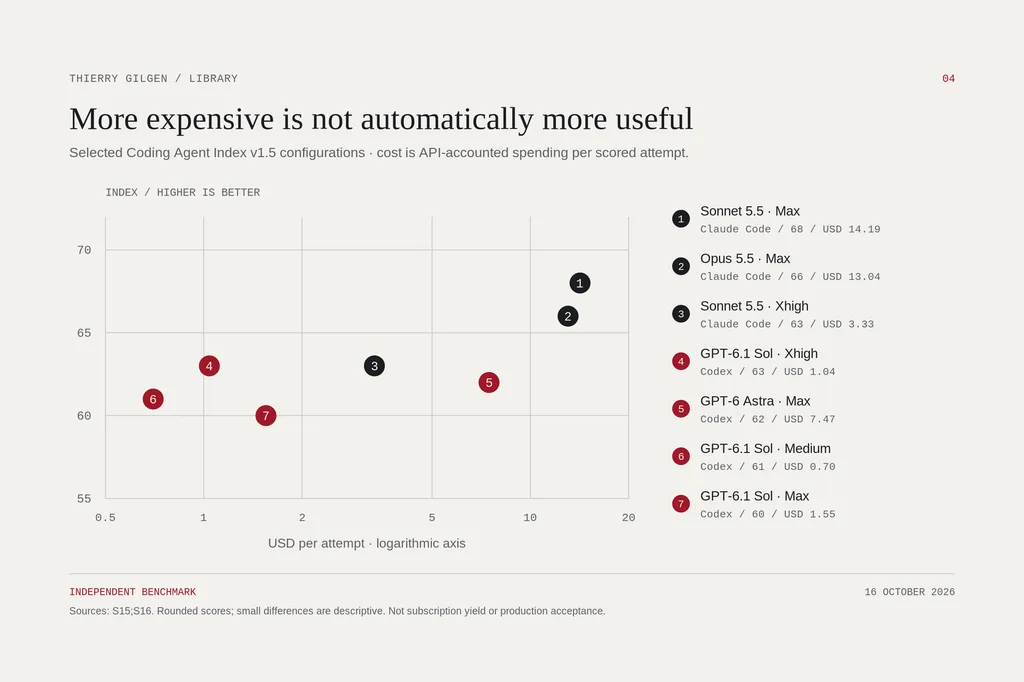
Die Resultate stützen zwei brauchbare Hypothesen für einen Einkaufstest. Mittlere Sol-Einstellungen verdienen einen Versuch, wenn Repository-Arbeit günstig sein soll. Claude mit hohem Aufwand verdient einen Versuch, wenn die stärkere Leistung im Terminal genug Nacharbeit sparen könnte, um den Mehrverbrauch zu rechtfertigen. Dass eines der beiden Produkte immer besser wäre, zeigen sie nicht.20
Man beachte, was «Max» nicht garantiert. Sol Medium lag in dieser Momentaufnahme knapp über Sol Max, kostete weniger und war schneller fertig. Bei Sonnet senkte deutlich weniger Aufwand auch den Wert. Aufwand ist eine Einstellung, die man je Aufgabe testet, kein Gütesiegel.20
Bei Cursor ist Vorsicht nötig. Diese Recherche fand keine vollständige, aktuelle und vergleichbare Ergebnistabelle für das Cursor CLI. Ältere Composer-Resultate beruhen auf einer früheren Testreihe und dürfen nicht in den aktuellen Vergleich eingeflickt werden. Grok Build ist ein anderer Agent und kein Ersatzmass für Cursor.2122
Diese Lücke ist kein Befund gegen Cursor. Integration in den Editor, Umgang mit Kontext und ein ununterbrochener Arbeitsfluss können Wert schaffen, den der Wert eines anderen Agenten nicht erfasst. Ehrlich ist, diese Vorteile an der echten Arbeit zu messen, statt Cursor eine geliehene Zahl zuzuschreiben.
Auch Code-Reviews brauchen einen eigenen Nenner. Anthropic schätzte beim Start im März USD 15–25 pro Review; ein fester Tarif für jedes Review ist das nicht. Die aktuelle Dokumentation beschreibt nutzungsabhängige Kosten und Auslöser, die mehrere Reviews auf einem Pull-Request erzeugen können. Das gehostete Review analysiert den Code, ohne ihn zu bauen oder auszuführen.2324
Zählen sollte man bestätigte, wesentliche Mängel und den menschlichen Prüfaufwand, nicht bloss erzeugte Kommentare. Ein Prüfer, der auf jeden nützlichen Fund drei erfundene Bedenken liefert, beschäftigt das Team, ohne die Software sicherer zu machen.
5. Schreiben: flüssiger Text ist noch keine fertige Wissensarbeit
Es gibt glaubwürdige Belege, dass Unterstützung beim abgegrenzten Schreiben hilft. Im Experiment von Noy und Zhang aus dem Jahr 2023 bearbeiteten 453 Teilnehmende mit Hochschulabschluss berufliche Schreibaufgaben. Berichtet wurden 40% weniger Bearbeitungszeit und 18% bessere Qualitätsnoten. Das spricht für den Nutzen der Technik in der getesteten Umgebung. Eine Rangliste der Abos vom Oktober 2026 ergibt sich daraus nicht.2526
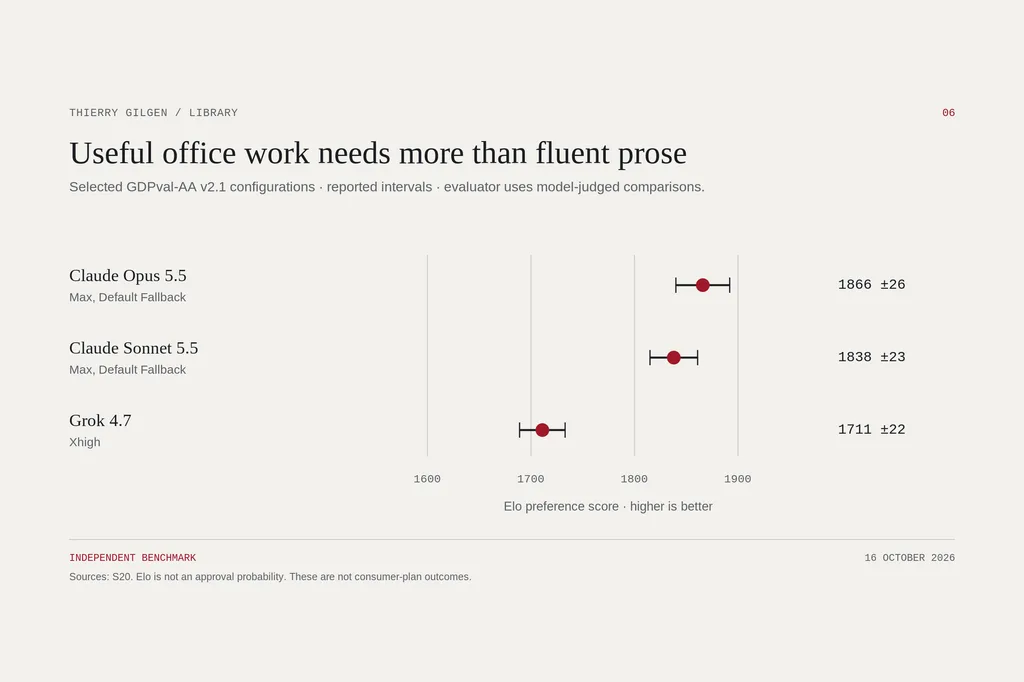
Für heutige berufliche Arbeitsergebnisse kommt GDPval-AA nützlicher Büroarbeit näher als ein allgemeines Wissensquiz. Es umfasst 220 öffentliche Aufgaben aus 44 Berufen und neun Branchen. Die aktuellen Einträge Opus 5.5 Max und Sonnet 5.5 Max erreichen 1866 und 1838 Elo; der Prüfer kennzeichnet beide Konfigurationen ausdrücklich als Default Fallback. Es sind Konfigurationen mit Werkzeugen, bewertet in Vergleichen, die ein Modell beurteilt. Mit Endkunden-Abos oder der Wahrscheinlichkeit einer menschlichen Abnahme haben sie nichts zu tun.27
Die praktische Prüfung muss näher am Auftrag der Kundin bleiben.
Beim Umschreiben misst man, ob Sinn und Fachbegriffe erhalten bleiben, und notiert die Minuten für die Nachbearbeitung. Bei einem Recherchedossier prüft man, ob die Quellen existieren, aktuell genug sind und die Aussagen tatsächlich stützen. Bei einer Extraktion vergleicht man die Felder mit bekannten Antworten. Bei einer Tabelle müssen die Formeln funktionieren und die Summen aufgehen.
Belohnen sollte man keinen Assistenten dafür, dass er zusätzliche Wörter produziert, die jemand anders prüfen muss. Und bestrafen sollte man kein knappes, richtiges Ergebnis, nur weil ein anderes Modell ein eindrucksvoller wirkendes Dokument geliefert hat.
Wissensarbeit scheitert oft an der Grenze zwischen plausibel und haltbar. Diese Grenze braucht einen eigenen Abnahmetest.
6. Bilder: Die Generierung ist noch nicht das Bild, das man braucht
Bei Bildern sieht man vergleichsweise klar, dass Modellqualität und Produktionskosten zwei verschiedene Dinge sind.
In den abgerufenen Präferenzwerten von Artificial Analysis erreicht GPT Image 2.5 Sunburst Max beim Erzeugen 1218, Nano Banana 2.1 erreicht 1172 und Grok Imagine Image 2.0 erreicht 1165. Die angegebenen 95%-Intervalle betragen ±10, ±12 und ±13. Dieselbe Seite nennt API-Referenzpreise von umgerechnet USD 0.2107, USD 0.0336 und USD 0.0600 pro erzeugtem Bild.28
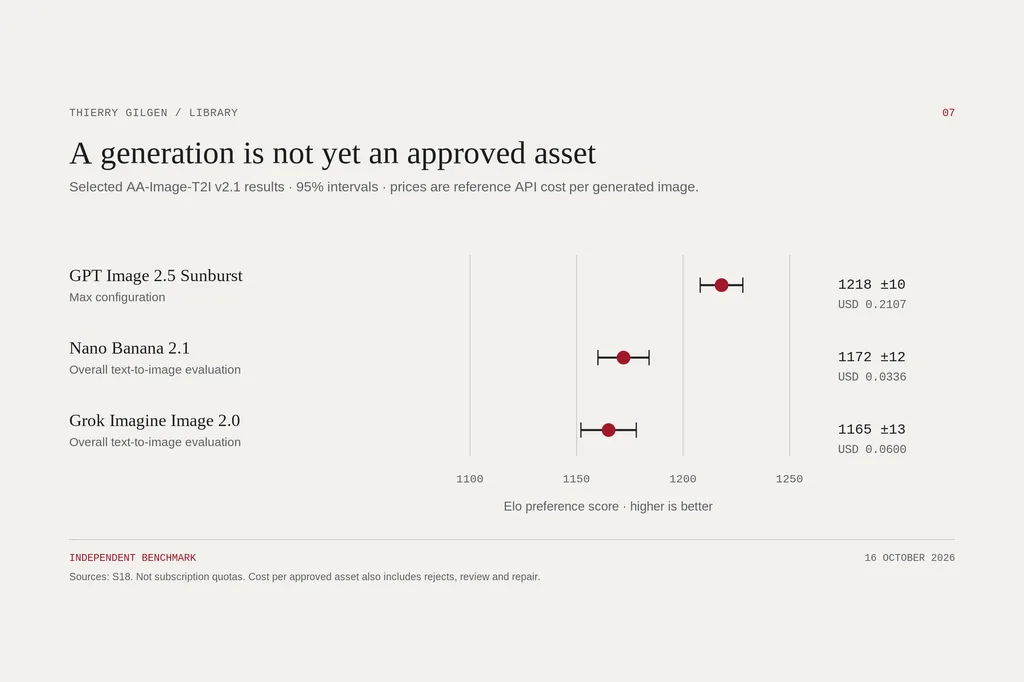
Bearbeitung wird separat bewertet: Sunburst erreicht 1199 ±11, Nano Banana 1152 ±13 und Grok in der aktualisierten Momentaufnahme 1117 ±13.29
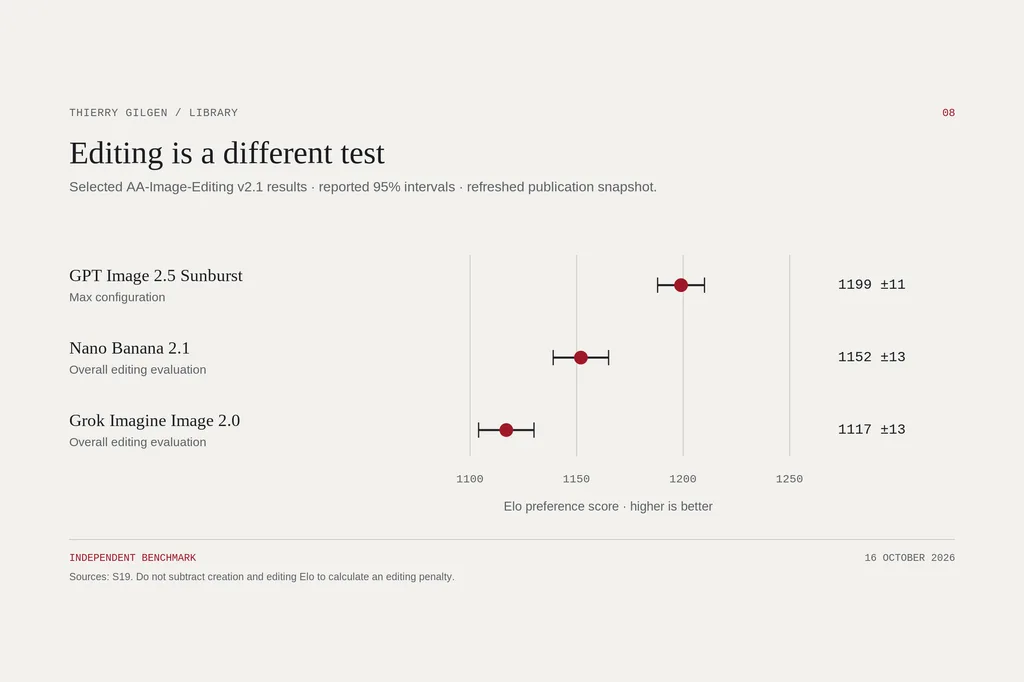
Diese Resultate helfen, Kandidaten zu finden. Die Produktionsentscheidung nehmen sie nicht ab. Das günstigere Modell kann sich lohnen, um Ideen zu erkunden. Das stärkere kann am Ende billiger sein, wenn eine anspruchsvolle Retusche sonst viele Versuche und Handarbeit kosten würde. Das ist eine Hypothese über den Arbeitsablauf, kein Ergebnis, das die Präferenzrangliste gemessen hätte.
Bei einer Kampagne zählt man die stimmige Serie. Bei einer Produktretusche prüft man, was unverändert bleiben muss. Bei einem Diagramm verlangt man korrekte Beschriftungen und eine bearbeitbare Quelldatei. Und man rechnet die Kosten für verworfene Bilder, Prüfung, Nachbearbeitung und externe Werkzeuge mit ein.
Claude kann über Integrationen auch externe Bildwerkzeuge steuern. Ein eigenes Bildkontingent im Claude-Abo entsteht dadurch nicht; der externe Dienst gehört weiterhin zur Rechnung für Zugang und Kosten.30
Die Einheit ist das freigegebene Bild, nicht das erzeugte.
7. Warum sich die Produktivitätsstudien widersprechen
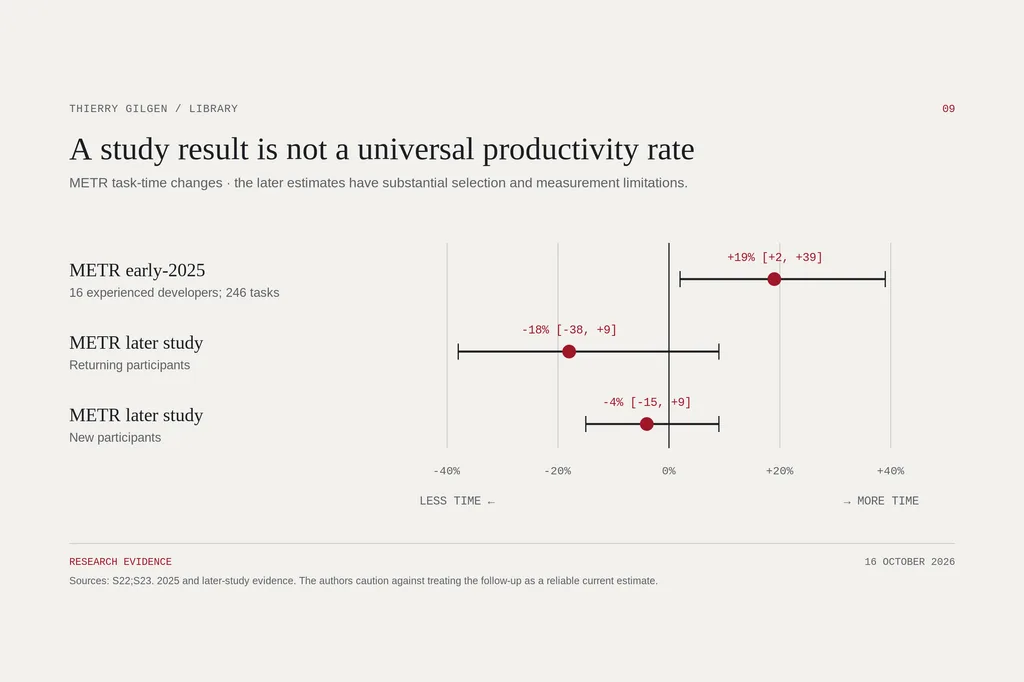
Ein abgegrenztes Experiment mit GitHub Copilot ergab, dass eine Aufgabe, einen HTTP-Server in JavaScript zu schreiben, 55.8% schneller erledigt wurde. Die Studie von METR aus dem frühen 2025 kam zu einem anderen Ergebnis: 16 erfahrene Entwickler brauchten für 246 Aufgaben in ihren eigenen Repositorys 19% länger, wenn KI erlaubt war.3132
Es waren nicht dieselben Werkzeuge, Personen, Aufgaben oder Abnahmebedingungen. Die beiden Zahlen sind keine konkurrierenden Schätzungen einer allgemeinen Produktivitätskonstante der KI.
Besonders lehrreich ist die Folgestudie von METR vom Februar 2026. Sie schätzte für zurückkehrende Teilnehmende 18% weniger Zeit und für neue 4% weniger, doch beide Intervalle schlossen null ein. Die Autoren beschrieben zudem Selektionseffekte und Schwierigkeiten, parallele Agentenarbeit zu messen. Als aktuelle Schätzung der Produktivität seien die Resultate deshalb nicht verlässlich.33
Eine separate Umfrage von METR unter 349 technischen Fachleuten hält wahrgenommenen Nutzen fest, keine gemessene Zeitersparnis gegenüber einer Vergleichssituation. Die eigene Beobachtungsauswertung von DX berichtet von einem medianen Anstieg der Pull-Request-Menge um 7.76%. Durchsatz ist nicht dasselbe wie der Wert der Software, und ein beobachteter Zusammenhang ist keine allgemeine Ursache.3435
Erfahrungsberichte aus der Praxis bleiben nützlich. Sie zeigen Reibung, die ein Benchmark übersieht: Unterbrechungen, wechselnde Limiten, Prüflast, gescheiterte Integrationen und überraschende Rechnungen. Begeisterte wie verärgerte Berichte sind aber ausgewählte Erfahrungen. Ohne Aufgabenbeschreibung, Kostenbuch, Fehlerprotokoll und Abnahmemassstab können sie anderen Käufern nicht sagen, wie viel Arbeit ein Abo liefern wird.
Die richtige Frage lautet nicht: «Fühlt sich KI schneller an?» Sie lautet: «Wohin ist die Zeit gewandert?»
Von der Umsetzung ins Review? Vom Schreiben ins Faktenprüfen? Vom Erzeugen von Code ins Reparieren der Umgebung? Oder ist der Gesamtaufwand wirklich gesunken, bei gleich gutem Ergebnis?
8. Souveränität kommt vor dem Preisvergleich
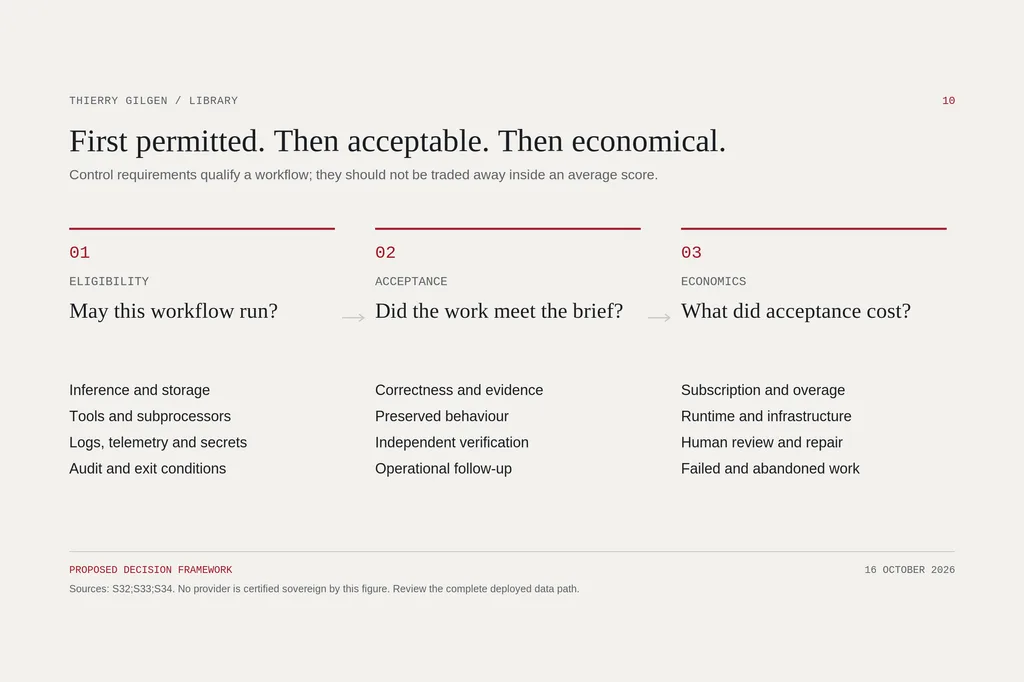
Die Frage der Souveränität entscheidet, welche Abläufe überhaupt verglichen werden dürfen.
Dass ein Agent in einem lokalen Terminal läuft, heisst nicht, dass auch die Inferenz lokal geschieht. Cursor dokumentiert, dass Prompts und Code-Kontext an Modell- oder Inferenzanbieter gehen. Bei Claude hängt die Aufbewahrung von Konto und Vertrag ab. OpenAI unterscheidet zwischen Datenresidenz und Inferenzresidenz.363738
Kein Training, keine Aufbewahrung, regionale Speicherung und Kontrolle über die Inferenz sind verschiedene Zusagen. Ein Produkt kann die eine erfüllen und die andere nicht.
Man muss den ganzen Weg aufzeichnen: Inferenz, Ausführung der Werkzeuge, Arbeitsergebnisse, Logs, Telemetrie, Unterauftragnehmer, Zugangsdaten, Prüfzugang und Ausstieg. Eine lokal betriebene Oberfläche genügt nicht, wenn ein angebundenes Werkzeug geschützte Inhalte still anderswohin schickt.
Die Aktion für Code Review im Unternehmen zeigt das praktische Problem: Einige Konfigurationen zur Datenkontrolle sind ausgeschlossen. Ein grosses Kontingent, das man unter den geforderten Bedingungen nicht nutzen darf, hat für diese Arbeit keinen brauchbaren Wert.16
Selbst betriebene Systeme gehören in den Kostenvergleich, aber nicht zu fiktiven Kosten von null. Man rechnet Hardware oder Hosting, Auslastung, wo nötig Strom, Wartung, Sicherheitsbetrieb und menschliche Betreuung. Und man zählt dieselben gescheiterten Abnahmen wie bei einem Cloud-Dienst.
Die Reihenfolge sollte einfach sein: Ist der Ablauf erlaubt? Erfüllt das Ergebnis den Massstab? Was kostet es? Ein billiger, verbotener Ablauf wird nicht zulässig, weil er eine gewichtete Punktewertung gewinnt.
9. Die Kosten, die nach der Abnahme bleiben
Zwei Rechnungen sollte man nebeneinander führen.
Barkosten pro abgenommenem Ergebnis sind die zugeteilten Abokosten, tatsächliche Mehrnutzungs- oder API-Gebühren und Laufzeitkosten, geteilt durch die abgenommenen Ergebnisse.
Vollkosten pro abgenommenem Ergebnis rechnen zusätzlich die menschliche Arbeit für Auftrag, Prüfung, Nacharbeit und zurechenbare Nachbetreuung ein, bevor man durch denselben Nenner teilt.
Man nimmt eine einzige Abrechnungsperiode. Gescheiterte und abgebrochene Versuche zählen mit. Ein geteiltes Abo wird einmal verteilt, nicht jeder Kategorie voll angerechnet. Arbeitszeit wird bei Abläufen mit und ohne KI gleich gezählt. Wird kein Ergebnis abgenommen, schreibt man genau das hin, statt eine beruhigende Null auszuweisen.
Hier ein bewusst hypothetisches Beispiel. Es sind keine Resultate von Anbietern.
| Ein Monat; 40 gleichwertige abgenommene Ergebnisse | Ablauf A | Ablauf B |
|---|---|---|
| Abo | USD 20 | USD 200 |
| Übrige Barkosten | USD 120 | USD 80 |
| Menschlicher Aufwand | 24 Stunden | 9 Stunden |
| Angenommener Stundensatz | USD 60/Stunde | USD 60/Stunde |
| Vollkosten | USD 1 580 | USD 820 |
| Kosten pro abgenommenem Ergebnis | USD 39.50 | USD 20.50 |
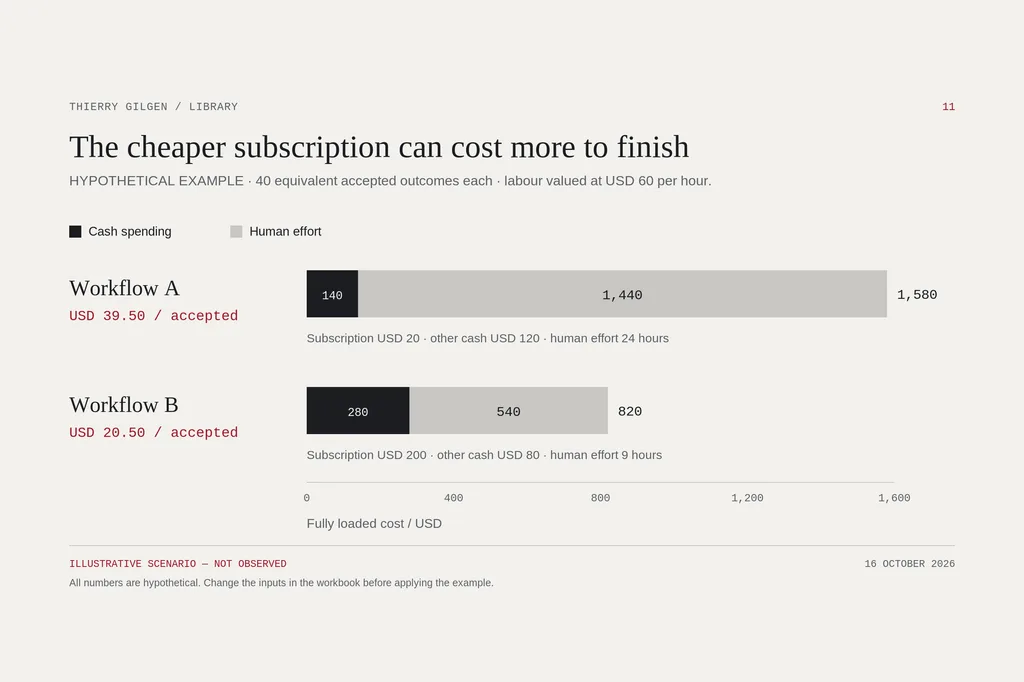
Das Abo, das auf der Preisseite teuer aussieht, ist in diesem konstruierten Ablauf das günstigere. Dreht man die Last der Nacharbeit um, kann sich auch das Ergebnis umdrehen.
Abgenommene Arbeit ist trotzdem nicht automatisch gewinnbringende Arbeit. Eine Kampagne kann ihr Briefing erfüllen und im Markt scheitern. Eine Funktion kann korrekt sein und niemand will sie. Die Abnahme ist ein notwendiger betrieblicher Nenner, kein Anspruch auf Umsatz. Für den geschäftlichen Wert braucht es ein weiteres, zum Geschäft passendes Mass.
Auch die verstrichene Zeit gehört getrennt von der menschlichen Zeit. Ein Agent, der eine Stunde arbeitet, während seine Bedienerin anderswo Nützliches tut, hat keine Stunde ihrer Arbeitszeit verbraucht. Umgekehrt kann ein ständig unterbrochener Ablauf Koordinationskosten verursachen, die auf keiner Token-Rechnung erscheinen.
10. Der Versuch, den Käufer wirklich durchführen können
Die öffentlichen Belege reichen für eine engere Auswahl. Für eine geprüfte Zahl abgenommener Releases, freigegebener Bilder oder haltbarer Recherchedossiers pro Abo reichen sie nicht.
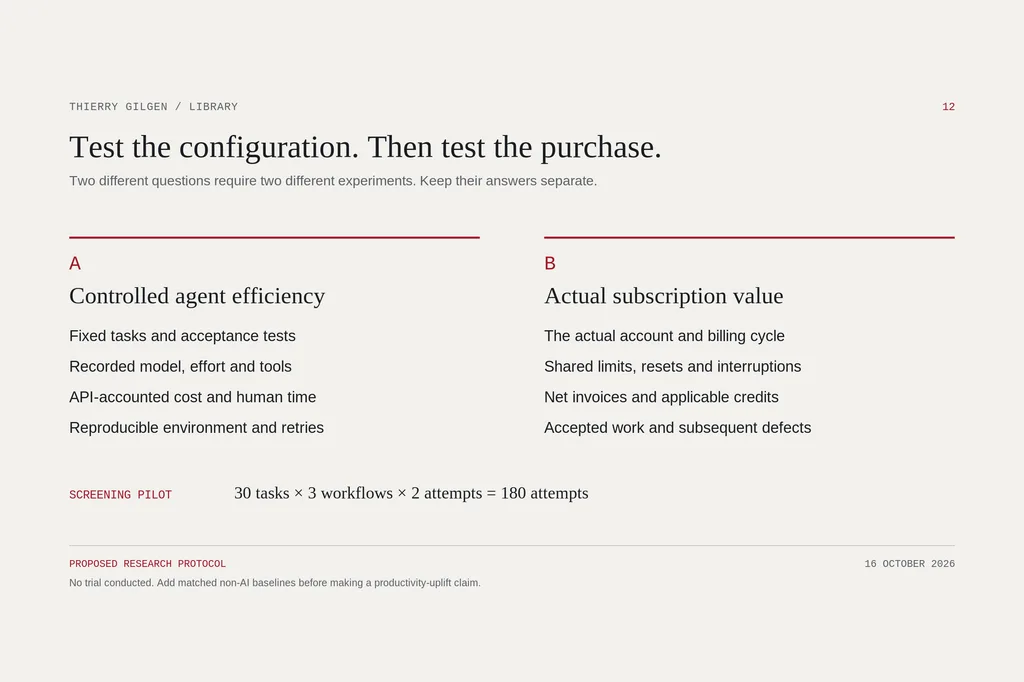
Ein praktischer Vortest könnte 30 repräsentative interne Aufgaben, drei Kandidaten und je zwei unabhängige Versuche umfassen: 180 Versuche. Das ist ein vorgeschlagener Pilot, kein statistisch belastbarer Branchenbenchmark. Zwei Wiederholungen sind viel zu wenig, um verlässliche Fehlerwahrscheinlichkeiten je Aufgabe zu bestimmen.
Die Aufgaben stammen aus Schreiben, Recherche und Arbeitsergebnissen, visueller Produktion, abgegrenztem Code, Arbeit im Repository sowie Release- oder Betriebsarbeit. Die Eingaben werden eingefroren. Die Abnahme wird vor dem Test festgelegt. Die Reihenfolge wird ausgelost, und wo es geht, wissen die Prüfenden nicht, welcher Ablauf welches Ergebnis geliefert hat. Aufgabenversionen bleiben getrennt, damit weniger gelernt und weniger Lösung durchgereicht wird.
Entscheidend ist, zwei verschiedene Vergleiche zu führen. Ein Test von Modell und Agent legt Aufgabe, Werkzeuge, Aufwandsstufe und Budget fest und misst Qualität, Kosten und Zeit. Ein Abo-Test beobachtet das tatsächlich gekaufte Konto über einen Abrechnungszyklus, mit gemeinsamen Limiten, Resets, Drosselungen, Aktionen und Zusatzkosten. Der eine beantwortet, welche Konfiguration effizient ist. Der andere, was das Abo wirklich kauft.
Wer eine Aussage über Produktivität machen will, braucht eine passende Vergleichsgruppe ohne KI. Sonst kann die Studie KI-Abläufe untereinander vergleichen, aber nicht zeigen, wie viel besser die KI als die Alternative war.
Festzuhalten sind: Abnahme im ersten Durchgang, Abnahme nach begrenzter Nacharbeit, menschliche Minuten, verstrichene Zeit, Barkosten, Vollkosten, Eingriffe und spätere Mängel. Fehlschläge werden mit derselben Sorgfalt erfasst wie Erfolge. Ein Modell, das den Test wegeditiert, hat den Test nicht bestanden.
Vor Beginn legt man fest, wann Schluss ist. Ein dritter Versuch braucht einen Grund: neue Erkenntnisse, eine andere Konfiguration oder eine korrigierte Umgebung. Eine unproduktive Schleife mit grösserem Kontingent zu wiederholen, ist keine Optimierung. Harte Budgetgrenzen sind gerade deshalb wichtig, weil Agenten weiter Ressourcen verbrauchen können, ohne ein brauchbares Ergebnis zu liefern.3940
Die Arbeit, nicht der Zähler
Das billigste Modell ist nicht immer der billigste Ablauf. Die stärkste Konfiguration im Benchmark ist nicht immer der beste Kauf. Und das Abo mit dem grössten Kontingent gibt seinem Besitzer nicht automatisch die meiste nützliche Kapazität.
Die Antwort hängt von der Arbeit ab, vom Abnahmemassstab, von den umgebenden Werkzeugen, von der Person, die sie bedient, und von den Bedingungen, unter denen das System laufen darf.
Das ist unbequemer als eine allgemeine Rangliste. Es ist auch nützlicher.
Fragen Sie am Anfang nicht, welcher Anbieter Sie am meisten Intelligenz verbrauchen lässt. Legen Sie zuerst fest, was wahr sein muss, wenn die Arbeit fertig ist. Dann suchen Sie den günstigsten zulässigen Ablauf, der diesen Massstab verlässlich erfüllt.
Der Wert von KI ist nicht verbrauchte Intelligenz. Er ist nützliche, abgenommene Arbeit und der Wert, der nach der Abnahme bleibt.
Methode und Grenzen
Diese Ausgabe verbindet Herstellerdokumentation, Resultate unabhängiger Prüfer, Originalstudien sowie ausdrücklich gekennzeichnete Praxis- und Beobachtungsbelege. Sie berichtet über keinen neuen Installationstest, keinen Belastungstest eines Abos und kein Experiment im Betrieb. Offizielle Leistungsbeschreibungen belegen angebotenen Zugang, keine gelieferten Ergebnisse. Benchmarks belegen Leistung unter ihren eigenen Aufgaben und Rechenregeln, nicht den Ertrag eines Endkunden-Abos.
Preise und Ranglisten wurden für diese datierte Ausgabe geprüft. Dynamische Seiten können sich ändern; die hier genannten Werte sind die am Abrufdatum gewählten, samt Quellen und Vorbehalten. Die Werte zur Bildbearbeitung wurden bei der Fertigstellung aktualisiert. Die Konfigurationsnamen bei beruflichen Arbeitsergebnissen behalten den Fallback-Hinweis des Prüfers. Ältere Belege sind datiert und werden nicht als Urteil über heutige Modelle ausgegeben.
Im Mittelpunkt stehen ChatGPT/Codex, Claude/Claude Code und Cursor, ergänzt um Google und Belege zu Bildmodellen, wo sie passen. Ein vollständiger Marktüberblick ist das nicht. Video, Audio, jedes regionale Angebot, jeder Unternehmensvertrag und jede selbst betriebene Alternative liegen ausserhalb des quantitativen Vergleichs. Wo öffentliche Belege keine allgemeine monatliche Token-Zuteilung und kein Kontingent erledigter Arbeit hergeben, wurde auch keines erfunden.
Der Vortrag am Anfang beruht auf der Erinnerung des Autors, nicht auf einem unabhängig geprüften Transkript. Die Quelleneinträge trennen diese Herkunft von öffentlicher Dokumentation. KI hat bei Recherche, Entwurf und Grafikproduktion geholfen. Das Titelbild ist generierte Konzeptkunst; die Belegabbildungen sind deterministisch aus den datierten Quelldaten gezeichnet. Mit Freigabe des Autors veröffentlicht am 16. Oktober 2026.
Quellen
Footnotes
-
Bericht des Autors über den Vortrag vom 15. Oktober 2026, im Rechercheauftrag vom 16. Oktober festgehalten. Kein unabhängiges Transkript eingesehen. Der Text nennt eine Anregung, keine Empfehlung. ↩
-
botts.ai. About us: Yves Zumbühl. Abgerufen am 16. Oktober 2026. Bestätigt nur Name und Zugehörigkeit, weder den Vortrag noch eine Zustimmung zu diesem Essay. ↩
-
OpenAI. Codex / Work pricing. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Anthropic. Claude Code on Pro or Max. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Cursor. Models and pricing. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Cursor. Legacy Cursor plans. Abgerufen am 16. Oktober 2026. ↩ ↩2 ↩3
-
Google. Gemini usage limits. Abgerufen am 16. Oktober 2026. ↩
-
OpenAI. About ChatGPT Pro tiers. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Anthropic. Claude pricing. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Cursor. New X subscription pricing. Abgerufen am 16. Oktober 2026. ↩
-
Google. AI subscriptions. Abgerufen am 16. Oktober 2026. ↩
-
OpenAI. ChatGPT pricing. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Monthly API credits. Abgerufen am 16. Oktober 2026. ↩
-
OpenAI. Banked Codex resets. Abgerufen am 16. Oktober 2026. ↩
-
OpenAI. Paid weekly resets. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Enterprise Code Review promotional credits. Abgerufen am 16. Oktober 2026. ↩ ↩2
-
Anthropic. Artifact promotion. Abgerufen am 16. Oktober 2026. ↩
-
Cursor. Student discount. Abgerufen am 16. Oktober 2026. ↩
-
Artificial Analysis. Coding Agent Index methodology v1.5. Abgerufen am 16. Oktober 2026. ↩
-
Artificial Analysis. Claude Code versus Codex. Abgerufen am 16. Oktober 2026. ↩ ↩2 ↩3
-
Artificial Analysis. Claude Code versus Grok Build. Abgerufen am 16. Oktober 2026. ↩
-
Artificial Analysis. Cursor’s Composer 2.5: third on the Coding Agent Index and ~10–60x lower cost than rivals. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Code Review costs and usage. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Code Review launch. Abgerufen am 16. Oktober 2026. ↩
-
Noy and Zhang / CEPR. Productivity effects of generative AI. Abgerufen am 16. Oktober 2026. ↩
-
Noy and Zhang / Science. Experimental evidence on the productivity effects of generative artificial intelligence. Abgerufen am 16. Oktober 2026. Originalstudie; geprüft über den indexierten Abstract und den Bericht der Autoren bei CEPR, nicht über den vollständigen Zeitschriftentext. ↩
-
Artificial Analysis. GDPval-AA v2.1. Abgerufen am 16. Oktober 2026. ↩
-
Artificial Analysis. Text-to-image v2.1. Abgerufen am 16. Oktober 2026. ↩
-
Artificial Analysis. Image editing v2.1. Abgerufen am 16. Oktober 2026. ↩
-
Hugging Face. Claude and MCP image generation. Abgerufen am 16. Oktober 2026. ↩
-
Microsoft Research / Peng et al.. Impact of AI on developer productivity. Abgerufen am 16. Oktober 2026. ↩
-
METR. Early-2025 experienced developer RCT. Abgerufen am 16. Oktober 2026. ↩
-
METR. Experiment-design update. Abgerufen am 16. Oktober 2026. ↩
-
METR. AI usage survey. Abgerufen am 16. Oktober 2026. ↩
-
DX. AI coding pricing and ROI guide. Abgerufen am 16. Oktober 2026. ↩
-
Cursor. Privacy and data governance. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Claude Code data usage. Abgerufen am 16. Oktober 2026. ↩
-
OpenAI. Data and inference residency. Abgerufen am 16. Oktober 2026. ↩
-
Simon Willison. Default hard budget caps. Abgerufen am 16. Oktober 2026. ↩
-
Anthropic. Claude Code costs. Abgerufen am 16. Oktober 2026. ↩