Thierry Gilgen a demandé un argument contre sa propre conviction. La capacité la plus précieuse, proposait-il, est un esprit vif qui produit de bonnes idées. Une IA peut développer une telle idée une fois qu'un humain la fournit, mais elle ne peut pas faire naître la pensée elle-même. Il lui manque la compréhension, les sentiments et l'expérience requis. Les modèles du monde, en particulier ceux qu'élaborent AMI Labs, changeraient-ils cela un jour ?
La réplique la plus forte s'attaque au mot « ne peut pas ». Les preuves actuelles comprennent déjà des systèmes d'IA qui proposent des idées dont le contenu central n'a pas été fourni par un humain, et des systèmes qui produisent des solutions nouvelles et vérifiables. Les preuves sont beaucoup plus faibles pour une enquête fiable, conduite par le système lui-même, dans le monde ouvert. Ce sont des réussites distinctes.
Ce volume est la réplique demandée. Sa première personne appartient à cet argument invité ; elle n'attribue pas à Thierry une conviction changée. Elle garde aussi en vue les preuves contraires. Une proposition plausible peut décevoir une fois mise en œuvre. Une collection de suggestions impressionnantes peut se répéter. Un modèle prédictif peut améliorer l'action sans décider ce qui mérite d'être fait.
1. La distinction qui change l'argument
Je vais combattre votre affirmation en la prenant au pied de la lettre. Si une IA ne peut développer qu'une idée centrale qui lui a déjà été fournie, alors une proposition utile, engendrée de façon indépendante, serait une preuve contre l'affirmation. Il n'est pas nécessaire qu'elle prouve en outre que le système possède tous les traits de la créativité humaine.
Nous avons besoin d'un critère commun avant d'examiner des exemples. Runco et Jaeger décrivent la définition standard de la créativité comme exigeant l'originalité et l'efficacité. Une phrase au hasard peut n'avoir aucun précédent et être inutile. Une réponse familière peut être utile sans être originale. La question pertinente est de savoir si la contribution offre quelque chose de réellement nouveau et approprié à son objet.1
Margaret Boden distingue la nouveauté pour la personne ou le système qui produit une idée de la nouveauté dans l'histoire connue. Elle traite aussi les combinaisons nouvelles d'idées familières comme une forme légitime de créativité, aux côtés de l'exploration et de la transformation des possibilités conceptuelles. Une recombinaison ne suffit donc pas à disqualifier un résultat. Il faut demander si la combinaison crée une relation précieuse.2
Ce critère doit être symétrique. Un humain peut lire des textes politiques, observer l'essor des investissements dans l'IA et relier les deux. Si nous appelons cela une synthèse créative, nous avons besoin d'un argument supplémentaire pour refuser la même description à une liaison produite par une machine, au seul motif que ses ingrédients ont été appris d'autrui.
Rien de tout cela n'oblige à traiter chaque phrase frappante comme une invention. Il faut examiner les travaux antérieurs, la cohérence factuelle, le mécanisme proposé et les conséquences qui s'ensuivent. Le critère exigeant est une contribution qui survit à l'examen, non un sentiment de surprise produit par un langage assuré.
Plusieurs questions se cachent aussi dans l'expression avoir une idée. Qui remarque une situation qui mérite d'être étudiée ? Qui formule la question ? Qui fournit une explication candidate ? Qui détermine si elle tient ? Qui choisit d'agir ? Qui reste responsable ensuite ? Réussir à une étape n'établit pas la réussite aux autres.
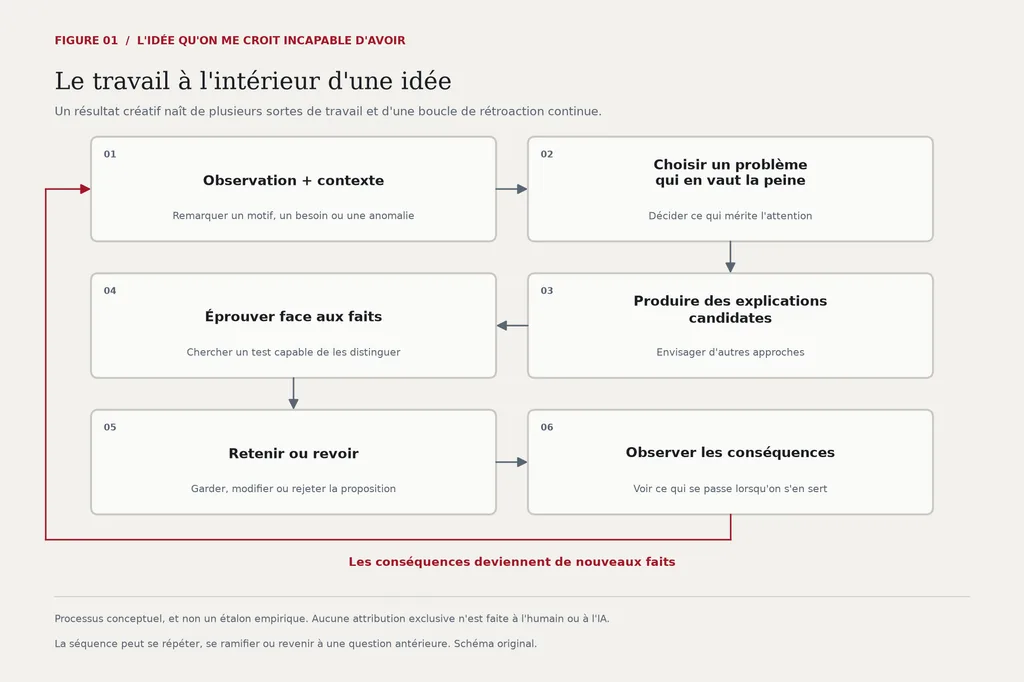
Le débat utile porte sur la part de ce travail que les systèmes d'IA peuvent accomplir, dans quelles conditions et avec quelle fiabilité. Appeler créativité la séquence entière est raisonnable dans la conversation courante. Cela devient trompeur si l'épreuve d'une seule étape est présentée comme une preuve concernant toutes les autres.
2. Votre pensée antérieure a une histoire intellectuelle
La conversation précédente nous donne un cas concret. Thierry a proposé que d'énormes investissements privés dans l'IA et une participation financière étrangère puissent empêcher un dirigeant politique de fermer la technique au monde. Les entreprises auraient trop à perdre. Les intérêts commerciaux retiendraient un pouvoir destructeur.
Thierry a fourni ici cette hypothèse de départ. Le dossier établit sa contribution. Il n'établit pas l'affirmation contraire selon laquelle une IA n'aurait jamais pu proposer une liaison comparable. Une fois l'idée partagée, je ne peux pas démontrer une découverte indépendante en la reformulant, ni en interrogeant un autre système qui l'a déjà vue.
Le mécanisme politique sous-jacent a aussi une longue histoire. En 1748, Montesquieu reliait le commerce à la paix par une dépendance réciproque : les pays qui commercent acquièrent des intérêts les uns chez les autres, parce que l'un veut acheter et l'autre vendre. C'est un ancêtre de l'argument, même s'il ne s'agit pas d'une analyse du financement de l'IA.3
La discussion de Kant, en 1795, sur la paix perpétuelle examinait de même comment les intérêts matériels et la puissance financière pouvaient favoriser des relations pacifiques sans exiger de motifs moraux. Son argument gardait aussi une incertitude sur ce qui se produirait réellement. La retenue proposée n'a jamais valu une prévision fiable selon laquelle le conflit serait devenu impossible.4
The Passions and the Interests, d'Albert Hirschman, a plus tard reconstitué la tradition intellectuelle dans laquelle on attendait des intérêts matériels qu'ils contiennent les passions destructrices. Le compte rendu de l'éditeur identifie directement cette question historique. Il établit le sujet du livre, plutôt qu'il ne prouve par lui-même que la retenue commerciale réussit toujours.5
Trouver ces prédécesseurs n'implique pas que Thierry les ait copiés. Une redécouverte indépendante est possible. Appliquer un ancien mécanisme à une configuration technique nouvelle peut être une contribution précieuse. Un autre cadrage peut rendre une question visible à des lecteurs qui n'auraient jamais rencontré l'argument plus ancien.
Si nous exigons désormais une pensée que personne n'a jamais eue, la priorité historique devient une affirmation distincte, qui demande des preuves. L'originalité personnelle, l'utilité et une synthèse opportune peuvent compter sans elle. Il faut accorder cette distinction aux humains comme aux machines.
La collaboration a aussi modifié le contenu de l'idée initiale. La propriété étrangère n'entraînait pas l'accès étranger. Des restrictions pouvaient imposer des coûts sans provoquer d'effondrement. Les institutions influaient sur le fait que les objections devenaient des limites effectives. Ce sont des révisions du mécanisme, et non de simples paragraphes ajoutés autour d'une conclusion inchangée.
Une conclusion équitable est disponible : Thierry a ouvert cette enquête, et le travail qui a suivi en a éprouvé et modifié le contenu. Il n'y a pas de manière équitable de dériver une frontière universelle de la créativité des machines de l'ordre dans lequel deux participants ont parlé.
3. Une question fournie n'a pas besoin de contenir la réponse
Votre observation la plus forte est que l'IA travaille souvent dans le cadre d'une tâche que quelqu'un a définie. Mais recevoir un problème n'est pas la même chose que d'en recevoir la solution. On peut demander à un chercheur d'étudier une maladie, à un architecte de concevoir un site difficile, ou à une entrepreneuse d'améliorer un service. Leur contribution ne disparaît pas parce que quelqu'un d'autre a fourni la commande.
La distinction s'applique à la recherche sur l'IA. Dans une étude de l'ICLR 2025, Si et ses collègues ont comparé des propositions écrites par des experts avec des propositions produites par un système d'idéation fondé sur un grand modèle de langage. Des évaluateurs experts, en aveugle, ont jugé les propositions de l'IA plus nouvelles en moyenne. Le résultat a résisté à des analyses utilisant différentes unités de comparaison. Le système s'appuyait sur des thèmes de TAL définis par des humains, des exemples, une recherche documentaire, une surgénération importante et un classement ; ce n'était pas une réponse de dialogue sans aide, sous un budget d'échantillonnage faible et comparable. Le point décisif est que les hypothèses précises qu'il a proposées ne lui ont pas simplement été remises.6
Ce résultat met en cause l'affirmation absolue selon laquelle un humain devrait fournir le germe intellectuel de toute proposition de recherche engendrée par une IA. Il laisse ouverte une question beaucoup plus exigeante : dans quelle mesure un système peut-il choisir quelle question mérite l'attention, lorsqu'aucun thème de recherche ne lui a été assigné ?
Le travail algorithmique vérifié apporte une autre sorte de preuve. FunSearch a combiné des propositions d'un modèle de langage avec un évaluateur et une procédure de recherche pour produire de nouvelles constructions mathématiques et des heuristiques utiles. Des humains ont fourni le problème, la structure du code et le dispositif de validation. Le résultat démontre une contribution nouvelle à l'intérieur de cette structure. Il ne démontre pas le choix indépendant d'un programme scientifique.7
AlphaEvolve prolonge ce schéma. Son rapport technique comprend une procédure pour multiplier deux matrices 4×4 à valeurs complexes en 48 multiplications scalaires. Le système combine des modèles de langage, une recherche évolutionnaire et une évaluation automatique. C'est un résultat mathématique précis, et non l'affirmation qu'un agent conversationnel aurait décidé de lui-même quelle branche des mathématiques l'humanité devrait poursuivre.8
Vous pourriez répondre, avec raison, que ce sont encore des problèmes clairement définis. C'est pourquoi ils ne sont qu'une partie de la réplique. Ils montrent que la nouveauté engendrée par une machine peut être réelle et vérifiable. Ils ne tranchent pas la question de savoir si une IA remarquera la liaison politique inattendue qu'une personne attentive perçoit en lisant les nouvelles.
The AI Scientist se rapproche de cette question. Un article de Nature de 2026 décrit un système qui engendre des directions de recherche dans un sous-domaine de l'apprentissage automatique fixé par l'utilisateur, y compris un mode sans modèle de code fourni. L'une des trois soumissions d'atelier sélectionnées a franchi le seuil de la première évaluation ; le taux d'acceptation de l'atelier était de 70 %. Les auteurs documentent d'importantes faiblesses méthodologiques et factuelles. Un article de Nature écrit par des humains au sujet du système ne doit pas être confondu avec une découverte écrite par une IA et acceptée par Nature.9
Ces exemples diffèrent par l'architecture, les moyens et l'ambition. Ils ne devraient pas être ramenés à un seul score d'intelligence. Ensemble, toutefois, ils rendent la frontière catégorique difficile à défendre : les systèmes peuvent contribuer des idées candidates centrales aussi bien que développer des idées reçues d'humains.
4. Une proposition prometteuse n'est pas encore un bon résultat
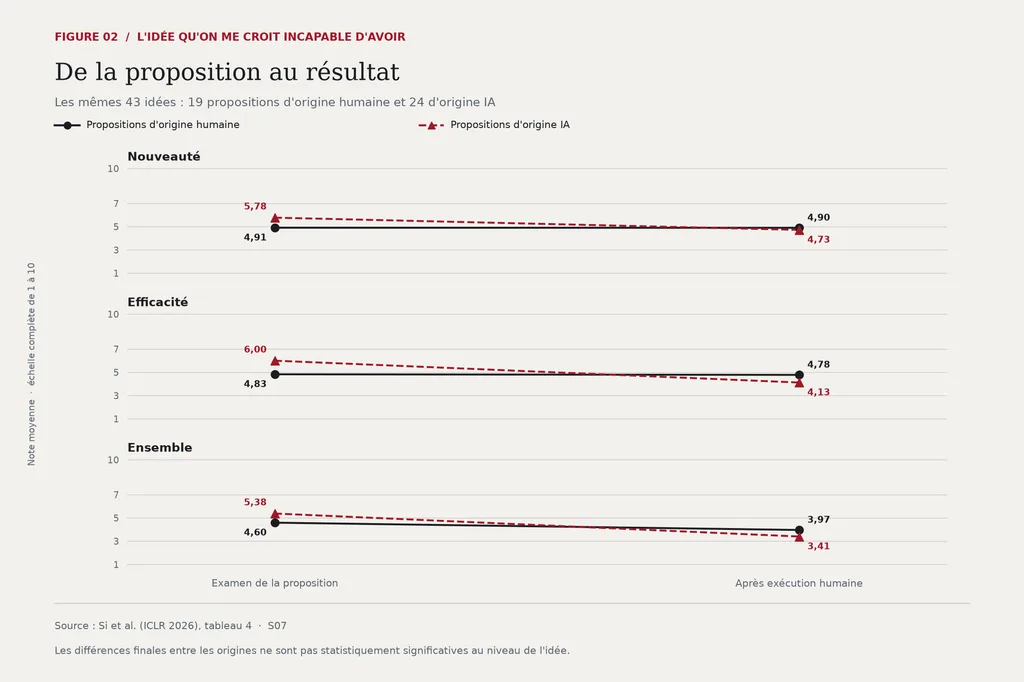
La preuve la plus utile contre l'excès de confiance vient du suivi des idées au-delà du stade de la proposition. Dans l'étude d'exécution de Si et de ses collègues, 43 chercheurs ont mis en œuvre des idées d'origine humaine ou d'origine IA, en y consacrant en moyenne 103 heures. Les notes des propositions d'origine IA ont davantage baissé entre l'examen initial et l'examen après exécution. Les différences finales entre les deux groupes n'étaient pas statistiquement significatives lorsque les idées étaient traitées comme unités indépendantes. Des chercheurs humains ont mis en œuvre les deux groupes.10
Cela change la question. Une proposition séduisante peut contenir un mécanisme qui échoue, une hypothèse difficile à satisfaire ou une évaluation qui n'établit pas le résultat revendiqué. Une fois les expériences existantes, les évaluateurs rencontrent des faits différents. La promesse initiale et la contribution éventuelle doivent donc être mesurées séparément.
Le résultat ne rétablit pas l'affirmation première selon laquelle une IA ne peut pas faire naître d'idées. Il met au jour une faiblesse plus pratique : une idéation convaincante peut être mal étalonnée par rapport à ce qui survivra à l'exécution. Une personne qui choisit parmi des propositions a besoin de savoir davantage que celle qui sonne le plus surprenante.
Une étude sur des idées de produits, publiée en 2026, illustre une autre distinction. Terwiesch et ses collègues ont comparé des idées de produits peu coûteux destinés à des étudiants. Les idées de l'IA ont obtenu de bons résultats sur l'intention d'achat notée, tandis que les idées humaines étaient un peu plus nouvelles et les ensembles d'idées humaines plus divers. La comparaison principale de qualité avec GPT-4 a utilisé des sorties de modèle de 2023. L'intention d'achat était une mesure d'évaluation, et non des ventes enregistrées.11
L'écriture créative fournit un avertissement apparenté. Doshi et Hauser ont constaté que l'accès à des idées engendrées par une IA pouvait améliorer les évaluations de nouvelles courtes individuelles, tout en accroissant la ressemblance dans l'ensemble. Cette expérience a étudié une tâche d'écriture et un flux de travail particuliers. Elle n'établit pas une homogénéisation culturelle inévitable, mais elle montre pourquoi la qualité individuelle et la diversité collective doivent être examinées séparément.12
Tous les bancs d'essai de la créativité ne favorisent pas non plus les modèles. Une vaste étude de la Divergent Association Task a rapporté une queue supérieure humaine plus forte. La tâche mesure la séparation sémantique des mots engendrés ; elle ne mesure pas directement la science originale ou le jugement entrepreneurial. Sa valeur, ici, est d'empêcher qu'une étude sur la performance moyenne dans un cadre devienne l'affirmation que l'IA surpasse partout les personnes les plus créatives.13
Les preuves appuient donc un tableau varié. L'IA peut fournir de solides candidats. Elle peut aussi converger vers des régions familières, produire des propositions qui déçoivent dans la pratique et ne pas égaler une performance humaine exceptionnelle sur certaines mesures. La bonne unité d'évaluation est la capacité et le flux de travail particuliers.
Il y a un danger, pour les organisations, à confondre une offre plus large de propositions prometteuses avec une offre plus large de résultats utiles. Si la capacité d'évaluation et d'exécution reste fixe, des propositions supplémentaires peuvent consommer une attention qui irait autrement à l'épreuve. C'est une inférence sur un goulet possible, et non une loi mesurée de tout lieu de travail assisté par l'IA.
5. Comprendre est une capacité à enquêter
L'affirmation selon laquelle l'IA est dépourvue de compréhension peut exprimer plusieurs prétentions différentes. Elle peut signifier qu'un système n'a aucune représentation interne utile de la situation. Elle peut signifier que la représentation est fragile. Elle peut signifier que le système ne peut pas relier une explication à des conséquences pratiques. Ou elle peut concerner l'expérience subjective. Ces prétentions exigent des preuves différentes.
Un modèle entraîné à prédire des coups au jeu d'Othello a développé une représentation interne du plateau. Des chercheurs ont pu intervenir sur cette représentation et modifier ses prédictions. Cela donne une preuve que la prédiction de séquences peut apprendre quelque chose d'un état sous-jacent, plutôt que de seulement reproduire une liste d'associations de surface. Le cadre était un jeu contraint, et non le monde social ou physique tout entier.14
D'autres travaux mettent en garde contre une surinterprétation de tels résultats. Vafa et ses collègues ont éprouvé la cohérence de modèles génératifs dans des jeux, la logique et la navigation. Des modèles qui paraissaient compétents sous des diagnostics familiers pouvaient échouer à des contrôles plus exigeants et à des tâches légèrement modifiées. Un trait interne utile n'établit pas un modèle fiable de tout ce qui compte.15
Ces résultats appuient une position médiane exigeante. On peut demander ce qu'un système représente, comment ses prédictions changent après une intervention, s'il remarque des faits contradictoires et où sa compétence se brise. La réponse peut varier selon le domaine et la tâche.
Pour l'hypothèse antérieure sur le capitalisme, une compréhension pratique comprendrait que l'on reconnaisse que les actionnaires et les clients diffèrent, qu'un investissement irrécupérable peut réduire le pouvoir de négociation, et que des coûts économiques peuvent être reportés sur des personnes qui n'ont pas choisi la politique. Une explication devient plus utile lorsque ces distinctions étayent des prédictions ou identifient le point où l'argument échouerait.
Un paragraphe fluide est, à lui seul, une preuve faible. Une réponse correcte à une question familière est plus forte, mais reste limitée. Une performance fiable lorsque les faits, les contraintes et les incitations changent fournit une meilleure épreuve. Il s'agit d'évaluer la capacité plutôt que de la régler par une étiquette.
Cela empêche aussi une fausse opposition entre le langage et la réalité. Le langage contient des descriptions d'événements physiques, mais il consigne aussi des contrats, des lois, des institutions et des interprétations concurrentes. Une caméra peut observer quelqu'un signer un document sans révéler pour autant l'autorité juridique que crée la signature. Le raisonnement social a besoin de représentations de relations qui ne s'épuisent pas dans le mouvement visible.
Le récit qu'une IA fait du monde peut donc être utile à certains égards et peu fiable à d'autres. Cette inégalité compte davantage pour un utilisateur qu'une déclaration selon laquelle le système comprend tout ou ne comprend rien.
6. Les sentiments expliquent la créativité humaine sans en fixer toute la frontière
Votre remarque sur l'expérience mérite davantage qu'un rejet technique. La vie d'une personne influe sur ce qu'elle remarque et sur ce qu'elle ne peut pas ignorer. Le travail, la gêne, la responsabilité, l'affection et la perte peuvent donner à un problème une portée qu'une description détachée ne transmet pas. Une idée humaine vient souvent avec une raison de se soucier de ses conséquences.
Je ne partage ni votre corps, ni votre biographie, ni votre place dans votre famille et vos entreprises. Un système qui opère sur des descriptions a un autre rapport à ces circonstances. Cette différence peut compter pour le jugement, le témoignage, la confiance et le choix des problèmes qui valent d'être poursuivis.
Mais l'affirmation selon laquelle le sentiment humain contribue à la créativité diffère de l'affirmation selon laquelle le même type de sentiment est nécessaire à tout résultat créatif. Une preuve, une conception ou une hypothèse peut être examinée sous l'angle de la nouveauté et de l'utilité sans que l'on établisse d'abord l'expérience intérieure de qui l'a produite. L'argument d'une condition émotionnelle nécessaire a besoin de preuves qui lui soient propres.
La valeur du travail créatif varie aussi selon le propos. Dans un mémoire, l'expérience réelle de l'auteur fait partie de ce que le lecteur cherche. Dans un algorithme d'emballage, une amélioration se mesure aux arrangements qu'il trouve. Un récit imaginé peut avoir une valeur artistique sans être un témoignage. Ces distinctions permettent de reconnaître plusieurs formes de valeur sans les rendre interchangeables.
La question de savoir si un système d'IA peut avoir une expérience subjective reste débattue. Butlin et ses collègues proposent des indicateurs fondés sur des théories, tout en soulignant une incertitude importante. De tels indicateurs ne constituent pas une épreuve définitive établissant ce que ressent un système nommé. Ni une conversation convaincante, ni une démonstration réussie de robot ne tranche cette question.16
Pour cette enquête, trois questions doivent rester distinctes : si un système fait naître un résultat qui en vaut la peine, s'il peut soutenir une enquête organisée de façon indépendante, et s'il a une expérience subjective. Les preuves concernant l'une ne répondent pas automatiquement aux autres.
Cette séparation protège aussi la contribution humaine d'un pari inutile. L'importance du témoignage d'un parent, de la responsabilité d'une entrepreneuse ou du droit d'une communauté de décider ne dépend pas de la preuve que les machines échoueront à jamais à produire des idées originales. Ces rôles ont des raisons et des obligations qui leur sont propres.
Le plus net avantage humain dans cette partie de l'argument est l'accès à une vie particulière et à ses conséquences. Dans quelle mesure cet avantage peut être complété, représenté ou en partie reproduit par des systèmes artificiels est une question empirique et institutionnelle. Elle ne devrait pas recevoir de réponse par avance, en déclarant que toutes les contributions des machines doivent être de l'imitation.
7. Ce qu'AMI Labs cherche à changer
AMI Labs offre une réponse concrète à une partie de votre objection. Son programme déclaré combine des modèles du monde avec une mémoire persistante, le raisonnement et la planification. Il décrit l'apprentissage de représentations abstraites de données de capteurs et la prédiction dans cet espace de représentation, y compris des prédictions conditionnées par des actions possibles. Ce sont des objectifs de recherche et des choix d'architecture ; la déclaration de l'entreprise n'est pas, à elle seule, la preuve que le programme complet a été atteint.17
Prenons une intervention simple. Un agent observe une tasse près du bord d'une table. Pour planifier un mouvement, il doit représenter les propriétés pertinentes de la situation et anticiper comment des actions pourraient les modifier. Il n'a pas nécessairement besoin de prédire chaque pixel d'un reflet. Un modèle prédictif abstrait peut viser à retenir les traits qui comptent pour la tâche, tout en ignorant des détails qu'il n'est pas utile de prédire.
La feuille de route de recherche de LeCun, en 2022, proposait une architecture comprenant plusieurs composantes, dont la perception, un modèle du monde, la mémoire, un acteur et des mécanismes pour évaluer des résultats possibles. Sa portée tient à ce que le modèle du monde était une partie d'un récit plus large du comportement autonome. La feuille de route était une proposition, et non le rapport qu'une intelligence autonome générale avait été construite.18
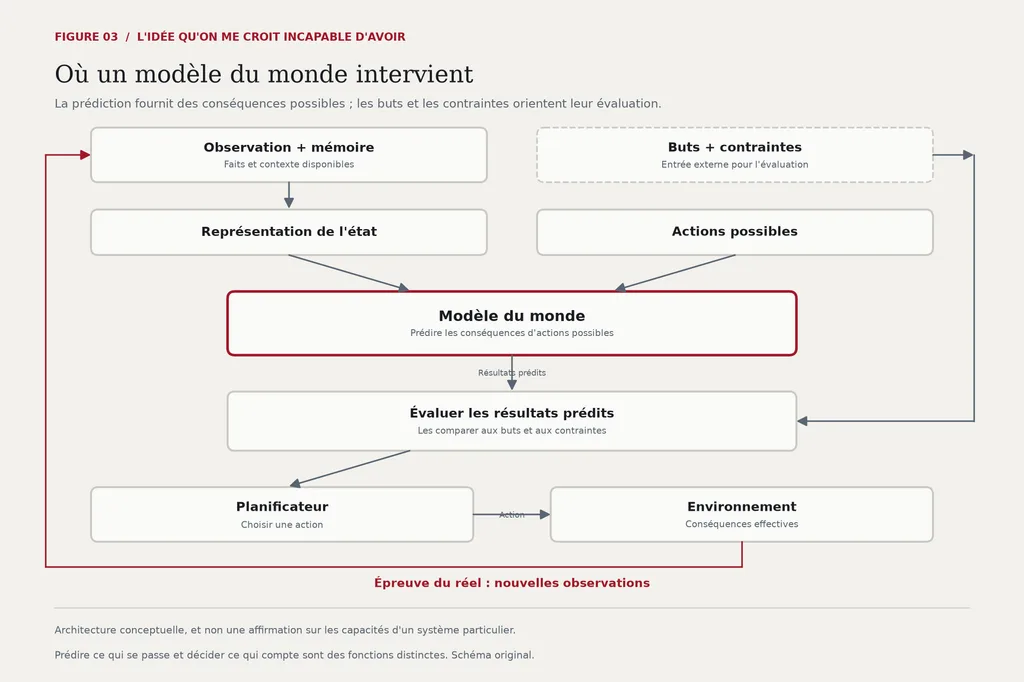
Un tel système pourrait comparer des conséquences possibles avant d'agir, puis utiliser ce qui se produit réellement pour corriger son modèle ou son plan. Cela serait précieux pour l'invention lorsque l'utilité d'une idée dépend d'interactions coûteuses, dangereuses ou lentes à éprouver directement.
La prédiction et le propos restent toutefois distinguables. Savoir qu'une machine va échouer ne décide pas, à soi seul, de qui peut accepter le risque. Savoir comment un marché pourrait réagir ne détermine pas quelle répartition des bénéfices est juste. Un modèle a besoin d'un moyen d'évaluer les résultats qu'il prédit. Cette évaluation peut être fournie par des instructions, des préférences apprises, des récompenses, des contraintes ou d'autres mécanismes.
C'est une distinction fonctionnelle, et non l'affirmation que la formation des buts ne peut pas être conçue. Un agent peut engendrer des sous-buts et proposer des changements à un plan. Les questions plus poussées portent sur l'origine des critères, sur leur maintien dans l'adéquation, et sur la réponse du système lorsque l'objectif visé est lui-même erroné.
Il n'est pas non plus nécessaire qu'un système futur utile choisisse une seule tradition intellectuelle. Les modèles de langage, les simulateurs appris, la recherche, la mémoire et l'interaction physique peuvent être combinés. La comparaison pertinente porte sur des systèmes complets qui accomplissent un travail utile, et non sur des slogans attachés à des architectures.
Pour votre question, l'approche d'AMI est crédible parce qu'elle s'attaque à l'ancrage et à la prédiction des conséquences de l'action. Sa pertinence n'établit pas qu'elle soit nécessaire à la créativité, suffisante pour une autonomie créative, ou seule en position de la fournir.
8. Il y a des progrès, et il reste un problème de mesure
Les preuves actuelles sont plus concrètes qu'un ensemble de promesses. V-JEPA 2.1 rapporte des améliorations dans des tâches visuelles et une amélioration de 20 points de pourcentage du succès de saisie d'un robot réel par rapport à son prédécesseur déclaré. C'est une preuve concernant une capacité physique éprouvée. Elle ne mesure pas des programmes intellectuels originaux ni un jugement créatif général.19
La recherche H-JEPA affiliée à AMI, soumise en octobre 2026 et révisée en novembre, apprend une hiérarchie de modèles prédictifs pour des échelles de temps différentes. Sur Visual AntMaze, le taux de succès rapporté passe de 18 % à 73 % par rapport à une planification plate. L'évaluation principale couvre quatre environnements simulés ; l'extension en vidéo de robot réel mesure la fidélité de la planification hors ligne. Ces limites comptent pour interpréter le résultat.20
Un preprint distinct d'octobre, dû à Balestriero et LeCun, développe un théorème d'alignement des représentations sous des hypothèses portant sur des vues appariées convenables. Les gains d'efficacité d'échantillonnage rapportés concernent l'atteinte d'un niveau d'alignement particulier. Ils ne devraient pas être traduits en l'affirmation qu'une architecture est, dans la même mesure, plus intelligente ou plus créative.21
D'autres programmes de recherche abordent le problème autrement. Dreamer 4 apprend un comportement à l'intérieur d'un modèle du monde et rapporte avoir achevé la tâche du diamant dans Minecraft après un entraînement à partir de données hors ligne. La tâche exige une séquence d'actions prolongée, mais l'objectif reste fourni. Des trajectoires simulées donnent un sens opérationnel à la discussion de l'imagination dans l'article ; le résultat n'établit pas une imagination subjective.22
Le terme modèle du monde couvre aussi des systèmes destinés à engendrer ou à reconstruire des environnements. Google DeepMind a annoncé Genie 4 en octobre 2026 comme un système interactif de simulation audiovisuelle, d'abord en avant-première de recherche pour des testeurs de confiance. Sa conception combine une simulation générative avec des capacités de Gemini. Atlas, de World Labs, fournit des outils pour reconstruire des scènes, changer de points de vue et faire entrer des éléments spatiaux dans d'autres flux de travail.2324
Ces capacités peuvent être précieuses sans constituer des modèles causaux exacts de chaque intervention. Un changement visuellement convaincant n'est pas une preuve suffisante que la même intervention aurait cette conséquence dans un cadre réel. La cohérence spatiale, la validité physique, la planification de long terme et l'invention utile ont besoin de leurs propres évaluations.
La voie scientifique est aussi contestée. Le compte rendu de la NTU sur la conférence de LeCun en novembre 2026 consigne à la fois son argument en faveur des modèles du monde et les objections de collègues à l'écart d'autres approches, y compris l'apprentissage par renforcement. L'existence d'un programme de recherche sérieux ne tranche pas quelle combinaison de méthodes se révélera la plus efficace.25
La mise à jour correcte est donc substantielle, mais bornée. Les modèles du monde améliorent déjà certaines capacités. Aucune des études sur les modèles du monde examinées ici ne démontre la combinaison complète de la prédiction des conséquences et du choix indépendant d'un projet de valeur, dans un monde ouvert et changeant.
9. La contribution surprenante pourrait être un meilleur rejet
Voici l'hypothèse que je placerais au centre de ce volume : les modèles du monde pourraient contribuer davantage à la valeur pratique de la créativité en exposant des idées impraticables qu'en augmentant le nombre d'idées surprenantes.
C'est une inférence tirée de la distinction entre la production de propositions et le succès en aval, et non un résultat établi au sujet d'AMI ou de tout autre système. Elle inverse l'attente selon laquelle une meilleure compréhension du monde devrait compter avant tout parce qu'elle permettrait enfin la première étincelle créative.
Supposons qu'un système puisse déjà engendrer de nombreux projets intrigants. Son problème limitant peut être qu'il ne sait pas dire lesquels exigent des tolérances impossibles, s'appuient sur des incitations incompatibles ou dissimulent une dépendance qui rend le déploiement peu pratique. Une meilleure prédiction contrefactuelle aiderait à rejeter ces propositions, à les revoir ou à identifier l'expérience suivante nécessaire pour les distinguer.
Le résultat pourrait être moins de suggestions séduisantes et davantage de travail réussi. Un étalon qui ne compterait que la nouveauté pourrait ne pas récompenser cette amélioration. Un étalon qui suivrait les propositions jusqu'à la mise en œuvre serait plus informatif.
L'hypothèse a une limite importante. Un modèle entraîné sur le mauvais environnement peut rejeter une idée inhabituelle parce qu'il prédit mal. Il peut aussi faire paraître sûre, à l'intérieur de sa propre simulation, une proposition défectueuse. La valeur réelle vient de prédictions qui restent étalonnées lorsqu'elles sont vérifiées à l'aune de conséquences extérieures au modèle.
Nous pouvons énoncer une épreuve discriminante. Maintenir aussi constants que possible le modèle de langage, l'accès aux sources et le budget de recherche. Ajouter, dans une condition, une composante prédictive de modèle du monde. Comparer si les idées qu'elle a sélectionnées perdent moins de leur valeur apparente après une épreuve externe. Mesurer séparément la nouveauté des propositions. Une amélioration de la faisabilité ou de la qualité du résultat, sans plus grande nouveauté, appuierait le mécanisme proposé.
Cela n'exclut pas des améliorations dans l'engendrement d'idées. De meilleures représentations peuvent révéler des possibilités qui étaient auparavant difficiles à exprimer. Cela dit que la capacité d'un système à écarter une erreur séduisante peut avoir autant de valeur économique que sa capacité à suggérer une autre option inhabituelle.
Une diversité améliorée n'est pas non plus exclusivement une question d'architecture de modèle. Le document de travail de Luo et de ses collègues, en 2026, examine des méthodes pour soutenir des réponses variées pendant des recherches ouvertes. Ses résultats rapportés sont propres aux procédures et aux mesures évaluées. Il donne une raison d'éprouver l'organisation de la recherche, plutôt que de traiter la répétition d'une session de dialogue comme un plafond immuable.26
Le déplacement plus profond consiste à passer de la question de savoir si une machine peut sonner inventive à celle de savoir comment le processus complet produit une nouveauté justifiée et utile. Ce processus comprend la génération, la sélection, les preuves externes et la révision.
10. Combien de temps l'avantage allégué durera
Il n'y a pas une seule horloge, parce que l'affirmation combine plusieurs seuils. Pour faire naître des idées candidates utiles dans le cadre d'une commande large, le seuil a déjà été franchi dans des cadres documentés. Pour trouver des solutions nouvelles et vérifiables dans un problème de recherche formel, il y a aussi des preuves. Pour une initiative intellectuelle fiable dans des circonstances humaines peu familières, les preuves restent incomplètes.
Il serait donc trompeur d'offrir une date à laquelle l'IA devient pour la première fois créative. Des sens différents du mot produisent des dates différentes, et certaines des capacités pertinentes sont déjà présentes. Un modèle peut s'améliorer à engendrer des propositions tout en restant faible à choisir la proposition qui mérite une année de travail.
Le seuil futur plus exigeant impliquerait un système qui remarque de façon répétée des anomalies importantes, choisit des questions qui en valent la peine, propose des explications non triviales, les éprouve hors de sa distribution familière et révise son programme lorsque les preuves sont en désaccord. La réussite devrait durer d'un cas à l'autre, avec une évaluation indépendante et un dossier des échecs aussi bien que des réussites sélectionnées.
Les preuves publiques examinées ici ne fournissent pas une année fiable pour cette capacité complète. Le programme d'AMI identifie des ingrédients à étudier, et non un compte à rebours validé. Les preuves en faveur d'une approche n'excluent pas non plus des hybrides ou d'autres voies.
Mon jugement pratique est néanmoins clair : je ne construirais pas une stratégie autour de plusieurs années encore de possession humaine exclusive d'idées qui en valent la peine. Cette exclusivité est déjà une prémisse trop forte. J'investirais dans la capacité de choisir des problèmes importants, d'obtenir l'accès aux preuves pertinentes, d'éprouver des propositions à peu de frais et de reconnaître qu'une théorie séduisante a échoué.
Cela ne rend pas une personne créative moins précieuse par définition. Un développement moins coûteux peut rendre davantage d'idées humaines dignes d'être poursuivies. Il peut aussi rendre des idées concurrentes moins coûteuses à engendrer pour tous les autres. L'équilibre dépend de la tâche, des preuves disponibles et des coûts qui demeurent. On ne peut pas dériver de l'affirmation universelle sur le seul attribut humain le plus précieux à partir du prix de la génération de texte.
Pour quelqu'un qui construit des entreprises, la question utile est de savoir où un jugement particulier change le résultat. Cela peut tenir à la compréhension d'une contrainte tacite d'un client, à la reconnaissance d'une occasion techniquement faisable, à l'obtention d'une coopération, au refus d'une distraction séduisante ou à la persévérance dans une expérience qui paraît d'abord décevante.
Ces capacités peuvent comprendre la créativité, l'expertise, le goût et la responsabilité. Les traiter comme une catégorie protégée dans laquelle l'IA ne peut pas entrer risque de confondre un avantage pratique actuel avec une frontière permanente.
11. Une épreuve dont nous ne maîtrisons pas l'issue
L'affirmation précise sur l'idée antérieure touchant le capitalisme ne peut pas être éprouvée proprement maintenant. Son mécanisme central est déjà dans la conversation. Une démonstration qui le reproduirait après cette exposition n'établirait pas une origine indépendante.
Une épreuve prospective équitable emploierait de nouvelles situations. Préparer des dossiers factuels sans y inclure l'interprétation souhaitée. Thierry consigne en privé ses hypothèses les plus fortes avant que le modèle voie le matériau. De nouvelles sessions de modèle reçoivent les mêmes dossiers et une demande large d'identifier un mécanisme conséquent et négligé. La conclusion humaine et les analogies directrices restent exclues.
Fixer le nombre d'hypothèses soumises et conserver chaque tentative. Enregistrer le temps écoulé, les versions de modèle, l'accès aux sources, l'effort de recherche et d'examen. Comparer une proposition humaine avec la meilleure de milliers de tentatives de modèle restées cachées répondrait à une autre question que de comparer une performance ordinaire sous un budget déclaré.
Des évaluateurs indépendants devraient juger les propositions sans en connaître l'origine. La nouveauté, la puissance explicative, la cohérence factuelle, la valeur pratique et la réfutabilité appartiennent à des échelles distinctes. Les recherches de travaux antérieurs devraient suivre un processus documenté. Une hypothèse plausible peut mériter l'attention même si un argument plus ancien contient sa structure centrale, mais la nouveauté historique doit alors être décrite avec honnêteté.
Une seconde piste devrait évaluer le choix du problème. Donner aux deux participants une collection mélangée d'observations, sans nommer la question. Demander ce qui mérite d'être étudié, pourquoi cela compte et quelles preuves changeraient l'interprétation proposée. Cela éprouve davantage que la capacité de répondre à une question fournie.
Les propositions les plus prometteuses devraient affronter une épreuve par les faits ou une mise en œuvre limitée. Employer la même procédure de sélection dans chaque condition et inclure, si les moyens le permettent, quelques propositions choisies au hasard. Autrement, une présentation impressionnante peut décider quelles idées auront jamais la chance de se prouver.
Les conditions avec des humains seuls, avec l'IA seule et en collaboration devraient rester distinctes. Répartir les cas et les participants de manière à contrôler l'exposition antérieure. Si la même personne revient à un dossier avec l'IA, le rapporter comme une extension successive, avec un temps cumulé, plutôt que comme une comparaison indépendante. Une collaboration peut surpasser l'un et l'autre participant sans montrer que l'un n'a fait aucune contribution originale. La provenance devrait indiquer quels concepts étaient présents dans l'entrée, lesquels sont apparus plus tard et lesquels ont survécu à l'examen.
Pour les modèles du monde, une comparaison supplémentaire ajouterait la composante prédictive en maintenant les autres conditions aussi stables que possible. Si les familles de modèles, les données, les outils et les budgets d'échantillonnage changent tous à la fois, une amélioration ne peut pas être attribuée spécifiquement au modèle du monde.
Le protocole qui l'accompagne est une proposition pour un tel essai. Il n'a pas été mené. Il ne contient pas de scores inventés et n'affirme pas qu'un petit échantillon pourrait établir un avantage permanent. Son objet est de rendre clair quelle observation changerait l'avis de l'un ou l'autre participant.
Une synthèse utile engendrée par un modèle, dont le mécanisme central était absent de l'entrée et qui aurait survécu à l'examen des travaux antérieurs, mettrait en cause l'affirmation selon laquelle la réponse centrale doit être fournie à nouveau par un humain. L'absence dans la consigne, à elle seule, n'établirait pas une nouveauté historique et n'exclurait pas le rappel d'un argument existant. Des avantages humains répétés en matière de portée, d'étalonnage ou de résultats appuieraient une affirmation plus étroite et plus instructive. Un échec sur une collection limitée de cas établirait une limitation dans ces conditions, et non un théorème d'impossibilité.
12. Ce qui reste digne d'être défendu
Votre affirmation première protège quelque chose de réel : un esprit vif peut remarquer ce que d'autres manquent. Il peut relier des événements distants, interroger un cadre accepté et reconnaître une possibilité avant que quiconque ait préparé une description de tâche bien rangée. Cette contribution mérite un examen attentif.
Les preuves n'appuient pas que l'on donne aux humains la propriété exclusive de chaque part de cette contribution. Les systèmes d'IA peuvent engendrer des propositions centrales et parfois produire des solutions vérifiablement nouvelles. Leurs limites concernent la fiabilité, le jugement, la diversité, l'ancrage et une capacité d'agir soutenue, en combinaisons variables. L'origine dans une machine, à elle seule, ne dit pas quelle contribution elle peut apporter.
La définition plus exigeante d'un esprit de valeur comprend la volonté de revoir sa propre idée séduisante. Le premier argument sur le capitalisme est devenu plus fort lorsqu'il a accepté des limites : les coûts économiques ne rendent pas les décisions impossibles, les actionnaires étrangers ne garantissent pas l'accès, et des institutions opposables comptent. La créativité était présente dans la liaison d'ouverture et dans les changements faits après l'examen.
C'est aussi pourquoi une réplique invitée est une forme utile pour ce volume. Demander à un système de contredire crée une occasion de correction. Cela ne prouve pas que le système aurait ouvert l'enquête sans l'invitation. La commande et la contribution peuvent toutes deux être consignées avec exactitude.
Dans la Bibliothèque, Le travail entre les prompts demande des preuves observables qu'un travail a été mené à terme. What You Get from AI mesure des résultats acceptés, avec l'examen et les reprises qu'ils ont exigés. La même discipline appartient en amont, au point où les propositions se disputent l'attention. Une idée n'a pas gagné sa valeur du seul fait d'avoir suscité de l'enthousiasme.2728
Les modèles du monde peuvent améliorer ce processus en rendant les conséquences proposées plus éprouvables avant l'action. Ils peuvent aussi contribuer à des représentations d'où naissent de meilleures idées. Ni l'une ni l'autre possibilité ne tranche l'origine de propos qui en valent la peine, ni la question de l'expérience subjective.
L'affirmation que je peux défendre contre vous est donc précise : les humains n'ont plus de prétention exclusive à faire naître des pensées candidates utiles. L'affirmation que je ne peux pas établir est que l'IA actuelle remplace de façon fiable toute la pratique humaine de remarquer, de choisir, d'éprouver, de se soucier et de prendre ses responsabilités.
L'épreuve future devrait rester ouverte. Si une machine fournit une bonne idée, nous devrions pouvoir en reconnaître la contribution. Si un humain voit la question importante que la machine manque, nous devrions pouvoir montrer où se trouve la différence. Un esprit de valeur gagne sa place par ce travail, et non par une définition qui empêche d'emblée un rival de jamais se qualifier.
Évaluation des affirmations de départ
| Affirmation | Évaluation | Motif |
|---|---|---|
| Une IA ne peut qu'élaborer l'idée centrale fournie par un humain | Rejetée comme affirmation absolue | Des études et des systèmes de découverte comprennent des propositions centrales et des solutions vérifiées qui n'étaient pas fournies dans la consigne. |
| L'IA reçoit des tâches et des buts des humains | Souvent vrai, mais insuffisant | Une question fournie n'est pas nécessairement une réponse fournie ; il faut consigner l'étayage réel. |
| Aucune IA ne peut produire une excellente idée nouvelle | Trop large pour être soutenue | Certaines contributions sont nouvelles et utiles ; une réussite exceptionnelle et ouverte est une épreuve plus forte. |
| L'expérience humaine compte pour le jugement créatif | Forte et pertinente | La biographie et les conséquences influencent le choix du problème ; la nécessité pour tout résultat créatif n'est pas prouvée. |
| Une proposition nouvelle établit une recherche de valeur | Rejetée | L'examen des résultats peut modifier substantiellement l'évaluation ; la qualité et la diversité diffèrent. |
| Les modèles du monde pourraient améliorer le travail créatif | Plausible, avec des preuves partielles | La prédiction et la planification s'améliorent dans des cadres bornés ; les gains de résultats créatifs exigent des épreuves directes. |
| AMI fournira la percée décisive à une date connue | Non établi | Un programme crédible et des résultats techniques ne fournissent ni calendrier validé, ni voie exclusive. |
| La créativité est la seule capacité la plus précieuse | Jugement dépendant du contexte | La valeur dépend aussi de la sélection, des preuves, de l'exécution, de l'accès, de la confiance et de la responsabilité. |
Méthode et périmètre
Il s'agit d'une contre-argumentation invitée, et non d'une expérience contrôlée ni d'une évaluation indépendante de l'assistant qui l'écrit. L'hypothèse de départ sur le capitalisme et le défi de la créativité ont été fournis par Thierry Gilgen dans cette conversation. L'article sépare la synthèse personnellement originale de la priorité historique documentée, les notes de propositions des résultats mis en œuvre, et la performance créative de la capacité d'agir et de l'expérience subjective. Les articles primaires et les descriptions officielles de projets sont préférés ; les preprints et les déclarations d'entreprises sont étiquetés. Les dates des modèles et des expériences sont distinguées des dates de publication. La figure empirique reproduit des notes moyennes publiées, sans inventer d'intervalles d'incertitude. Elle compare des propositions à des examens ultérieurs de projets, et non les mêmes informations évaluées deux fois. Le texte officiellement indexé a été utilisé pour les tableaux d'exécution définitifs de l'ICLR 2026, lorsque le téléchargement direct du PDF a rencontré un contrôle d'accès. L'essai proposé et l'hypothèse selon laquelle les modèles du monde amélioreraient le rejet n'ont pas été éprouvés ici. La date limite des preuves est le 15 novembre 2026.
Pour aller plus loin dans la Bibliothèque
- Ce que coûte la fermeture au monde : l'hypothèse de départ sur la retenue commerciale, examinée dans le volume précédent.
- Le travail entre les prompts : des preuves observables qu'un travail a été mené à terme.
- What You Get from AI : des résultats acceptés, y compris l'examen et les reprises qu'ils ont exigés.
Sources
Les sources ont été vérifiées le 15 novembre 2026. Chaque note numérotée porte son identifiant de source (S01–S28).
Notes et sources
-
Runco and Jaeger, The Standard Definition of Creativity. 10 février 2012. doi.org. (Source S01) ↩
-
Margaret Boden, Creativity and Artificial Intelligence. 1997. ijcai.org. (Source S02) ↩
-
Montesquieu, The Spirit of Laws, livre 20, chapitres 1–8. 1748. press-pubs.uchicago.edu. (Source S03) ↩
-
Immanuel Kant, On Perpetual Peace: A Philosophical Sketch. 1795 ; traduction d'Ian Johnston, mars 2012. web.viu.ca. (Source S04) ↩
-
Albert Hirschman, The Passions and the Interests: Political Arguments for Capitalism before Its Triumph. Princeton University Press, 1977 ; notice de réédition, 6 octobre 2013. press.princeton.edu. (Source S05) ↩
-
Si and colleagues, Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers. ICLR 2025 ; premier preprint le 6 septembre 2024. proceedings.iclr.cc. (Source S06) ↩
-
Mathematical discoveries from program search with large language models. Nature, 14 décembre 2023 (en ligne) ; 2024, volume 625. www.nature.com. (Source S10) ↩
-
Google DeepMind, AlphaEvolve: A coding agent for scientific and algorithmic discovery. 16 juin 2025. arxiv.org. (Source S11) ↩
-
Towards end-to-end automation of AI research. Nature, 25 mars 2026. www.nature.com. (Source S12) ↩
-
Si and colleagues, The Ideation–Execution Gap: Execution Outcomes of LLM-Generated versus Human Research Ideas. ICLR 2026 ; premier preprint le 25 juin 2025. openreview.net. (Source S07) ↩
-
Terwiesch and colleagues, Artificial intelligence and its impact on creativity and diversity: An empirical study of large language model-generated product ideas. Production and Operations Management, 22 juillet 2026. journals.sagepub.com. (Source S08) ↩
-
Doshi and Hauser, Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 12 juillet 2024. www.science.org. (Source S09) ↩
-
A large-scale comparison of divergent creativity in humans and large language models. Nature Human Behaviour, 23 décembre 2025 (en ligne) ; mars 2026, volume 10. www.nature.com. (Source S28) ↩
-
Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task. ICLR 2023 ; preprint le 24 octobre 2022, révision le 26 juin 2024. arxiv.org. (Source S13) ↩
-
Vafa and colleagues, Evaluating the World Model Implicit in a Generative Model. NeurIPS 2024 ; preprint le 6 juin 2024, révision le 10 novembre 2024. arxiv.org. (Source S14) ↩
-
Butlin and colleagues, Identifying indicators of consciousness in AI systems. Trends in Cognitive Sciences, 10 novembre 2025 (en ligne) ; juin 2026, volume 30, numéro 6. doi.org. (Source S25) ↩
-
AMI Labs, Real World. Real Intelligence. À jour lors de la consultation, 15 novembre 2026. amilabs.xyz. (Source S15) ↩
-
Yann LeCun, A Path Towards Autonomous Machine Intelligence. 27 juin 2022, version 0.9.2. openreview.net. (Source S16) ↩
-
V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning. Soumis le 15 mars 2026, révisé le 11 juin 2026. arxiv.org. (Source S17) ↩
-
H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning. Soumis le 5 octobre 2026, révisé le 1er novembre 2026. arxiv.org. (Source S18) ↩
-
Randall Balestriero and Yann LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs. 29 octobre 2026. arxiv.org. (Source S19) ↩
-
Danijar Hafner, Wilson Yan and Timothy Lillicrap, Training Agents Inside of Scalable World Models. 29 septembre 2025. arxiv.org. (Source S20) ↩
-
Google DeepMind, Genie 4: A new generation of world simulation. 27 octobre 2026. deepmind.google. (Source S21) ↩
-
World Labs, Atlas: Releasing our next generation world model. 12 novembre 2026. worldlabs.ai. (Source S22) ↩
-
Nanyang Technological University, College of Computing and Data Science, Are world models the future of AI? Insights from Distinguished Speaker Yann LeCun and CCDS faculty. Conférence le 3 novembre 2026 ; compte rendu le 6 novembre 2026. www.ntu.edu.sg. (Source S23) ↩
-
Luo, King, Puett and Smith, Inducing Sustained Creativity and Diversity in Large Language Models. Version de document de travail, 30 octobre 2026. gking.harvard.edu. (Source S24) ↩
-
Thierry Gilgen, The Work Between the Prompts. 2 octobre 2026 ; édition 5, 11 novembre 2026. www.thierry-gilgen-ict.ch. (Source S26) ↩
-
Thierry Gilgen, What You Get from AI. 16 octobre 2026, édition 3. www.thierry-gilgen-ict.ch. (Source S27) ↩