La question
Comment une organisation peut-elle tirer parti de services cloud exploités par des professionnels, tout en gardant la capacité de travailler lorsque ces services tombent en panne ?
Instantané de l'incident : communications de Microsoft émises vers 14 h 00 (CET) le 13 novembre 2026. L'incident était alors toujours en cours. Ce volume ne prétend établir ni une durée finale ni une cause finale.
1. Le matin où le chemin habituel s'est fermé
La boîte de réception se réduit à une animation de chargement. Impossible d'ouvrir l'agenda. Quelqu'un envoie un message pour demander si tout le monde a le même problème, par un canal qui partage peut-être la même dépendance.
La première tâche est de repérer ce qui fonctionne encore. La seconde est de décider quel travail ne peut pas attendre.
Le 12 novembre 2026, Microsoft a consigné le début d'un incident Exchange Online à 17 h 17 (CET). Ses communications du lendemain décrivaient une reprise progressive selon les régions, avec des problèmes d'accès intermittents et des courriels retardés. L'étendue technique était inégale : la plupart des fonctions centrales de Teams (appels, réunions, discussions) restaient disponibles, tandis que les opérations dépendant d'Exchange étaient touchées ; l'accès direct aux fichiers SharePoint fonctionnait. Aucune cause finale n'avait été publiée dans le relevé d'incident consulté.1
Les effets sur les affaires étaient réels. Workhorse a annoncé qu'elle repoussait du 12 au 16 novembre la publication de ses résultats trimestriels et sa conférence téléphonique, en attribuant explicitement ce report à la perturbation causée par la panne de Microsoft. C'est une conséquence documentée, sans qu'il faille la thèse bien plus large selon laquelle chaque entreprise touchée aurait perdu l'accès à toutes ses données.2
Le débat public transforme vite de tels épisodes en verdicts sur les achats. Ceux dont les services fonctionnent décrivent la bonne décision qu'ils ont prise. Ceux dont les services sont en panne remettent en question l'abonnement qu'ils ont souscrit. D'autres annoncent que tout le problème disparaîtrait si chacun exploitait ses propres serveurs.
Chacune de ces réactions part de quelque chose de compréhensible. Une solution de rechange qui marche est utile. Une interruption coûteuse mérite examen. Le contrôle local peut compter énormément. L'erreur commence quand on demande à une seule observation de trancher une question beaucoup plus vaste.
Ne pas être touché par un incident donné établit seulement que cette panne précise n'a pas arrêté votre travail à ce moment-là. Cela n'établit ni votre probabilité d'interruption sur une année, ni l'indépendance de vos dispositifs de reprise, ni votre capacité à quitter le service plus tard.
Il y a ici de la place pour une défense honnête des grands fournisseurs. Il y a aussi de la place pour une critique sérieuse des dépendances qu'ils créent. Les deux arguments appartiennent à la même analyse.
2. Quatre neuf, c'est une affirmation précise
Les discussions sur la fiabilité contiennent souvent des chiffres qui servent davantage de compliments. On dit d'un service qu'il a « quatre neuf » parce qu'il fonctionne en général, et parce que l'écart entre 99,9 et 99,99 paraît mince sur le papier.
Cet écart est un facteur dix sur la part de temps où le service est indisponible.
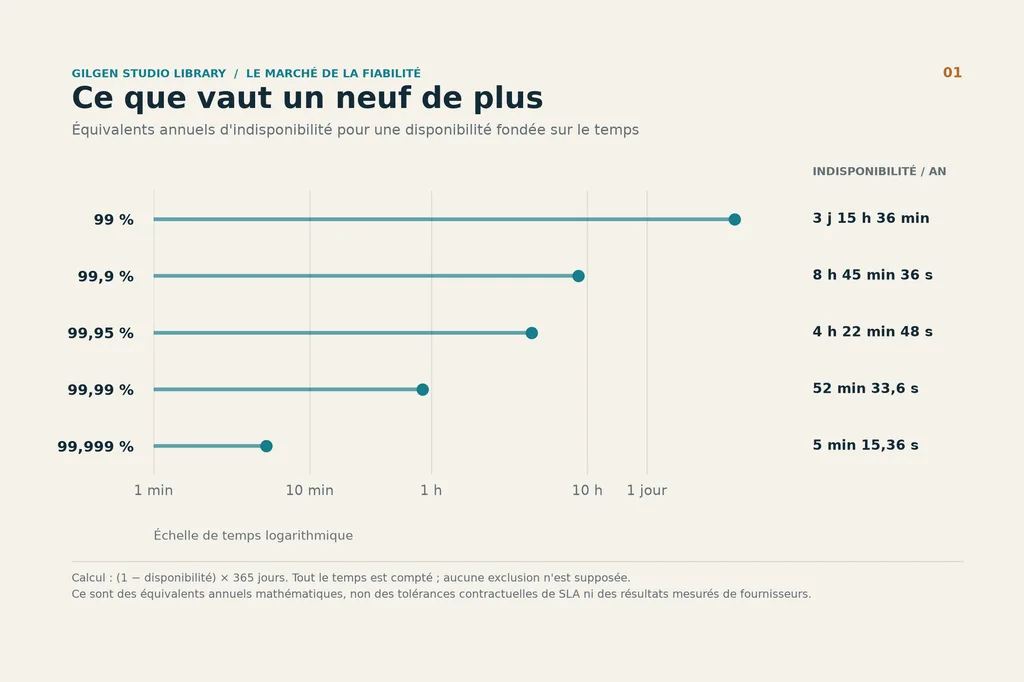
Pour une mesure simple, fondée sur le temps, d'un service ou d'une fonction définis, la disponibilité est la période mesurée moins l'indisponibilité, divisée par la période mesurée. Avec une année de 365 jours et un mois de 30 jours, on obtient les équivalences mathématiques suivantes. Ce sont des calculs, non la description d'un contrat particulier.
| Disponibilité | Indisponibilité équivalente sur 30 jours | Indisponibilité équivalente sur 365 jours |
|---|---|---|
| 99 % | 7 h 12 min | 3,65 jours |
| 99,9 % | 43 min 12 s | 8 h 45 min 36 s |
| 99,95 % | 21 min 36 s | 4 h 22 min 48 s |
| 99,99 % | 4 min 19,2 s | 52 min 33,6 s |
| 99,999 % | 25,92 s | 5 min 15,36 s |
Supposons qu'un service subisse une panne complète de 24 heures et aucune autre interruption. Dans l'année qui contient cette panne, sa disponibilité fondée sur le temps est de 99,7260 %. Si l'on répartit cette seule journée sur cinq ans, la moyenne est de 99,9452 %. Sur dix ans, elle est de 99,9726 %.
Pour atteindre en moyenne 99,99 %, une journée complète d'indisponibilité devrait être séparée de la suivante par environ 27,4 ans de fonctionnement sans la moindre interruption. Une bonne décennie ne rend pas une panne d'une journée compatible avec une promesse annuelle de quatre neuf. Elle ne répare pas non plus un engagement mensuel : cette panne de 24 heures représenterait une disponibilité de 96,6667 % sur un mois de 30 jours.
Il faut ajouter une réserve tout aussi importante. Un incident signalé comme ayant duré une journée peut toucher différents utilisateurs à différents moments, ou seulement certaines fonctions. Sa durée affichée ne peut pas être traitée d'office comme une journée entière d'indisponibilité pour chaque client et chaque fonction.
Les deux formes de précision sont nécessaires. Il faut corriger les assurances exagérées sans gonfler la panne.
3. La promesse, la mesure et la journée de travail
Trois questions se confondent facilement en une seule : que promet le contrat, qu'a mesuré le fournisseur, et que pouvait réellement faire le client ?
Un SLA définit un engagement de service et les conséquences s'il n'est pas tenu. Un SLO est un objectif opérationnel. Un SLI est la mesure qui sert à juger la performance. La littérature de Google sur la fiabilité fait elle-même ces distinctions, et souligne l'importance de mesurer l'expérience qui compte pour les utilisateurs.3
Les contrats pertinents sont plus précis que le nom d'un fournisseur.
| Service ou configuration | Engagement mensuel retenu | Limite qui compte |
|---|---|---|
| Microsoft Exchange Online | Seuil de crédit à 99,9 % | Disponibilité définie du courrier ; minutes d'utilisateurs touchés |
| Google Workspace, services couverts | 99,9 % | Condition d'erreur définie de l'interface web, au niveau du domaine |
| AWS EC2, instance unique | 99,5 % | Connectivité de l'instance, avec exclusions contractuelles |
| AWS EC2, déploiement qualifié sur plusieurs zones de disponibilité | 99,99 % | Indisponibilité simultanée du déploiement qualifié |
| Google Compute Engine, multizone, Premium Tier, hors Stockholm | 99,99 % | Perte de connectivité ou d'accès aux disques sur toutes les instances en fonctionnement concernées |
Sources : versions anglaises en vigueur du SLA de Microsoft, du SLA de Google Workspace, du SLA AWS Compute et du SLA de Google Compute Engine, consultées le 13 novembre 2026. Ces lignes illustrent des périmètres contractuels différents ; elles ne constituent pas un classement des fournisseurs. Google Compute Engine comporte des exceptions supplémentaires selon l'offre, la famille d'instances et la région.4567
Le SLA anglais de Microsoft d'octobre 2026 prévoit, pour Exchange Online, le service Teams désigné et SharePoint Online, des paliers de crédit qui commencent en dessous de 99,9 %. Les définitions de service diffèrent, et les crédits n'indemnisent ni le chiffre d'affaires perdu ni les pertes opérationnelles. Google Workspace s'engage lui aussi sur 99,9 % de disponibilité mensuelle pour les services couverts, selon sa propre définition du taux d'erreur et ses propres conditions de crédit.45
Un crédit de service est une vraie responsabilité contractuelle. Il ne rattrape pas une échéance manquée, ne recrée pas une occasion de marché perdue et ne fait pas disparaître une file de travail inachevé. La continuité d'activité doit traiter ces conséquences séparément.
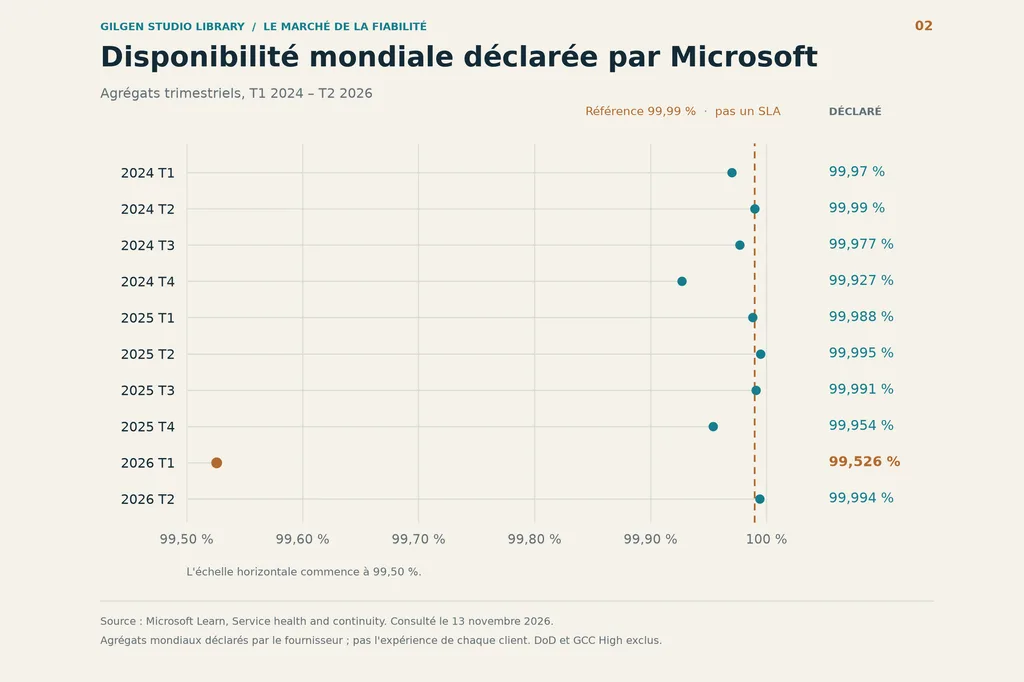
La performance observée est encore une autre catégorie de preuve. Le tableau mondial publié par Microsoft indique 99,927 % pour le quatrième trimestre 2024, 99,954 % pour le quatrième trimestre 2025, 99,526 % pour le premier trimestre 2026 et 99,994 % pour le deuxième trimestre 2026. Ce sont des agrégats déclarés par le fournisseur, avec des exclusions de périmètre indiquées ; ils ne sont ni un audit indépendant ni l'expérience de chaque locataire. La page actuelle ne précise pas entièrement la méthode d'agrégation. Ils réfutent néanmoins l'idée d'un plancher universel de 99,99 %.8
Google a par ailleurs affirmé, dans une annonce commerciale d'octobre 2025, une disponibilité de 99,99 % de Workspace pour la partie écoulée de 2025. C'est une déclaration datée d'un éditeur, non une comparaison actuelle et auditée avec les données de Microsoft, présentées autrement.9
Le client a besoin d'une mesure de plus : un employé autorisé peut-il accomplir la tâche importante, avec l'appareil, le réseau, les identifiants, l'application et les contreparties réellement en jeu ? Un tableau de bord du fournisseur au vert et un processus métier inutilisable peuvent coexister.
4. Le plaidoyer honnête en faveur de l'exploitation professionnelle
L'argument le plus fort en faveur des services gérés tient au travail qui doit se faire en continu pour qu'un système reste fiable.
Quelqu'un doit surveiller la capacité, entretenir le matériel, évaluer les correctifs, renouveler les certificats, tester la reprise, traiter les changements ratés, couvrir les absences, examiner les alertes et préserver les connaissances nécessaires quand l'administrateur d'origine s'en va. Ces obligations existent que le matériel se trouve dans un bureau, dans un centre de données suisse ou dans la région d'un hyperscaler.
Un grand fournisseur peut répartir l'exploitation spécialisée, la capacité de réserve et l'investissement d'ingénierie entre de nombreux clients. Cela donne une raison économique d'attendre de solides compétences qu'une petite organisation aurait du mal à financer seule. C'est un argument sur les ressources et la conception de l'exploitation, non la preuve que chaque service cloud surpasse chaque système interne.
La documentation de Microsoft sur la fiabilité décrit des installations et des réseaux redondants, des mises à jour contrôlées, des capacités de reprise et un partage des responsabilités qui change selon qu'il s'agit de logiciel, de plateforme ou d'infrastructure. Elle laisse aussi aux clients la responsabilité de choisir et de configurer les fonctions de fiabilité pertinentes et de concevoir leurs charges de travail en conséquence.10
Cette distinction compte quand on dit être passé au cloud. Acheter un service de messagerie géré ne transfère pas les mêmes responsabilités que louer une machine virtuelle et y installer un serveur de messagerie. Ce dernier cas exige encore une administration importante. Un problème de maintenance inchangé peut survivre à un changement d'adresse d'hébergement.
L'inquiétude au sujet des correctifs et du matériel négligés a un fondement légitime. Le NIST traite la gestion des correctifs comme une maintenance préventive et un coût permanent de l'activité. Son processus comprend la priorisation et la vérification, et non l'instruction d'installer chaque changement aussitôt, sans en examiner les conséquences.11
La recherche du secteur va aussi dans le sens de la discipline opérationnelle. Dans l'enquête 2025 de l'Uptime Institute, 87 % des 98 répondants ayant répondu à la question pertinente après une panne grave estimaient qu'une meilleure gestion, de meilleurs processus ou une meilleure configuration auraient pu l'éviter. C'est un jugement rétrospectif d'un sous-ensemble d'un échantillon sectoriel hétérogène, non la part mesurée de toutes les pannes imputables à des administrateurs internes négligents.12
Une analyse de l'Uptime d'octobre 2026 a relevé moins de pannes signalées dans les installations dotées d'une plus grande redondance d'alimentation et de refroidissement. Elle a expressément précisé que cette relation ne pouvait pas être séparée de la maturité opérationnelle, de la maintenance, de l'état du matériel et d'autres choix de conception.13
Les preuves appuient la question de savoir qui fera le travail et comment il sera financé. Elles n'appuient pas l'accusation d'incompétence portée contre toute une catégorie d'exploitants.
Une équipe interne expérimentée, suffisamment dotée, avec des besoins bien délimités, des installations redondantes et une reprise exercée, peut exploiter une excellente infrastructure. Une application cloud mal conçue peut tomber souvent en panne. Un prestataire régional compétent en services gérés est une autre option. Ranger tout cela en deux camps cache les choix qui déterminent réellement le résultat.
5. Pourquoi un multiplicateur universel entre cloud et sur site ne tient pas
Une comparaison crédible exigerait la même charge de travail, la même limite de service, la même période de mesure, la même définition de la panne et le même niveau d'impact sur l'activité. Elle devrait aussi distinguer la maintenance planifiée de l'interruption imprévue et tenir compte des architectures et des effectifs comparés.
Sans ces contrôles, il est facile de comparer la disponibilité d'un composant d'un fournisseur avec celle de tout l'environnement de travail d'une entreprise. Ou de comparer le registre public des incidents d'une plateforme mondiale avec des pannes locales qui ne font jamais l'actualité. Aucune de ces comparaisons n'établit un avantage de disponibilité d'une ampleur donnée.
Les recherches examinées pour ce volume n'ont pas trouvé d'étude contemporaine et représentative qui appuie l'affirmation universelle selon laquelle une infrastructure autogérée serait moins disponible d'un facteur fixe. Ce constat laisse place à des avantages considérables dans des cas particuliers ; il empêche de présenter ces cas comme un rapport valable pour toute la population.
Le résumé public de l'Uptime sur les pannes de 2026 illustre le problème du dénominateur. Environ deux tiers des pannes signalées publiquement dans son relevé de neuf ans impliquaient des fournisseurs tiers, une catégorie qui regroupe les entreprises du cloud et de l'internet, les télécommunications et la colocation. Le même résumé fait état d'une fréquence de pannes par site en baisse. Le nombre d'incidents visibles et le taux par site répondent à des questions différentes. Aucun des deux chiffres ne fournit un classement automatique du cloud et de l'exploitation interne.14
Même au sein des grands clouds, l'architecture et l'emplacement influencent le résultat. L'Uptime a modélisé les effets possibles des rapports d'incident des fournisseurs pour 2024 sur 116 régions. Dans la zone la plus touchée, il a estimé environ 25 heures d'indisponibilité pour une application sur une seule zone, environ dix avec deux zones et cinq avec deux régions. C'étaient des expositions modélisées prudemment, incluant d'éventuels sous-ensembles et des effets sur le plan de contrôle, et excluant les défaillances du système d'exploitation ou du code applicatif. Ce n'étaient pas des résultats mesurés pour chaque client.15
C'est un constat plus utile que de proclamer une catégorie d'hébergement supérieure en toutes circonstances. L'infrastructure offre des capacités ; l'application et le mode d'exploitation déterminent lesquelles deviennent une protection effective.
Une comparaison d'achat concrète demande donc : quel service cette organisation peut-elle réellement maintenir pendant les prochaines années, week-ends, rotation du personnel, renouvellement du matériel et exercice de reprise compris ? On ne devrait pas comparer le système interne imaginaire, parfaitement entretenu, au pire jour d'un fournisseur réel. De même, on ne devrait pas comparer le meilleur chiffre commercial d'un fournisseur à l'installation interne la moins compétente dont quelqu'un se souvienne.
6. Une excellente fiabilité moyenne peut concentrer la panne
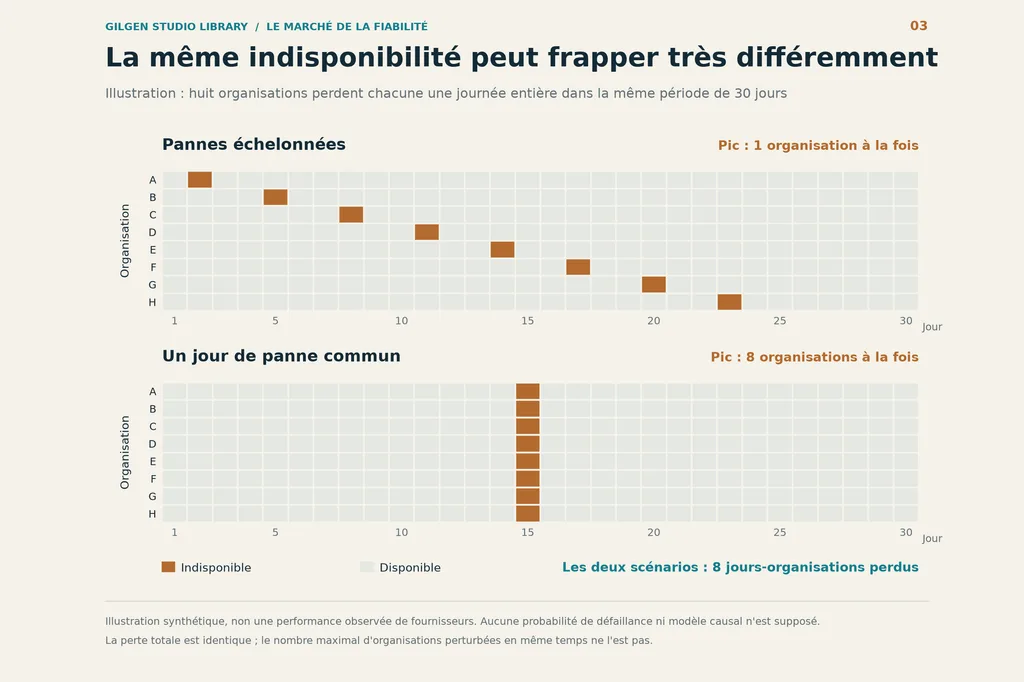
Imaginez huit organisations. Chacune perd un jour de service au cours d'une période de 30 jours. Dans le premier scénario, les pannes tombent des jours différents. Dans le second, les huit tombent le même jour.
Le total est identique : huit jours-organisations d'interruption. Chaque organisation a la même disponibilité fondée sur le temps dans les deux scénarios. Le nombre maximal d'organisations incapables de travailler en même temps passe de un à huit.
C'est une illustration, non une mesure de fournisseurs réels. Elle montre ce qu'une moyenne omet.
Quand les pannes coïncident, le client, la banque, le fournisseur et le conseil d'une entreprise peuvent être entravés en même temps. Un système interne qui fonctionne ne peut pas forcer une contrepartie indisponible à répondre. Les entreprises de dépannage et les canaux d'assistance peuvent faire face à une demande simultanée. Des échéances critiques peuvent tomber alors que tout le monde cherche une autre voie.
C'est pourquoi la panne d'un grand fournisseur peut mériter l'attention du public même si le service touché fonctionne d'ordinaire très bien. L'interruption concentre les désagréments et peut concentrer les dommages financiers ou opérationnels. Le même nombre de minutes perdues peut avoir des conséquences différentes selon le moment où elles surviennent, la durée de la plus longue interruption et le nombre d'autres acteurs en panne au même moment.
Le rapport annuel 2025 de la FINMA aborde directement cette distinction. Il avertit que la dépendance croissante à l'égard des grands fournisseurs de cloud public peut provoquer des défaillances simultanées dans plusieurs établissements financiers, compromettre des fonctions critiques et, dans un cas extrême, menacer la stabilité des marchés financiers. C'est un avertissement sur une exposition concentrée, non l'affirmation que les services cloud tombent nécessairement plus souvent en panne que les systèmes internes.16
La défense des fournisseurs a donc une limite. Une forte disponibilité au quotidien peut justifier l'achat d'un service. Elle ne peut pas justifier de tenir pour négligeables les conséquences de sa défaillance.
Une organisation devrait examiner au moins son interruption totale, son interruption la plus longue et sa capacité à fonctionner pendant une perturbation partagée. Ces mesures décrivent des aspects différents du risque. Un pourcentage annuel ne peut pas faire les trois tâches à la fois.
7. La dépendance sous le logo
Diversifier les fournisseurs peut réduire l'exposition à l'un d'eux. Que cela produise une solution de rechange qui fonctionne dépend des dépendances sous-jacentes.
L'incident de Google de juin 2025 est instructif. Un chemin de code défectueux dans Service Control a été activé par un changement de politique qui s'est propagé à l'échelle mondiale. L'impact a touché plusieurs produits de Google Cloud et de Workspace. La répartition régionale n'a pas empêché un mécanisme de contrôle partagé de propager la défaillance.17
Le rapport d'incident de Cloudflare pour la même date décrit la défaillance d'un stockage tiers sur lequel repose Workers KV. Les services dépendant de KV ont été perturbés, tandis que des produits comme le DNS, le proxy et le WAF n'étaient pas touchés directement. Le rapport ne nomme pas le fournisseur de stockage. Le mécanisme suffit à établir le point : un service peut hériter d'une dépendance qui n'apparaît pas dans la marque que le client a achetée.18
L'incident d'AWS en Virginie du Nord en octobre 2025 a commencé par une situation de concurrence (race condition) dans la gestion DNS de DynamoDB, puis s'est propagé aux services dépendants et aux processus de reprise. L'impact n'a pas été la perte de toutes les régions AWS ni de toutes les machines virtuelles en fonctionnement. Les réplicas DynamoDB d'autres régions pouvaient encore répondre aux requêtes, tandis que la réplication impliquant la région touchée accusait du retard.19
Ces exemples montrent des mécanismes, non des taux de défaillance égaux. Ils n'établissent ni que tous les fournisseurs sont interchangeables ni que changer de fournisseur est inutile. Ils montrent pourquoi le choix du fournisseur doit s'accompagner d'une compréhension de l'étendue de la défaillance.
Demandez de quoi la solution de repli a besoin avant de pouvoir servir à quoi que ce soit. Utilise-t-elle le même service d'identité ? Ses codes de récupération sont-ils accessibles ? Un administrateur de secours a-t-il besoin d'une boîte aux lettres chez le fournisseur en panne pour réinitialiser l'accès ? Les fichiers sont-ils vraiment stockés en local, ou ne sont-ce que des espaces réservés qui se téléchargent à l'ouverture ? Le téléphone d'urgence peut-il passer un appel sans le service de collaboration ? Le portail d'administration de l'alternative dépend-il de la même passerelle réseau ?
Ce sont des questions d'ingénierie. Un deuxième abonnement ne peut pas y répondre à lui seul.
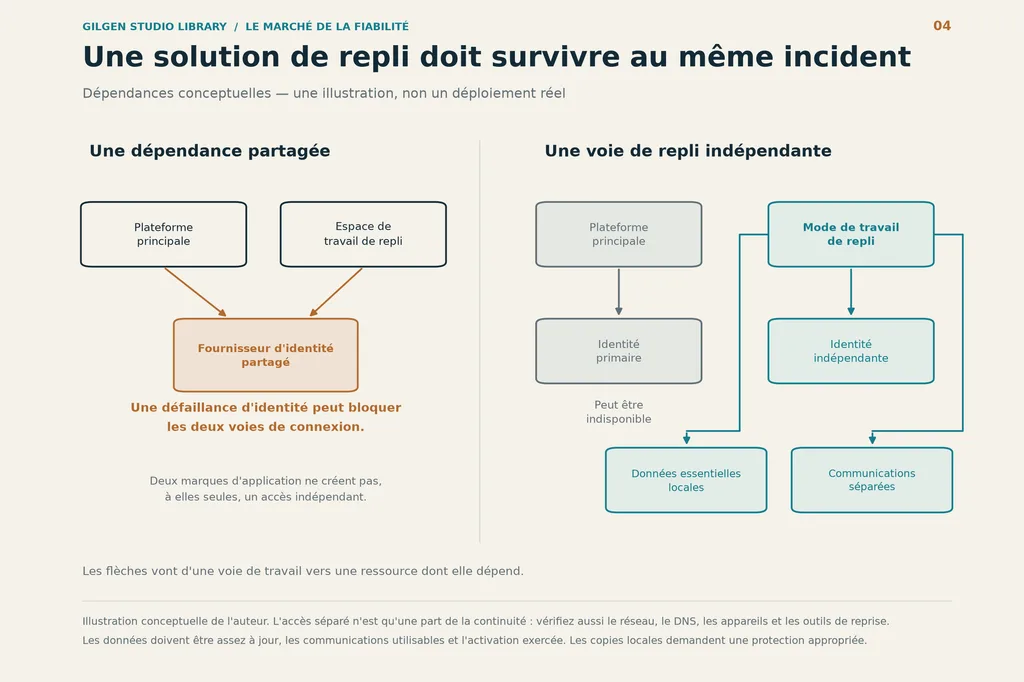
Les consignes SRE de Google mettent expressément en garde contre le calcul de la disponibilité de déploiements redondants comme si leurs pannes étaient automatiquement indépendantes. Des plans de contrôle partagés, des domaines de défaillance et d'autres dépendances communes peuvent invalider ce calcul.20
La même rigueur s'applique à l'exploitation de systèmes en local. Une application locale peut encore exiger une authentification dans le cloud, des clés de chiffrement détenues à l'extérieur, une licence à distance, une connexion internet ou un service d'administration hébergé. Posséder la machine répond à une autre question que celle de savoir si elle reste utilisable pendant la défaillance d'un fournisseur.
8. Un deuxième environnement et un service de substitution
Un cabinet de conseil peut raisonnablement choisir de garder son travail interne sur une plateforme et d'en utiliser une autre pour les projets de ses clients. Pendant une panne dans l'environnement du client, son propre agenda, ses documents et sa coordination peuvent rester disponibles. Cette séparation peut ménager une marge de manœuvre utile.
Elle ne transfère pas automatiquement le service du client dans l'environnement du consultant. Un éditeur de documents interne qui fonctionne ne peut pas recréer des autorisations manquantes, récupérer des fichiers qui n'ont jamais été copiés, recevoir le courrier du client ni reproduire son processus de validation.
Les deux affirmations peuvent être vraies : la séparation était précieuse, et le processus métier a quand même besoin d'un dispositif de continuité.
Cela explique aussi la différence entre choisir Google comme fournisseur principal et préparer Google comme solution de repli pour un autre fournisseur principal. Google documente désormais des offres Workspace pour la continuité d'activité, dont des formules de secours à froid et de secours à chaud. Leur existence prouve qu'une alternative peut être préparée délibérément ; elle ne prouve pas que toute organisation disposant de deux comptes bénéficie déjà d'une protection équivalente.21
Pour certaines entreprises, une deuxième plateforme de collaboration sera proportionnée. Pour d'autres, elle ajoute une charge d'exploitation sans résoudre la défaillance la plus importante. La synchronisation peut créer d'autres dépendances. Deux systèmes d'autorisations demandent de l'administration. Les utilisateurs ont besoin de formation. Les enregistrements créés pendant un incident doivent être rapprochés. L'alternative peut être trop coûteuse à tenir prête à l'échelle nécessaire.
La décision devrait suivre la tâche critique. Si le besoin immédiat est de joindre dix clients, de consulter une liste à jour des engagements et de consigner des décisions pendant quelques heures, un dossier d'information hors ligne protégé et une voie de communication indépendante approuvée peuvent offrir plus de capacité utile qu'une suite dupliquée vaguement configurée.
Si le besoin est de soutenir un grand processus réglementé pendant plusieurs jours, les exigences seront différentes. La capacité, la fraîcheur des données, la confidentialité, la tenue des enregistrements et les procédures de reprise deviennent alors centrales dans la conception.
Choisissez l'alternative qui peut soutenir le travail requis, et mesurez l'effort nécessaire pour la maintenir prête.
9. Pour la défense du recours ordinaire
Le téléphone et le fax sont une matière facile à plaisanterie lors d'une panne du cloud. La technologie semble avoir fait marche arrière juste au moment où l'organisation espérait qu'elle devienne invisible.
L'âge est un mauvais critère pour savoir si un recours remplit son rôle.
Les consignes du NIST sur la planification de la contingence comptent le traitement manuel temporaire parmi les moyens de poursuivre des activités perturbées. C'est la reconnaissance d'un mode de fonctionnement limité, non l'approbation de tout bricolage improvisé.22
Un appel téléphonique peut préserver une conversation essentielle. Une liste sur papier peut préserver les obligations du lendemain. Une file manuelle préparée à dessein peut empêcher que des demandes urgentes se perdent. Les questions sont : la voie est-elle disponible, les participants peuvent-ils être vérifiés, le processus est-il autorisé, le volume est-il gérable et ses résultats peuvent-ils être rapprochés ensuite ?
Un service de fax acheminé par la même infrastructure cloud en panne ne résoudrait pas la dépendance en cause. Pas davantage un canal non approuvé qui crée un problème de confidentialité ou de conservation des enregistrements. Ce qui compte, c'est sa capacité à soutenir la tâche requise dans les conditions réelles de la panne.
Les observations de la FCA de novembre 2026 font une distinction semblable. Elle critique le recours à des palliatifs manuels lorsque les entreprises n'ont pas montré qu'elles pouvaient fonctionner à l'échelle ou pendant la durée requises. Elle attire aussi l'attention sur des éléments montrant que la communication peut fonctionner quand les canaux habituels sont indisponibles. Ce qui importe, c'est la capacité démontrée.23
Pendant cet incident de Microsoft, le NHS Essex a annoncé une ligne téléphonique temporaire pour les orientations de professionnels et les demandes urgentes concernant des patients, tant que les services de courriel étaient perturbés. C'est un exemple concret de canal de remplacement mis au travail.24
Il est raisonnable d'attendre des institutions modernes qu'elles investissent dans la reprise. Il est tout aussi raisonnable que leur mode d'urgence paraisse plus simple que leur mode normal. Un recours a gagné sa place lorsqu'il préserve les résultats essentiels dans des limites acceptables.
La sauvegarde la plus embarrassante est la plus impressionnante, celle que personne ne sait activer.
10. Le travail qui reste quand le fournisseur revient
Le rétablissement du service et la reprise de l'activité ne coïncident pas forcément.
Supposons qu'une organisation puisse se reconnecter à midi. Il peut rester des messages retardés, des demandes en double, des validations inachevées, des états de transaction incertains et des enregistrements créés par d'autres voies. Le personnel doit établir quelles actions ont abouti, lesquelles doivent être refaites et lesquelles ne doivent surtout pas l'être.
C'est pourquoi un plan de continuité a besoin d'un chemin de retour. Lancer un processus de remplacement n'est qu'une partie de la tâche. L'organisation doit conserver assez de preuves pour rapprocher le travail en toute sécurité quand le service normal reprend.
Elle doit aussi distinguer l'interruption de la perte ou de l'altération d'informations. La réplication peut améliorer la disponibilité tout en copiant fidèlement une modification erronée. Une sauvegarde peut préserver des données antérieures tout en étant trop longue à restaurer pour l'échéance du moment. Un export peut être lisible tout en omettant les autorisations ou les métadonnées dont le processus a besoin.
Voici donc des questions utiles :
- Quelle interruption ce processus métier peut-il supporter avant que les conséquences deviennent inacceptables ?
- Dans cette limite, à quelle vitesse faut-il rétablir le système ou le mode de fonctionnement minimal ?
- Quel âge peuvent avoir les informations disponibles, et quelle quantité de travail récent irrécupérable est acceptable ?
- À quel volume et pendant combien de temps la solution de repli peut-elle fonctionner ?
- Qui décide de l'activer, qui est suppléant, et qui confirme le rapprochement ?
Le cadre de continuité du NIST distingue l'interruption maximale tolérable, les objectifs de temps de reprise et les objectifs de point de reprise. Ces notions aident les responsables métier à préciser ce que les dispositifs techniques doivent accomplir.25
Pour une panne, un export récent et une voie de remplacement préparée peuvent suffire. En cas de soupçon d'altération, le même export peut être risqué à utiliser. Face à la perte de l'accès contractuel ou juridique à un fournisseur, attendre quelques heures n'est peut-être pas une réponse crédible. Un schéma de reprise unique ne devrait pas masquer ces scénarios différents.
La feuille de travail pratique à la fin de ce volume transforme ces questions en un petit exercice. Le but est de découvrir une vraie lacune alors qu'il est encore temps de la combler.
11. La souveraineté a un coût d'exploitation
La disponibilité, la sécurité, la capacité de reprise et la souveraineté sont liées, mais aucune ne peut se substituer à toutes les autres.
La disponibilité demande si une fonction définie peut être utilisée quand on en a besoin. La capacité de reprise demande si l'information et l'exploitation peuvent être rétablies après une perturbation. La sécurité inclut la protection du système et de l'information contre l'usage abusif ou la compromission. La souveraineté concerne l'autorité et la capacité pratique de maîtriser les dépendances, de changer de cap et de soutenir des alternatives crédibles.
Un fournisseur peut très bien fonctionner au quotidien tout en créant des contraintes juridiques ou stratégiques qu'une institution juge inacceptables. Un système détenu localement peut offrir un contrôle direct plus grand tout en manquant du personnel ou de la résilience nécessaires pour remplir ses obligations de service. Ce sont des combinaisons possibles, non des contradictions.
C'est pourquoi un argument de souveraineté n'a pas besoin d'une affirmation exagérée sur la fiabilité. Une organisation peut raisonnablement accepter un autre coût ou un autre mode d'exploitation pour obtenir un contrôle auquel elle tient. Elle devrait énoncer clairement cet arbitrage, financer les responsabilités qui en découlent et mesurer le service qu'elle reçoit.
L'inverse est tout aussi important. Une décision d'externaliser peut être responsable si elle améliore le service que l'organisation peut réellement soutenir. Garder la responsabilité, c'est alors comprendre ce qui a été délégué, préserver l'accès aux informations essentielles et maintenir des capacités proportionnées de reprise et de sortie.
Les principes de résilience opérationnelle du Comité de Bâle traitent de la gestion des dépendances envers des tiers, des dispositifs de continuité, des stratégies de sortie et de la substituabilité pratique, y compris la possibilité de ramener un service en interne. Ce sont des capacités opérationnelles à évaluer, non des conclusions que fournirait la nationalité d'un fournisseur.26
La décision pertinente est plus large que celle de posséder ou non un serveur. Elle inclut qui peut approuver un changement, qui peut exploiter un remplacement, où se trouvent les informations nécessaires, quelles dépendances juridiques et techniques subsistent, et si l'alternative peut devenir utilisable dans le temps disponible.
Cette capacité peut être construite en interne, obtenue auprès d'un prestataire de services gérés compétent, ou répartie entre plusieurs dispositifs. Elle exigera toujours une attention continue. Un plan de sortie devient moins utile quand le personnel, les formats et les procédures nécessaires pour l'exécuter ont disparu.
Les volumes précédents de la Bibliothèque sur l'autosuffisance et sur le test de sortie examinent cette capacité stratégique. Ce volume ajoute une épreuve plus immédiate : quel travail utile survit à la prochaine interruption ?
12. La fiabilité peut nous faire oublier la reprise
Il y a une dernière complication. La fiabilité peut elle-même encourager la dépendance excessive.
Le livre SRE de Google raconte comment son service très fiable, Chubby, a vu s'accrocher à lui des systèmes qui supposaient en pratique qu'il ne tomberait jamais en panne. Google a introduit des pannes contrôlées pour mettre ces hypothèses au jour. L'exemple montre comment de longues périodes de réussite peuvent laisser s'éroder la capacité de reprise, même chez des ingénieurs chevronnés.3
La leçon pour une organisation ordinaire est d'exercer une solution de repli limitée dans un cadre contrôlé. Ce n'est pas une raison de surprendre les utilisateurs en coupant des systèmes de production. Un exercice sur table convenu, suivi d'un test pratique soigneusement borné, peut révéler des identifiants inaccessibles, des listes de contacts périmées, des fichiers locaux manquants et des pouvoirs de décision non tranchés, sans fabriquer de crise.
Cela change la question que l'on pose après la prochaine panne. Il y aura encore des raisons d'examiner la performance du fournisseur. Il y aura encore des débats légitimes sur l'architecture, les contrats, la concurrence et la souveraineté. Un incident coûteux mérite un compte rendu précis de ses causes et de ses conséquences.
À côté de ces questions, l'organisation peut en poser une qui relève de son propre pouvoir : quelles tâches essentielles avons-nous préservées, lesquelles ont échoué, et que changerons-nous avant le prochain événement ?
Un fournisseur compétent peut réduire la quantité d'infrastructure qu'une organisation doit exploiter. Il ne peut pas décider des obligations que l'organisation doit honorer pendant une interruption. Il ne peut pas rendre utilisable une solution de repli jamais testée du simple fait de reprendre son service. Il ne peut pas préserver un choix que le client a laissé disparaître.
Le marché de la fiabilité vaut la peine d'être conclu quand les responsabilités restantes sont comprises et financées. Achetez un bon service au quotidien. Gardez l'information, l'autorité et les alternatives exercées dont vous aurez besoin aux moments où il tombe en panne.
La bonne mesure, c'est le travail qui peut encore être fait.
Annexe : Pouvons-nous continuer à travailler ?
Un exercice de continuité pour une petite société suisse de services professionnels
Feuille de travail · 13 novembre 2026 · Durée suggérée : 60 à 90 minutes
Société/équipe : ____________________ Date de l'exercice : ____________________
Responsable métier : ____________________ Animation : ____________________
Participants et suppléants : __________________________________________________
L'objectif est de démontrer quels résultats critiques la société peut encore fournir lorsque son principal service de collaboration ou d'identité est indisponible. Choisissez deux ou trois processus. Parmi les exemples : informer les clients, vérifier les engagements en cours, accéder aux dossiers essentiels et préparer un travail urgent. Séparez la préparation des transactions ou validations qui exigent des contrôles indisponibles.
Les durées et les champs ci-dessous sont des pratiques proposées, non des seuils réglementaires. La FINMA relève la concentration dans les services externalisés comme source de perturbations simultanées. Les observations de la FCA de novembre 2026 insistent sur la preuve de dispositifs de continuité qui fonctionnent et de canaux de communication testés.1623
1. Définir ce qui doit continuer
Remplissez ce tableau avant de parler de produits. « Le courriel est en panne » décrit un système ; « nous ne pouvons pas prévenir les clients d'une échéance urgente » désigne une conséquence pour l'activité.
| Processus critique | Responsable / suppléant | Mode de fonctionnement minimal utile | Interruption maximale tolérable | Âge maximal des données de repli | Preuve de capacité | Lacune / responsable de l'action |
|---|---|---|---|---|---|---|
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
Pour chaque processus, consignez :
- Tolérance d'impact : à partir de quand l'interruption cause-t-elle un préjudice inacceptable ? Incluez, le cas échéant, les engagements manqués, les clients touchés, les valeurs ou volumes de transactions.
- Objectif de temps de reprise (RTO) : en combien de temps le service requis doit-il être rétabli et validé ? Prévoyez le temps d'évaluation, d'activation et de vérification avant d'atteindre l'interruption maximale tolérable.
- Objectif de point de reprise (RPO) : quelle quantité d'informations validées pourrait être perdue après la reprise, exprimée si utile sous forme d'intervalle de temps ?
- Fraîcheur des données de repli : quel âge la copie accessible peut-elle avoir ? Une liste de contacts clients périmée et une position de portefeuille périmée n'ont pas les mêmes conséquences. C'est une question distincte de celle de la perte de données récupérable.
Capacité dégradée acceptée : ______ dossiers par heure, pendant ______ heures, avec ______ personnes.
Activités qui doivent être suspendues : __________________________________________________
2. Mener l'exercice sur table
| Durée | Discussion ou défi | Résultat attendu |
|---|---|---|
| 0–10 min | Confirmer les processus critiques, les rôles et les limites d'interruption. | Tableau des processus rempli ; décideur désigné. |
| 10–25 min | Les principaux services de courriel, de messagerie instantanée et de documents deviennent indisponibles. Le fournisseur ne donne aucune estimation fiable de reprise. | Premières actions, priorités clients et décision d'activer la solution de repli. |
| 25–45 min | Les nouvelles connexions échouent aussi. L'administrateur habituel est indisponible. Un document clé n'existe que comme espace réservé dans le cloud. | Voie d'accès démontrée ; réaction du suppléant ; éléments inaccessibles consignés. |
| 45–65 min | Un client demande une action urgente. Plusieurs collègues ont besoin de la solution de repli en même temps. | Communication approuvée, vérification d'identité, estimation de capacité et journal d'activité. |
| 65–80 min | Les services principaux reviennent. Le personnel a pris des décisions ou préparé du travail ailleurs. | Responsable du rapprochement, étapes de validation et prévention des actions en double. |
| 80–90 min | Examiner les preuves et décider de ce qu'il faut améliorer. | Actions attribuées, échéances et risques résiduels acceptés. |
Pour une séance de 60 minutes, raccourcissez la discussion du scénario ; conservez la démonstration de l'accès et l'examen de la reprise. Ne présentez pas une estimation de reprise optimiste du fournisseur comme la preuve que la société peut continuer.
3. Retracer tout le chemin de repli
Pour chaque alternative proposée, répondez à la question « Pouvons-nous l'utiliser si la connexion au fournisseur principal échoue ? » Consignez des preuves, pas seulement le nom d'un fournisseur.
| Dépendance | Vérification | Preuve / lacune non résolue |
|---|---|---|
| Identité et MFA | Connexion autorisée indépendante ; méthode de récupération disponible ; le suppléant peut utiliser ses propres identifiants approuvés. | __________________ |
| Appareil | Les fichiers sont réellement téléchargés ; l'appareil chiffré peut être déverrouillé ; le lecteur et les licences nécessaires fonctionnent. | __________________ |
| Réseau et DNS | La connexion alternative est utilisable ; la résolution de noms nécessaire fonctionne ; les dépendances partagées critiques sont comprises. | __________________ |
| Documents et sauvegardes | Les dossiers requis sont lisibles ; la console de sauvegarde, les clés et les instructions de reprise restent accessibles. | __________________ |
| Communication | Le canal approuvé atteint le personnel et les clients ; la liste de contacts est accessible ; l'expéditeur et le destinataire peuvent être vérifiés. | __________________ |
| Personnes et capacité | Le suppléant connaît la procédure ; l'utilisation simultanée et la charge de travail soutenue sont réalisables. | __________________ |
Une copie de sauvegarde indépendante fournit du matériel de reprise ; elle n'établit pas que le personnel peut l'utiliser dans le délai requis. Une deuxième application SaaS peut encore dépendre du service d'identité d'origine, de la gestion des appareils ou d'un composant réseau partagé.
4. Changer le scénario avant de choisir la réponse
| Scénario de défaillance | Question et réponse appropriées |
|---|---|
| Service indisponible ; données présumées intactes | Quelles fonctions minimales approuvées peuvent continuer avec des copies accessibles et des canaux alternatifs ? Consigner le nouveau travail pour un rapprochement ultérieur. |
| Altération possible ou incident de sécurité | Quelles copies, quelles identités et quels appareils sont dignes de confiance ? Suivre les procédures d'incident, préserver les preuves et valider le matériel de reprise. La synchronisation automatique peut propager les dégâts. |
| Accès du fournisseur ou accès juridique retiré | La société peut-elle légalement récupérer et utiliser ailleurs les informations essentielles, avec les clés, les autorisations et les contrats nécessaires ? Un plan d'export et de migration doit être réalisable au-delà d'une panne temporaire. |
N'improvisez pas de validations de transactions, ne partagez pas d'identifiants et ne déplacez pas de documents confidentiels vers des comptes personnels. Consignez les demandes, les décisions, les horodatages, les personnes responsables et les confirmations dans le registre de repli approuvé. Définissez comment les enregistrements seront conservés et rapprochés du système principal.
Le NIST reconnaît le traitement manuel temporaire comme une option de continuité. La FCA prévient que les palliatifs manuels exigent la preuve d'une capacité et d'une endurance suffisantes.2322
5. Exercice d'accès borné, facultatif
Utilisez un appareil ou un compte de test désigné et un petit ensemble approuvé de dossiers de test non sensibles. Simulez l'absence du service principal en suivant une règle d'exercice qui interdit de l'utiliser. Cela démontre le processus, mais ne prouve pas à lui seul l'indépendance technique. Vérifiez séparément l'authentification et les chemins de données, y compris une connexion autorisée toute neuve et les exigences de renouvellement de session. Consignez les dépendances qui restent non testées. Ne désactivez pas l'identité de production, ne modifiez pas le DNS en service, ne révoquez pas d'accès réels et n'interrompez pas de services qui fonctionnent.
Demandez à un suppléant de retrouver les instructions, d'accéder à la solution de repli par la voie autorisée, d'ouvrir les dossiers de test et de saisir une demande fictive. Rétablissez ensuite les conditions normales de l'exercice et rapprochez cette demande dans un journal de test. Notez chaque dépendance pour laquelle l'animateur a dû aider. Un résultat obtenu par la seule discussion reste une hypothèse tant qu'il n'a pas été démontré.
Relevez le temps d'activation écoulé, les dossiers utilisables par rapport aux dossiers requis, l'âge des données, les connexions autorisées réussies, les demandes traitées, les entrées d'audit manquantes et le temps de rapprochement. Le responsable métier devrait comparer ces résultats aux exigences du processus choisi, plutôt qu'à une référence externe.
6. Décider quel investissement se justifie
Un dossier hors ligne protégé peut suffire lorsqu'un petit ensemble de documents relativement stable soutient un service temporaire acceptable et que le personnel peut le tenir à jour en sécurité. La diversification des fournisseurs devient plus attrayante lorsque l'activité a besoin de collaboration en direct, d'une capacité de transaction soutenue ou d'une reprise dans un délai que la solution de repli plus simple ne peut pas atteindre.
Avant d'acheter une autre plateforme, établissez son indépendance, l'actualité de ses données, ses contrôles d'accès, son coût d'exploitation et sa charge de rapprochement. Vérifiez que l'équipe peut exploiter les deux dispositifs. Les principes de résilience de Bâle soutiennent l'évaluation de substituts pratiques et de dispositifs de sortie pour les tiers critiques.26
Capacité démontrée : __________________________________________________
Hypothèses encore non testées : ________________________________________________
Actions / responsables / échéances : __________________________________________________
Risque résiduel accepté par / date de revue : ____________________________________
Note de recherche
La recherche a été achevée le 13 novembre 2026 à partir de rapports d'incident et de contrats de fournisseurs, de travaux de l'Uptime Institute, de recommandations du NIST et de documents de surveillance du secteur financier suisse et britannique. Les exemples d'incidents techniques illustrent des mécanismes de défaillance ; ils ne forment pas un classement comparatif des fournisseurs. L'analyse annuelle 2026 de l'Uptime a été consultée à travers son résumé public, non son rapport complet, d'accès payant. Aucun multiplicateur universel de disponibilité entre cloud et exploitation autogérée n'a été établi.
La description de l'incident de Microsoft est un instantané daté. Microsoft a indiqué qu'elle publierait un rapport post-incident complet une fois l'atténuation terminée ; ce rapport, et non cet instantané, fera foi pour la durée et la cause de l'incident.1 Ce volume ne contient aucune affirmation selon laquelle chaque utilisateur ou chaque fonction aurait été en panne pendant toute la période de l'incident. Les calculs et les figures synthétiques sont signalés comme tels.
Pour aller plus loin dans la Bibliothèque
- Le test de sortie : la capacité pratique de quitter une dépendance.
- La souveraineté n’est pas l’autosuffisance : maîtriser la dépendance tout en gardant sa capacité d'agir.
- Les dix premières minutes d'une panne fournisseur : la note existante sur ce qu'il faut faire d'abord quand un fournisseur tombe en panne.
Sources
Les sources ont été vérifiées le 13 novembre 2026. Chaque note numérotée porte son identifiant de source (S01–S28).
Figurent dans le registre des sources de l'auteur, mais ne sont pas citées dans le texte : S03 (Reuters, Hours-long Microsoft outage disrupts businesses governments globally, 12-13 novembre 2026, article en cours d'évolution, www.reuters.com); S16 (Google Cloud, 14 December 2020 authentication incident report, Rapport du 18 décembre ; correction du 22 décembre 2020, status.cloud.google.com).
Notes et sources
-
Microsoft via University of Pennsylvania, Microsoft incident reports EX1550543 and MO1550821. Mises à jour vers le 13 novembre 2026, 13 h 00 UTC. mailservices.isc.upenn.edu. (Source S01) ↩ ↩2
-
Workhorse Group, Workhorse Group postpones third quarter earnings release and conference call. 12 novembre 2026. ir.workhorse.com. (Source S02) ↩
-
Google SRE, Service Level Objectives. Chapitre du livre SRE, consulté le 13 novembre 2026. sre.google. (Source S23) ↩ ↩2
-
Microsoft, Service Level Agreement for Microsoft Online Services. 1er octobre 2026, dernière édition anglaise répertoriée. www.microsoft.com. (Source S05) ↩ ↩2
-
Google Workspace, Google Workspace Service Level Agreement. 31 août 2026. workspace.google.com. (Source S06) ↩ ↩2
-
Amazon Web Services, Amazon Compute Service Level Agreement. 25 mai 2022, page actuelle consultée le 13 novembre 2026. aws.amazon.com. (Source S07) ↩
-
Google Cloud, Compute Engine Service Level Agreement. 14 octobre 2026. cloud.google.com. (Source S08) ↩
-
Microsoft Learn, Service health and continuity. Tableau en ligne consulté le 13 novembre 2026 ; jusqu'au deuxième trimestre 2026. learn.microsoft.com. (Source S04) ↩
-
Google Workspace, Business continuity and transformation offerings announcement. 16 octobre 2025. workspace.google.com. (Source S26) ↩
-
Microsoft Learn, Shared responsibility for reliability. Consulté le 13 novembre 2026. learn.microsoft.com. (Source S22) ↩
-
NIST, SP 800-40 Rev 4 Guide to Enterprise Patch Management Planning. Avril 2022. csrc.nist.gov. (Source S21) ↩
-
Uptime Institute, Global Data Center Survey 2025. Juillet 2025 ; enquête d'avril à mai 2025. datacenter.uptimeinstitute.com. (Source S10) ↩
-
Uptime Institute, Survey findings link higher redundancy to lower outage risk. 14 octobre 2026. journal.uptimeinstitute.com. (Source S11) ↩
-
Uptime Institute, Annual Outage Analysis Report 2026 announcement. 13 mai 2026. connect.uptimeinstitute.com. (Source S09) ↩
-
Uptime Institute, Outage data shows cloud apps must be designed for failure. 9 avril 2025 ; analyse de 2024. journal.uptimeinstitute.com. (Source S12) ↩
-
FINMA, Annual Report 2025 measures for promoting stability. Rapport annuel 2025, consulté le 13 novembre 2026. Section sur les prestataires de services critiques et la concentration dans l'externalisation. report.finma.ch. (Source S17) ↩ ↩2
-
Google Cloud, Incident report for 12 June 2025. Rapport du 13 juin 2025 sur l'incident du 12 juin. status.cloud.google.com. (Source S13) ↩
-
Cloudflare, Cloudflare service outage June 12 2025. Juin 2025 ; incident du 12 juin 2025. blog.cloudflare.com. (Source S14) ↩
-
Amazon Web Services, Summary of the Amazon DynamoDB service disruption in Northern Virginia. Incident des 19-20 octobre 2025 (PDT). aws.amazon.com. (Source S15) ↩
-
Google SRE, Implementing SLOs. Chapitre du workbook SRE, consulté le 13 novembre 2026. sre.google. (Source S24) ↩
-
Google Workspace, Business Continuity. Documentation actuelle, consultée le 13 novembre 2026. knowledge.workspace.google.com. (Source S25) ↩
-
NIST, Contingency planning. Page thématique actuelle, consultée le 13 novembre 2026. Explique les approches de la SP 800-34 Rév. 1. csrc.nist.gov. (Source S19) ↩ ↩2
-
Financial Conduct Authority, Operational resilience demonstrating resilience in practice. 11 novembre 2026. Les observations concernent surtout les entreprises relevant du périmètre précisé de la FCA ; elles servent ici de preuve pratique, non d'énoncé d'obligations juridiques suisses. www.fca.org.uk. (Source S18) ↩ ↩2 ↩3
-
NHS Essex Integrated Care Board, Temporary disruption to NHS email services caused by global Microsoft outage. 13 novembre 2026. www.essex.icb.nhs.uk. (Source S28) ↩
-
NIST, SP 800-34 Rev 1 Contingency Planning Guide for Federal Information Systems. Mai 2010, mis à jour le 11 novembre 2010. csrc.nist.gov. (Source S20) ↩
-
Basel Committee on Banking Supervision, Operational resilience ORR20. Recommandations consolidées actuelles, consultées le 13 novembre 2026. Voir en particulier les paragraphes 20.29 à 20.31 sur les dépendances envers des tiers, la continuité et la substitution. www.bis.org. (Source S27) ↩ ↩2