Die Frage
Wie kann eine Organisation von professionell betriebenen Cloud-Diensten profitieren und trotzdem arbeitsfähig bleiben, wenn diese Dienste ausfallen?
Momentaufnahme des Vorfalls: Microsoft-Meldungen von etwa 14:00 Uhr MEZ am 13. November 2026. Der Vorfall war zu diesem Zeitpunkt noch offen. Dieser Band behauptet weder eine endgültige Dauer noch eine endgültige Ursache.
1. Der Morgen, an dem der gewohnte Weg nicht mehr ging
Das Postfach wird zur Ladeanimation. Der Kalender lässt sich nicht öffnen. Jemand schreibt eine Nachricht und fragt, ob es allen anderen auch so geht – über einen Kanal, der womöglich dieselbe Abhängigkeit hat.
Die erste Aufgabe ist festzustellen, was noch funktioniert. Die zweite ist zu entscheiden, welche Arbeit nicht warten kann.
Am 12. November 2026 hielt Microsoft den Beginn eines Exchange-Online-Vorfalls um 17:17 Uhr MEZ fest. Die Meldungen des folgenden Tages beschrieben eine fortschreitende Erholung in den Regionen, mit weiterhin unregelmässigen Zugriffsproblemen und verzögerter E-Mail. Der technische Umfang war ungleich: Die meisten zentralen Teams-Funktionen für Anrufe, Meetings und Chat blieben verfügbar, während Vorgänge, die von Exchange abhängen, betroffen waren; der direkte Zugriff auf SharePoint-Dateien funktionierte weiter. Eine endgültige Ursache war im abgerufenen Vorfallsprotokoll nicht veröffentlicht.1
Die geschäftlichen Folgen waren real. Workhorse gab bekannt, die Veröffentlichung der Quartalszahlen und die zugehörige Telefonkonferenz vom 12. auf den 16. November zu verschieben, und führte die Verschiebung ausdrücklich auf die Störung durch den Microsoft-Ausfall zurück. Das ist eine belegte Folge – ohne dass man die viel weitergehende Behauptung braucht, jedes betroffene Unternehmen habe den Zugriff auf alle seine Daten verloren.2
Die öffentliche Diskussion macht aus solchen Episoden schnell Urteile über die Beschaffung. Wer einen funktionierenden Dienst hat, beschreibt den guten Entscheid, den er getroffen hat. Wer einen ausgefallenen Dienst hat, stellt das gekaufte Abonnement infrage. Andere verkünden, das ganze Problem würde verschwinden, wenn jeder seine eigenen Server betriebe.
Jede dieser Reaktionen beginnt bei etwas Nachvollziehbarem. Eine funktionierende Alternative ist nützlich. Eine teure Unterbrechung verdient Prüfung. Lokale Kontrolle kann von grosser Bedeutung sein. Der Fehler entsteht, wenn eine einzelne Beobachtung eine viel grössere Frage entscheiden soll.
Von einem bestimmten Vorfall nicht betroffen zu sein, belegt nur, dass dieser eine Ausfall die eigene Arbeit in diesem Moment nicht gestoppt hat. Es belegt weder die eigene Unterbrechungswahrscheinlichkeit über ein Jahr, noch die Unabhängigkeit der eigenen Wiederherstellung, noch die Fähigkeit, den Dienst später zu verlassen.
Es gibt hier Raum für eine ehrliche Verteidigung der grossen Anbieter. Es gibt ebenso Raum für ernsthafte Kritik an den Abhängigkeiten, die sie schaffen. Beide Argumente gehören in dieselbe Analyse.
2. Vier Neunen sind eine genaue Aussage
In Gesprächen über Zuverlässigkeit stehen oft Zahlen, die eher wie Komplimente wirken. Ein Dienst gilt als «vier Neunen», weil er meistens läuft und weil der Unterschied zwischen 99,9 und 99,99 auf dem Papier klein aussieht.
Dieser Unterschied ist ein Faktor zehn beim Anteil der Zeit, in der der Dienst nicht verfügbar ist.
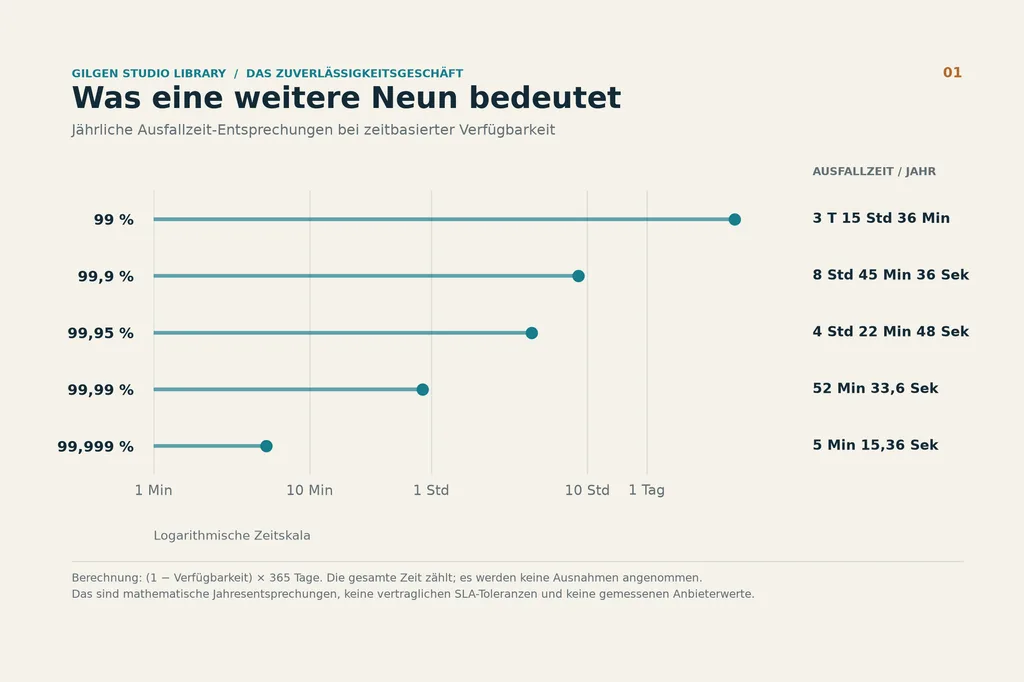
Für eine einfache zeitbasierte Messung eines definierten Dienstes oder einer definierten Funktion ist die Verfügbarkeit der Messzeitraum abzüglich der Ausfallzeit, geteilt durch den Messzeitraum. Mit einem Jahr zu 365 Tagen und einem Monat zu 30 Tagen ergeben sich die folgenden mathematischen Entsprechungen. Das sind Rechnungen, keine Beschreibung eines bestimmten Vertrags.
| Verfügbarkeit | Entsprechende Ausfallzeit in 30 Tagen | Entsprechende Ausfallzeit in 365 Tagen |
|---|---|---|
| 99 % | 7 Std. 12 Min. | 3,65 Tage |
| 99,9 % | 43 Min. 12 Sek. | 8 Std. 45 Min. 36 Sek. |
| 99,95 % | 21 Min. 36 Sek. | 4 Std. 22 Min. 48 Sek. |
| 99,99 % | 4 Min. 19,2 Sek. | 52 Min. 33,6 Sek. |
| 99,999 % | 25,92 Sek. | 5 Min. 15,36 Sek. |
Angenommen, ein Dienst erleidet einen vollständigen 24-Stunden-Ausfall und sonst keine einzige Unterbrechung. In dem Jahr, in dem dieser Ausfall liegt, beträgt seine zeitbasierte Verfügbarkeit 99,7260 %. Verteilt man diesen einen Tag auf fünf Jahre, liegt der Durchschnitt bei 99,9452 %. Auf zehn Jahre verteilt sind es 99,9726 %.
Um im Durchschnitt 99,99 % zu erreichen, müsste ein ganzer Ausfalltag von etwa 27,4 Jahren sonst ununterbrochenen Betriebs getrennt sein. Ein gutes Jahrzehnt macht einen tagelangen Ausfall nicht vereinbar mit einer jährlichen Vier-Neunen-Zusage. Es heilt auch keine Monatszusage: Dieser 24-Stunden-Ausfall bedeutete in einem Monat mit 30 Tagen eine Verfügbarkeit von 96,6667 %.
Ebenso wichtig ist eine Einschränkung. Ein gemeldeter Vorfall von einem Tag kann verschiedene Nutzerinnen und Nutzer zu verschiedenen Zeiten treffen oder nur bestimmte Funktionen. Seine Schlagzeilendauer lässt sich nicht automatisch als voller Ausfalltag für jeden Kunden und jede Funktion behandeln.
Beide Arten von Genauigkeit sind nötig. Wir sollten übertriebene Zusicherungen korrigieren, ohne den Ausfall aufzublasen.
3. Das Versprechen, die Messung und der Arbeitstag
Drei Fragen werden leicht zu einer einzigen verschmolzen: Was verspricht der Vertrag, was hat der Anbieter gemessen, und was konnte der Kunde tatsächlich tun?
Ein SLA legt eine Dienstzusage fest und die Folgen, wenn sie verfehlt wird. Ein SLO ist ein betriebliches Ziel. Ein SLI ist die Messgrösse, an der die Leistung beurteilt wird. Googles eigene Literatur zur Zuverlässigkeit unterscheidet diese Begriffe und betont, wie wichtig es ist, die Erfahrung zu messen, auf die es für die Nutzer ankommt.3
Die massgeblichen Verträge sind genauer als der Name eines Anbieters.
| Dienst oder Konfiguration | Ausgewählte Monatszusage | Massgebliche Abgrenzung |
|---|---|---|
| Microsoft Exchange Online | 99,9 % Gutschriftsschwelle | Definierte E-Mail-Verfügbarkeit; betroffene Nutzerminuten |
| Google Workspace, erfasste Dienste | 99,9 % | Definierter Fehlerzustand der Weboberfläche auf Domainebene |
| AWS EC2, einzelne Instanz | 99,5 % | Verbindung zur Instanz, mit vertraglichen Ausnahmen |
| AWS EC2, qualifizierende Bereitstellung über mehrere Availability Zones | 99,99 % | Gleichzeitige Nichtverfügbarkeit der qualifizierenden Bereitstellung |
| Google Compute Engine, mehrere Zonen, Premium Tier, ohne Stockholm | 99,99 % | Verlust von Verbindung oder Datenträgerzugriff bei allen betroffenen laufenden Instanzen |
Quellen: aktuelle englische Fassungen des Microsoft-SLA, des Google-Workspace-SLA, des AWS-Compute-SLA und des Google-Compute-Engine-SLA, geprüft am 13. November 2026. Diese Zeilen zeigen unterschiedliche vertragliche Geltungsbereiche; sie sind keine Rangliste der Anbieterleistung. Für Google Compute Engine gelten zusätzliche Ausnahmen nach Tarif, Instanzfamilie und Region.4567
Microsofts englisches SLA vom Oktober 2026 sieht für Exchange Online, den bezeichneten Teams-Dienst und SharePoint Online Gutschriftsstufen vor, die unterhalb von 99,9 % beginnen. Die Dienstdefinitionen unterscheiden sich, und die Gutschriften entschädigen weder für entgangenen Umsatz noch für betriebliche Verluste. Auch Google Workspace sagt für erfasste Dienste 99,9 % Monatsverfügbarkeit zu, nach eigener Fehlerraten-Definition und mit eigenen Gutschriftsbedingungen.45
Eine Service-Gutschrift ist eine echte vertragliche Verantwortlichkeit. Sie holt aber keine verpasste Frist zurück, schafft keine verlorene Marktchance wieder her und räumt keine Warteschlange unerledigter Arbeit ab. Die Kontinuitätsplanung muss diese Folgen gesondert behandeln.
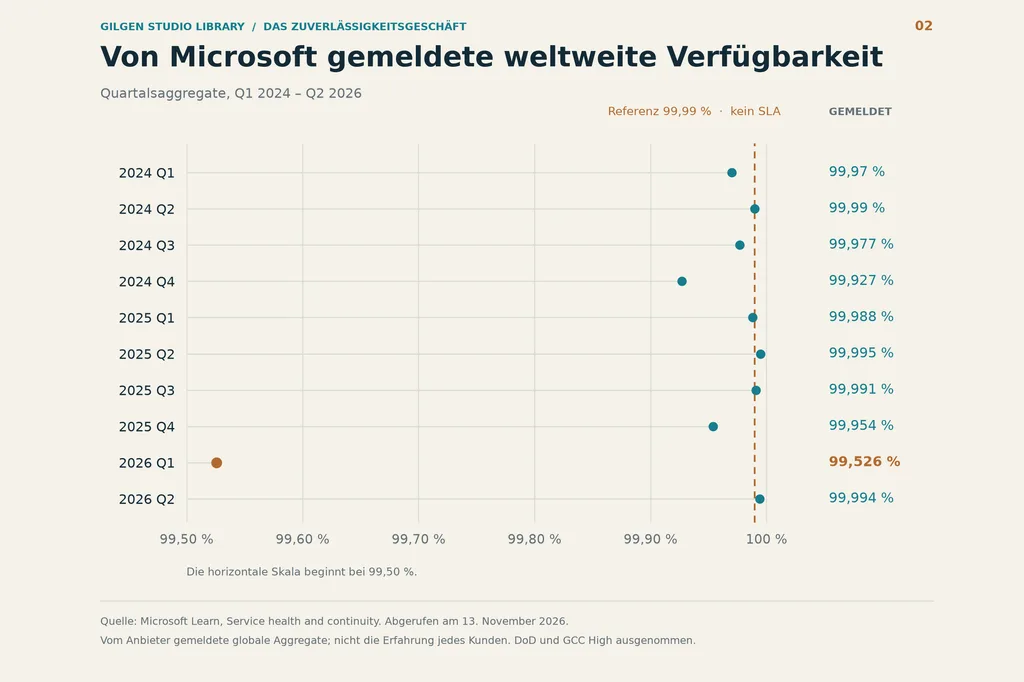
Beobachtete Leistung ist wieder eine andere Art von Beleg. Die von Microsoft veröffentlichte weltweite Tabelle weist 99,927 % für das vierte Quartal 2024, 99,954 % für das vierte Quartal 2025, 99,526 % für das erste Quartal 2026 und 99,994 % für das zweite Quartal 2026 aus. Das sind vom Anbieter gemeldete Aggregate mit angegebenen Ausnahmen beim Geltungsbereich; sie sind weder ein unabhängiges Audit noch die Erfahrung jedes einzelnen Mandanten. Die aktuelle Seite legt die Aggregationsmethode nicht vollständig offen. Dennoch widerlegen die Zahlen eine allgemeine Untergrenze von 99,99 %.8
Google hat in einer Marketingmitteilung vom Oktober 2025 zudem für den bis dahin verstrichenen Teil des Jahres 2025 eine Workspace-Verfügbarkeit von 99,99 % behauptet. Das ist eine datierte Herstellerbehauptung, kein aktueller, geprüfter Vergleich mit Microsofts anders dargestellten Daten.9
Der Kunde braucht eine weitere Messung: Kann eine berechtigte Mitarbeiterin die wichtige Aufgabe erledigen – mit dem tatsächlichen Gerät, Netz, den Zugangsdaten, der Anwendung und den Gegenparteien, um die es geht? Ein gesundes Dashboard des Anbieters und ein unbrauchbarer Geschäftsprozess können nebeneinander bestehen.
4. Der ehrliche Fall für den professionellen Betrieb
Das stärkste Argument für verwaltete Dienste betrifft die Arbeit, die laufend geschehen muss, damit ein System verlässlich bleibt.
Jemand muss Kapazität überwachen, Geräte warten, Patches bewerten, Zertifikate erneuern, die Wiederherstellung testen, misslungene Änderungen auffangen, Abwesenheiten abdecken, Warnungen untersuchen und das Wissen bewahren, das gebraucht wird, wenn der ursprüngliche Administrator geht. Diese Pflichten bestehen, ob die Technik nun in einem Büro, in einem Schweizer Rechenzentrum oder in der Region eines Hyperscalers steht.
Ein grosser Anbieter kann spezialisierten Betrieb, Reservekapazität und Entwicklungsinvestitionen auf viele Kunden verteilen. Das ist ein wirtschaftlicher Grund, starke Fähigkeiten zu erwarten, die eine kleine Organisation allein womöglich kaum finanzieren kann. Es ist ein Argument über Ressourcen und Betriebsdesign, kein Beweis dafür, dass jeder Cloud-Dienst jedes interne System übertrifft.
Microsofts Dokumentation zur Zuverlässigkeit beschreibt redundante Anlagen und Netze, kontrollierte Updates, Wiederherstellungsfähigkeiten und eine Aufteilung der Verantwortung, die sich zwischen Software-, Plattform- und Infrastrukturdiensten verschiebt. Sie macht auch die Kunden dafür verantwortlich, die massgeblichen Zuverlässigkeitsfunktionen auszuwählen und zu konfigurieren und ihre Arbeitslasten entsprechend zu entwerfen.10
Diese Unterscheidung zählt, wenn Leute sagen, sie seien in die Cloud umgezogen. Einen verwalteten E-Mail-Dienst zu kaufen, überträgt andere Pflichten, als eine virtuelle Maschine zu mieten und darauf einen E-Mail-Server zu installieren. Letzteres verlangt weiterhin erhebliche Administration. Ein unverändertes Wartungsproblem kann einen Wechsel der Hosting-Adresse überleben.
Die Sorge um vernachlässigte Patches und Geräte hat eine berechtigte Grundlage. Das NIST behandelt Patch-Management als vorbeugende Wartung und als fortlaufende Kosten des Geschäftsbetriebs. Der Prozess umfasst Priorisierung und Überprüfung und nicht die Anweisung, jede Änderung sofort einzuspielen, ohne die Folgen zu bedenken.11
Auch die Branchenforschung weist auf betriebliche Disziplin hin. In der Umfrage des Uptime Institute von 2025 waren 87 % der 98 Befragten, die die einschlägige Frage nach einem folgenreichen Ausfall beantworteten, überzeugt, dass besseres Management, bessere Prozesse oder eine bessere Konfiguration ihn hätten verhindern können. Das ist ein rückblickendes Urteil einer Teilgruppe aus einer gemischten Branchenstichprobe, nicht der gemessene Anteil aller Ausfälle, die auf nachlässige hauseigene Administratoren zurückgehen.12
Eine Analyse des Uptime Institute vom Oktober 2026 fand weniger gemeldete Ausfälle bei Anlagen mit grösserer Strom- und Kühlungsredundanz. Sie warnte ausdrücklich, dass sich dieser Zusammenhang nicht von der betrieblichen Reife, der Wartung, dem Zustand der Geräte und anderen Designentscheiden trennen lasse.13
Die Belege stützen die Frage, wer die Arbeit leisten und wie sie finanziert wird. Sie stützen nicht den Vorwurf der Inkompetenz an eine ganze Kategorie von Betreibern.
Ein erfahrenes internes Team mit ausreichender Besetzung, klar abgegrenzten Anforderungen, redundanten Anlagen und geübter Wiederherstellung kann hervorragende Infrastruktur betreiben. Eine schlecht entworfene Cloud-Anwendung kann oft ausfallen. Ein fähiger regionaler Managed-Service-Anbieter ist eine weitere Möglichkeit. Wer all das in zwei Lager einteilt, verdeckt die Entscheidungen, die das Ergebnis tatsächlich bestimmen.
5. Warum ein allgemeiner Faktor zwischen Cloud und Eigenbetrieb nicht trägt
Ein glaubwürdiger Vergleich bräuchte dieselbe Arbeitslast, dieselbe Dienstabgrenzung, denselben Messzeitraum, dieselbe Definition von Ausfall und dasselbe Mass an geschäftlicher Wirkung. Er müsste auch geplante Wartung von unerwarteter Unterbrechung trennen und die verglichenen Architekturen und Besetzungen berücksichtigen.
Ohne diese Kontrollen vergleicht man leicht die Verfügbarkeit einer Komponente eines Anbieters mit der Verfügbarkeit der gesamten Arbeitsumgebung eines Unternehmens. Oder man vergleicht die öffentliche Störungschronik einer globalen Plattform mit lokalen Ausfällen, die nie zu einer Nachricht werden. Keiner dieser Vergleiche belegt einen Verfügbarkeitsvorteil von bestimmter Grösse.
Die für diesen Band geprüfte Forschung hat keine aktuelle, repräsentative Studie gefunden, die die allgemeine Behauptung stützt, selbst betriebene Infrastruktur sei um einen festen Faktor weniger verfügbar. Dieser Befund lässt Raum für erhebliche Vorteile im Einzelfall; er verhindert, dass solche Einzelfälle als Verhältnis für die ganze Bevölkerung dargestellt werden.
Die öffentliche Ausfallübersicht des Uptime Institute für 2026 zeigt das Problem des Nenners. Etwa zwei Drittel der öffentlich gemeldeten Ausfälle in seinem neunjährigen Bestand betrafen Drittanbieter – eine Kategorie, die Cloud- und Internetfirmen, Telekommunikation und Colocation zusammenfasst. Dieselbe Übersicht verzeichnet eine sinkende Ausfallhäufigkeit pro Standort. Die Zahl sichtbarer Vorfälle und die Rate pro Standort beantworten verschiedene Fragen. Keine der beiden Zahlen liefert eine automatische Rangfolge von Cloud und internem Betrieb.14
Selbst innerhalb grosser Clouds beeinflussen Architektur und Platzierung das Ergebnis. Das Uptime Institute modellierte die möglichen Auswirkungen der Störungsberichte von Anbietern aus dem Jahr 2024 über 116 Regionen. In der am stärksten betroffenen Zone schätzte es für eine Anwendung in einer einzigen Zone rund 25 Stunden Ausfall, bei zwei Zonen etwa zehn und bei zwei Regionen etwa fünf. Das waren vorsichtig modellierte Gefährdungen, einschliesslich möglicher Teilmengen und Auswirkungen auf die Steuerungsebene, und ohne Fehler im Betriebssystem oder im Anwendungscode. Es waren keine Messergebnisse für jeden Kunden.15
Das ist eine nützlichere Erkenntnis, als eine Hosting-Kategorie für allgemein überlegen zu erklären. Die Infrastruktur bietet Fähigkeiten; die Anwendung und das Betriebsmodell bestimmen, welche davon zu wirksamem Schutz werden.
Ein praxisnaher Beschaffungsvergleich fragt deshalb: Welchen Dienst kann diese Organisation in den nächsten Jahren realistisch aufrechterhalten – samt Wochenenden, Personalwechseln, Geräteerneuerung und der Wiederherstellungsübung? Das gedachte, perfekt gewartete interne System sollte man nicht mit dem schlechtesten Tag eines realen Anbieters vergleichen. Ebenso wenig sollte man die beste Marketingzahl eines Anbieters mit der schlechtesten internen Installation vergleichen, an die sich jemand erinnert.
6. Hervorragende Durchschnittswerte können den Ausfall bündeln
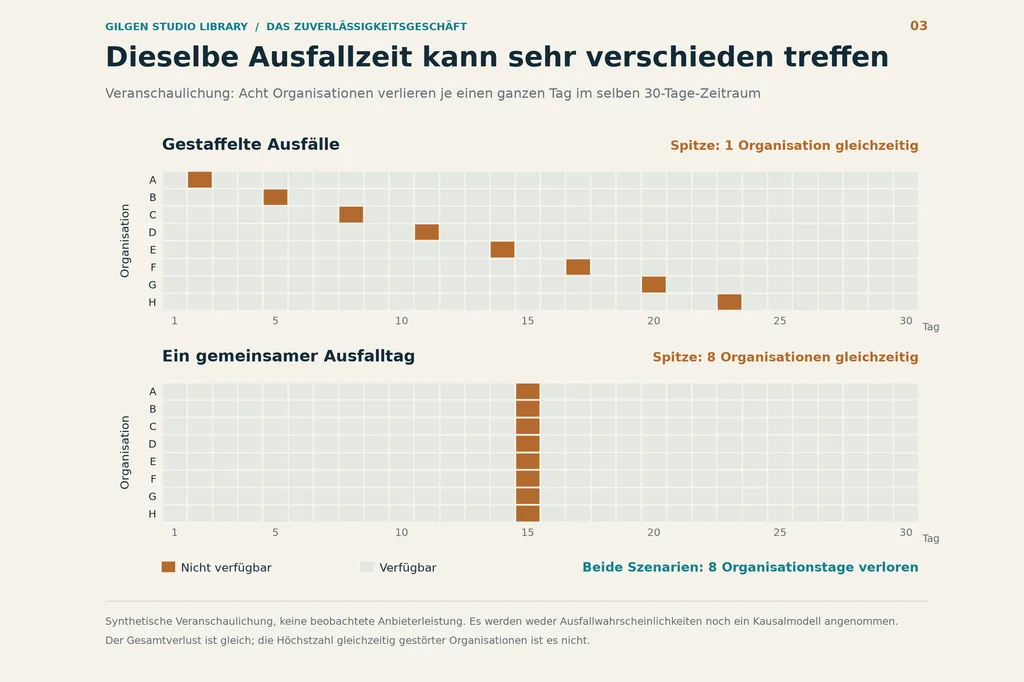
Man stelle sich acht Organisationen vor. Jede verliert in einem Zeitraum von 30 Tagen einen Tag Dienst. Im ersten Szenario fallen die Ausfälle auf verschiedene Tage. Im zweiten fallen alle acht auf denselben Tag.
Die Summe ist gleich: acht Organisationstage Unterbrechung. Jede Organisation hat in beiden Szenarien dieselbe zeitbasierte Verfügbarkeit. Die grösste Zahl der Organisationen, die gleichzeitig nicht arbeiten können, springt von eins auf acht.
Das ist eine Veranschaulichung, keine Messung tatsächlicher Anbieter. Sie zeigt, was ein Durchschnitt auslässt.
Wenn Ausfälle zusammenfallen, können Kundin, Bank, Lieferant und Berater einer Firma gleichzeitig beeinträchtigt sein. Ein funktionierendes internes System kann eine nicht erreichbare Gegenpartei nicht zum Antworten zwingen. Reparaturfirmen und Support-Kanäle können gleichzeitig unter Nachfrage stehen. Kritische Fristen können eintreffen, während alle nach einem anderen Weg suchen.
Darum kann der Ausfall eines grossen Anbieters öffentliche Aufmerksamkeit verdienen, selbst wenn der betroffene Dienst gewöhnlich sehr gut läuft. Die Unterbrechung bündelt Unannehmlichkeiten und kann finanziellen oder betrieblichen Schaden bündeln. Dieselbe Zahl ausgefallener Minuten kann unterschiedliche Folgen haben, je nachdem, wann sie auftreten, wie lange die längste Unterbrechung dauert und wer sonst gleichzeitig ausfällt.
Der Jahresbericht 2025 der FINMA behandelt diese Unterscheidung direkt. Er warnt, dass die wachsende Abhängigkeit von grossen Public-Cloud-Anbietern zu gleichzeitigen Ausfällen bei mehreren Finanzinstituten führen, kritische Funktionen beeinträchtigen und im Extremfall die Stabilität der Finanzmärkte gefährden kann. Das ist eine Warnung vor gebündelter Gefährdung, keine Aussage, Cloud-Dienste fielen zwingend häufiger aus als interne Systeme.16
Die Verteidigung der Anbieter hat deshalb eine Grenze. Hohe Alltagsverfügbarkeit kann den Kauf eines Dienstes rechtfertigen. Sie kann nicht rechtfertigen, die Folgen seines Ausfalls für nebensächlich zu halten.
Eine Organisation sollte mindestens ihre gesamte Unterbrechung, ihre längste Unterbrechung und ihre Fähigkeit prüfen, bei einer gemeinsamen Störung weiterzuarbeiten. Diese Masse beschreiben verschiedene Seiten des Risikos. Ein Jahresprozentsatz kann nicht alle drei Aufgaben erfüllen.
7. Die Abhängigkeit unter dem Logo
Die Aufteilung auf mehrere Anbieter kann die Gefährdung durch einen einzelnen Lieferanten verringern. Ob daraus eine funktionierende Alternative wird, hängt von den darunterliegenden Abhängigkeiten ab.
Googles Vorfall vom Juni 2025 ist aufschlussreich. Ein fehlerhafter Codepfad in Service Control wurde durch eine Richtlinienänderung aktiviert, die sich weltweit verbreitete. Die Auswirkungen erreichten mehrere Produkte von Google Cloud und Workspace. Die regionale Verteilung verhinderte nicht, dass ein gemeinsamer Steuerungsmechanismus den Fehler weitertrug.17
Der Vorfallsbericht von Cloudflare zum selben Datum beschreibt den Ausfall eines Speichers eines Drittanbieters, auf dem Workers KV beruht. Dienste, die von KV abhängen, waren gestört, während Produkte wie DNS, Proxy und WAF nicht direkt betroffen waren. Der Bericht nennt den Speicheranbieter nicht. Der Mechanismus allein belegt den Punkt: Ein Dienst kann eine Abhängigkeit erben, die an der Marke, die der Kunde gekauft hat, nicht zu erkennen ist.18
Der Vorfall von AWS in Nord-Virginia im Oktober 2025 begann mit einer Race Condition in der DNS-Verwaltung von DynamoDB und breitete sich in abhängige Dienste und Wiederherstellungsprozesse aus. Die Auswirkung war nicht der Verlust aller AWS-Regionen oder aller laufenden virtuellen Maschinen. DynamoDB-Replikate in anderen Regionen konnten weiterhin Anfragen bedienen, während die Replikation mit der betroffenen Region verzögert war.19
Diese Beispiele zeigen Mechanismen, keine gleichen Ausfallraten. Sie belegen weder, dass alle Anbieter austauschbar sind, noch dass ein Anbieterwechsel zwecklos ist. Sie zeigen, warum die Wahl des Lieferanten von einem Verständnis des Ausfallumfangs begleitet sein muss.
Man frage, was die Rückfallebene braucht, bevor sie irgendetwas Nützliches leisten kann. Nutzt sie denselben Identitätsdienst? Sind ihre Wiederherstellungscodes erreichbar? Braucht ein Ersatzadministrator ein Postfach beim ausgefallenen Anbieter, um den Zugang zurückzusetzen? Liegen die Dateien wirklich lokal, oder sind es Platzhalter, die erst beim Öffnen heruntergeladen werden? Kann die Notfalltelefonie einen Anruf tätigen, ohne den Collaboration-Dienst? Hängt das Verwaltungsportal der Alternative am selben Netzwerk-Gateway?
Das sind technische Fragen. Ein zweites Abonnement kann sie nicht von selbst beantworten.
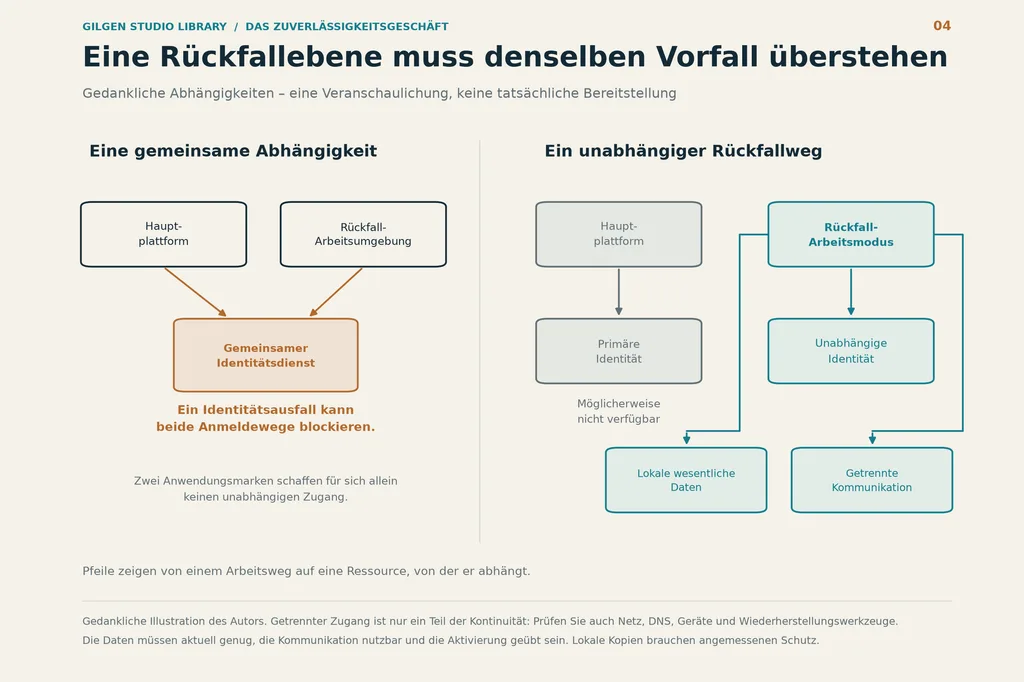
Googles SRE-Leitfaden warnt ausdrücklich davor, die Verfügbarkeit redundanter Bereitstellungen so zu berechnen, als fielen ihre Ausfälle automatisch unabhängig voneinander an. Gemeinsame Steuerungsebenen, Ausfalldomänen und andere gemeinsame Abhängigkeiten können diese Rechnung ungültig machen.20
Dieselbe Sorgfalt gilt für den lokalen Betrieb von Systemen. Eine lokale Anwendung kann trotzdem eine Cloud-Authentifizierung, extern gehaltene Entschlüsselungsschlüssel, eine Fernlizenzierung, eine Internetverbindung oder einen gehosteten Verwaltungsdienst voraussetzen. Wem die Maschine gehört, beantwortet eine andere Frage als die, ob sie beim Ausfall eines Lieferanten benutzbar bleibt.
8. Eine zweite Umgebung und ein Ersatzdienst
Eine Beratungsfirma kann sich sinnvoll dafür entscheiden, ihre interne Arbeit auf einer Plattform zu halten und für Kundenprojekte eine andere zu nutzen. Fällt die Umgebung des Kunden aus, können ihr eigener Kalender, ihre Dokumente und ihre Koordination verfügbar bleiben. Diese Trennung kann nützlichen Spielraum schaffen.
Sie überträgt den Dienst des Kunden nicht automatisch in die Umgebung der Beraterin. Ein funktionierender interner Dokumenteneditor kann fehlende Berechtigungen nicht neu erstellen, nie kopierte Dateien nicht beschaffen, die E-Mail des Kunden nicht empfangen und den Freigabeprozess des Kunden nicht nachbilden.
Beides kann zugleich stimmen: Die Trennung war wertvoll, und der Geschäftsprozess braucht trotzdem ein Kontinuitätskonzept.
Das erklärt auch den Unterschied zwischen der Wahl von Google als Hauptanbieter und der Vorbereitung von Google als Rückfalllösung für einen anderen Hauptanbieter. Google dokumentiert inzwischen Workspace-Angebote für die Geschäftskontinuität, darunter Cold-Standby- und Hot-Standby-Varianten. Dass es sie gibt, belegt, dass sich eine Alternative gezielt vorbereiten lässt; es belegt nicht, dass jede Organisation mit zwei Konten bereits einen gleichwertigen Schutz hat.21
Für manche Firmen ist eine zweite Collaboration-Plattform verhältnismässig. Für andere bringt sie Betriebsaufwand, ohne den wichtigsten Ausfall zu lösen. Synchronisation kann weitere Abhängigkeiten schaffen. Zwei Berechtigungssysteme müssen verwaltet werden. Die Nutzer brauchen Schulung. Während eines Vorfalls entstandene Datensätze müssen abgeglichen werden. Die Alternative kann zu teuer sein, um sie im nötigen Umfang bereitzuhalten.
Der Entscheid sollte sich an der kritischen Aufgabe orientieren. Wenn es zunächst darum geht, zehn Kunden zu erreichen, eine aktuelle Liste der Verpflichtungen einzusehen und Entscheide für einige Stunden festzuhalten, kann ein geschütztes Offline-Informationspaket mit einem freigegebenen, unabhängigen Kommunikationsweg mehr leisten als eine knapp konfigurierte Duplikat-Suite.
Geht es darum, einen grossen regulierten Ablauf mehrere Tage aufrechtzuerhalten, sind die Anforderungen andere. Kapazität, Datenaktualität, Vertraulichkeit, Aufzeichnungspflichten und Wiederherstellungsverfahren stehen dann im Zentrum des Entwurfs.
Wählen Sie die Alternative, die die geforderte Arbeit tragen kann, und messen Sie den Aufwand, sie einsatzbereit zu halten.
9. Zur Ehrenrettung des gewöhnlichen Notbehelfs
Telefon und Fax sind bei einem Cloud-Ausfall leichtes Material für Spott. Die Technik scheint genau dann rückwärtsgereist zu sein, als die Organisation erwartet hatte, sie werde unsichtbar.
Das Alter ist ein schlechter Massstab dafür, ob ein Notbehelf seinen Zweck erfüllt.
Die Leitlinien des NIST zur Notfallplanung zählen die vorübergehende manuelle Verarbeitung zu den Möglichkeiten, gestörte Geschäftstätigkeiten fortzusetzen. Das ist die Anerkennung eines begrenzten Betriebsmodus, keine Billigung jedes improvisierten Behelfs.22
Ein Telefonat kann ein wesentliches Gespräch retten. Eine Papierliste kann die Verpflichtungen des nächsten Tages sichern. Eine gezielt vorbereitete manuelle Warteschlange kann verhindern, dass dringende Anfragen verloren gehen. Die Fragen lauten: Ist der Weg verfügbar? Lassen sich die Beteiligten überprüfen? Ist der Ablauf erlaubt? Ist das Volumen beherrschbar? Lassen sich die Ergebnisse nachher abgleichen?
Ein Faxdienst, der über dieselbe ausgefallene Cloud-Infrastruktur läuft, würde die massgebliche Abhängigkeit nicht lösen. Ebenso wenig ein nicht genehmigter Kanal, der ein Problem bei Vertraulichkeit oder Aufzeichnung schafft. Entscheidend ist die Fähigkeit, die geforderte Aufgabe unter den tatsächlichen Ausfallbedingungen zu tragen.
Die Beobachtungen der FCA vom November 2026 machen eine ähnliche Unterscheidung. Sie kritisiert, dass man sich auf manuelle Behelfe verlässt, ohne gezeigt zu haben, dass sie im nötigen Umfang oder über die nötige Dauer funktionieren. Sie weist auch auf Belege hin, dass Kommunikation funktionieren kann, wenn die üblichen Kanäle nicht zur Verfügung stehen. Es geht um nachgewiesene Leistungsfähigkeit.23
Während dieses Microsoft-Vorfalls gab NHS Essex eine vorübergehende Telefonnummer für Überweisungen von Fachpersonen und dringende patientenbezogene Anfragen bekannt, solange die E-Mail-Dienste gestört waren. Das ist ein konkretes Beispiel für einen Ersatzkanal, der in Betrieb genommen wurde.24
Es ist vernünftig, von modernen Institutionen Investitionen in die Wiederherstellung zu erwarten. Es ist ebenso vernünftig, dass ihr Notbetrieb einfacher aussieht als der Normalbetrieb. Ein Notbehelf hat seinen Platz verdient, wenn er wesentliche Ergebnisse innerhalb akzeptabler Grenzen sichert.
Das peinlichste Backup ist das beeindruckende, das niemand aktivieren kann.
10. Die Arbeit, die bleibt, wenn der Anbieter zurückkehrt
Die Wiederherstellung des Dienstes und die Erholung des Geschäfts fallen nicht zwingend auf denselben Zeitpunkt.
Angenommen, eine Organisation kann sich mittags wieder anmelden. Es kann noch verzögerte Nachrichten geben, doppelte Anfragen, unerledigte Freigaben, unklare Transaktionszustände und Aufzeichnungen, die über Ersatzwege entstanden sind. Die Mitarbeitenden müssen klären, welche Handlungen gelungen sind, welche wiederholt werden müssen und welche auf keinen Fall wiederholt werden dürfen.
Darum braucht ein Kontinuitätsplan einen Rückweg. Einen Ersatzablauf zu starten, ist nur ein Teil der Aufgabe. Die Organisation muss genügend Nachweise sichern, um die Arbeit sicher abzugleichen, wenn der Normalbetrieb zurückkehrt.
Sie muss auch die Unterbrechung vom Verlust oder von der Verfälschung von Informationen unterscheiden. Replikation kann die Verfügbarkeit verbessern und dabei eine fehlerhafte Änderung getreu kopieren. Ein Backup kann frühere Daten bewahren und doch zu lange für die Wiederherstellung brauchen, gemessen an der aktuellen Frist. Ein Export kann lesbar sein und trotzdem die Berechtigungen oder Metadaten auslassen, die der Prozess braucht.
Nützliche Fragen sind deshalb:
- Wie viel Unterbrechung kann dieser Geschäftsprozess verkraften, bevor die Folgen untragbar werden?
- Wie schnell muss innerhalb dieser Grenze das System oder der minimale Betriebsmodus wiederhergestellt sein?
- Wie alt dürfen die verfügbaren Informationen sein, und wie viel nicht wiederherstellbare jüngste Arbeit ist hinnehmbar?
- Bei welchem Volumen und für wie lange kann die Rückfallebene arbeiten?
- Wer entscheidet über ihre Aktivierung, wer ist Stellvertretung, und wer bestätigt den Abgleich?
Das Kontinuitätsrahmenwerk des NIST unterscheidet die maximal tolerierbare Ausfallzeit, Wiederherstellungszeitziele und Wiederherstellungspunktziele. Diese Begriffe helfen den Verantwortlichen im Geschäft festzulegen, was die technischen Vorkehrungen leisten müssen.25
Bei einem Ausfall können ein aktueller Export und ein vorbereiteter Ersatzkanal genügen. Bei Verdacht auf Verfälschung kann derselbe Export unsicher sein. Beim Verlust des vertraglichen oder rechtlichen Zugangs zu einem Anbieter ist es womöglich keine glaubwürdige Antwort, einige Stunden zu warten. Ein einziges Wiederherstellungsdiagramm sollte diese verschiedenen Szenarien nicht verdecken.
Das praktische Arbeitsblatt am Ende dieses Bandes macht aus diesen Fragen eine kleine Übung. Ziel ist, eine echte Lücke zu entdecken, solange noch Zeit bleibt, sie zu schliessen.
11. Souveränität hat Betriebskosten
Verfügbarkeit, Sicherheit, Wiederherstellbarkeit und Souveränität hängen zusammen, aber keine von ihnen kann alle anderen ersetzen.
Verfügbarkeit fragt, ob eine definierte Funktion bei Bedarf genutzt werden kann. Wiederherstellbarkeit fragt, ob sich Informationen und Betrieb nach einer Störung wiederherstellen lassen. Sicherheit umfasst den Schutz von System und Informationen vor Missbrauch oder Kompromittierung. Souveränität betrifft die Autorität und die praktische Fähigkeit, Abhängigkeiten zu steuern, Änderungen vorzunehmen und glaubwürdige Alternativen zu tragen.
Ein Anbieter kann im gewöhnlichen Betrieb Hervorragendes leisten und trotzdem rechtliche oder strategische Einschränkungen schaffen, die eine Institution für unannehmbar hält. Ein System in lokalem Eigentum kann mehr unmittelbare Kontrolle bieten und doch das Personal oder die Widerstandsfähigkeit vermissen lassen, die für seine Dienstverpflichtungen nötig sind. Das sind mögliche Kombinationen, keine Widersprüche.
Darum braucht ein Souveränitätsargument keine übertriebene Zuverlässigkeitsbehauptung. Eine Organisation kann vernünftigerweise andere Kosten oder ein anderes Betriebsmodell in Kauf nehmen, um eine Kontrolle zu erhalten, die ihr wichtig ist. Sie sollte diesen Tausch ausdrücklich benennen, die daraus folgenden Pflichten finanzieren und den Dienst messen, den sie erhält.
Das Umgekehrte ist ebenso wichtig. Ein Entscheid zum Outsourcing kann verantwortungsvoll sein, wenn er den Dienst verbessert, den die Organisation tatsächlich aufrechterhalten kann. Verantwortung zu behalten heisst dann: zu verstehen, was delegiert wurde, den Zugang zu wesentlichen Informationen zu bewahren und verhältnismässige Fähigkeiten zur Wiederherstellung und zum Ausstieg zu erhalten.
Die Grundsätze des Basler Ausschusses zur operationellen Resilienz behandeln das Management von Abhängigkeiten von Dritten, Kontinuitätsvorkehrungen, Ausstiegsstrategien und praktische Ersetzbarkeit, einschliesslich der Möglichkeit, einen Dienst wieder ins eigene Haus zu holen. Das sind betriebliche Fähigkeiten, die es zu beurteilen gilt, keine Schlüsse, die die Nationalität eines Anbieters liefert.26
Die massgebliche Entscheidung ist weiter gefasst als die Frage, ob man einen Server besitzt. Sie umfasst, wer eine Änderung freigeben kann, wer einen Ersatz betreiben kann, wo die notwendigen Informationen liegen, welche rechtlichen und technischen Abhängigkeiten bleiben und ob die Alternative innerhalb der verfügbaren Zeit nutzbar werden kann.
Diese Fähigkeit lässt sich intern aufbauen, bei einem kompetenten Managed-Service-Anbieter beziehen oder auf mehrere Vorkehrungen aufteilen. Sie wird immer fortlaufende Aufmerksamkeit verlangen. Ein Ausstiegsplan verliert an Nutzen, wenn das Personal, die Formate und die Verfahren, die zu seiner Ausführung nötig sind, verschwunden sind.
Die früheren Bände der Bibliothek zu Selbstversorgung und zum Exit-Test untersuchen diese strategische Fähigkeit. Dieser Band fügt eine unmittelbarere Prüfung hinzu: Welche nützliche Arbeit überlebt die nächste Unterbrechung?
12. Zuverlässigkeit kann uns die Wiederherstellung vergessen lassen
Es gibt eine letzte Komplikation. Zuverlässigkeit kann selbst zu Überabhängigkeit verleiten.
Googles SRE-Buch beschreibt, wie sein hochzuverlässiger Dienst Chubby abhängige Systeme anzog, die faktisch davon ausgingen, er werde nie ausfallen. Google führte kontrollierte Ausfälle ein, um diese Annahmen aufzudecken. Das Beispiel zeigt, wie lange Erfolgsphasen die Wiederherstellungsfähigkeit selbst bei versierten Ingenieuren verkümmern lassen können.3
Die Lehre für eine gewöhnliche Organisation ist, eine begrenzte Rückfallebene in einem kontrollierten Rahmen zu üben. Sie ist kein Grund, die Nutzer zu überraschen, indem man Produktivsysteme abschaltet. Ein vereinbartes Planspiel am Tisch, gefolgt von einem sorgfältig begrenzten praktischen Test, kann unzugängliche Zugangsdaten, veraltete Kontaktlisten, fehlende lokale Dateien und ungeklärte Entscheidungsbefugnisse sichtbar machen, ohne eine Krise herbeizuführen.
Das verändert die Frage, die man nach dem nächsten Ausfall stellt. Es wird weiterhin Gründe geben, die Leistung des Anbieters zu untersuchen. Es wird weiterhin berechtigte Debatten über Architektur, Verträge, Wettbewerb und Souveränität geben. Ein teurer Vorfall verdient eine genaue Darstellung seiner Ursachen und Folgen.
Daneben kann die Organisation etwas fragen, das in ihrer eigenen Hand liegt: Welche wesentlichen Aufgaben haben wir gesichert, welche sind ausgefallen, und was ändern wir vor dem nächsten Ereignis?
Ein fähiger Anbieter kann die Menge an Infrastruktur verringern, die eine Organisation betreiben muss. Er kann nicht entscheiden, welche Verpflichtungen die Organisation während einer Unterbrechung erfüllen muss. Er kann eine ungetestete Rückfallebene nicht dadurch nutzbar machen, dass er den Betrieb wieder aufnimmt. Er kann eine Wahlmöglichkeit nicht bewahren, die der Kunde hat verschwinden lassen.
Das Zuverlässigkeitsgeschäft lohnt sich, wenn die verbleibenden Verantwortlichkeiten verstanden und finanziert sind. Kaufen Sie einen starken Alltagsdienst. Behalten Sie die Informationen, die Entscheidungsbefugnis und die geübten Alternativen, die Sie für die Momente brauchen, in denen er ausfällt.
Das richtige Mass ist die Arbeit, die weiterhin getan werden kann.
Anhang: Können wir weiterarbeiten?
Eine Kontinuitätsübung für eine kleine Schweizer Beratungsfirma
Arbeitsblatt · 13. November 2026 · Empfohlene Dauer: 60–90 Minuten
Firma/Team: ____________________ Datum der Übung: ____________________
Verantwortliche Person im Geschäft: ____________________ Moderation: ____________________
Teilnehmende und Stellvertretungen: __________________________________________________
Die Übung soll zeigen, welche kritischen Ergebnisse die Firma noch liefern kann, wenn ihr wichtigster Collaboration- oder Identitätsdienst ausfällt. Wählen Sie zwei oder drei Prozesse. Beispiele sind die Information der Kunden, die Prüfung bestehender Verpflichtungen, der Zugriff auf wesentliche Unterlagen und die Vorbereitung zeitkritischer Arbeit. Trennen Sie die Vorbereitung von Transaktionen oder Freigaben, die nicht verfügbare Kontrollen voraussetzen.
Die folgenden Zeitangaben und Felder sind empfohlene Praxis, keine regulatorischen Schwellenwerte. Die FINMA nennt die Konzentration bei ausgelagerten Diensten als Quelle gleichzeitiger Störungen. Die Beobachtungen der FCA vom November 2026 betonen den Nachweis funktionierender Kontinuitätsvorkehrungen und erprobter Kommunikationskanäle.1623
1. Festlegen, was weiterlaufen muss
Füllen Sie diese Tabelle aus, bevor Sie über Produkte sprechen. «E-Mail ist ausgefallen» beschreibt ein System; «wir können die Kunden nicht über eine dringende Frist informieren» benennt eine geschäftliche Folge.
| Kritischer Prozess | Verantwortung / Stellvertretung | Minimaler nützlicher Betriebsmodus | Maximal tolerierbare Unterbrechung | Maximales Alter der Rückfalldaten | Nachweis der Leistungsfähigkeit | Lücke / Verantwortung für die Massnahme |
|---|---|---|---|---|---|---|
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
| __________________ | __________________ | __________________ | __________________ | __________________ | __________________ | __________________ |
Halten Sie für jeden Prozess fest:
- Auswirkungstoleranz: Ab wann verursacht die Unterbrechung untragbaren Schaden? Berücksichtigen Sie, wo es passt, verpasste Verpflichtungen, betroffene Kunden, Transaktionswerte oder -volumen.
- Wiederherstellungszeitziel (RTO): Wie schnell soll der benötigte Dienst wiederhergestellt und geprüft sein? Planen Sie Zeit für Beurteilung, Aktivierung und Kontrolle ein, bevor die maximal tolerierbare Unterbrechung erreicht ist.
- Wiederherstellungspunktziel (RPO): Wie viele bestätigte Informationen dürfen nach der Wiederherstellung verloren sein, wo sinnvoll als Zeitspanne ausgedrückt?
- Aktualität der Rückfalldaten: Wie alt darf die zugängliche Kopie sein? Eine veraltete Kundenkontaktliste und eine veraltete Portfolioposition haben unterschiedliche Folgen. Das ist eine andere Frage als die des wiederherstellbaren Datenverlusts.
Akzeptierte reduzierte Kapazität: ______ Fälle pro Stunde, während ______ Stunden, mit ______ Personen.
Tätigkeiten, die pausieren müssen: __________________________________________________
2. Das Planspiel durchführen
| Zeit | Diskussion oder Herausforderung | Erforderliches Ergebnis |
|---|---|---|
| 0–10 Min. | Kritische Prozesse, Rollen und Unterbrechungsgrenzen bestätigen. | Ausgefüllte Prozesstabelle; benannte entscheidende Person. |
| 10–25 Min. | Die wichtigsten E-Mail-, Chat- und Dokumentendienste fallen aus. Der Anbieter nennt keine verlässliche Schätzung für die Wiederherstellung. | Erste Massnahmen, Kundenprioritäten und Entscheid über die Aktivierung der Rückfallebene. |
| 25–45 Min. | Auch neue Anmeldungen schlagen fehl. Der übliche Administrator ist nicht erreichbar. Ein wichtiges Dokument ist nur ein Cloud-Platzhalter. | Vorgeführter Zugangsweg; Reaktion der Stellvertretung; nicht zugängliche Elemente festgehalten. |
| 45–65 Min. | Ein Kunde verlangt dringendes Handeln. Mehrere Kolleginnen und Kollegen brauchen gleichzeitig die Rückfallebene. | Freigegebene Kommunikation, Identitätsprüfung, Kapazitätsschätzung und Aktivitätsprotokoll. |
| 65–80 Min. | Die Hauptdienste kehren zurück. Das Personal hat anderswo Entscheide getroffen oder Arbeit vorbereitet. | Verantwortung für den Abgleich, Prüfschritte und Verhinderung doppelter Handlungen. |
| 80–90 Min. | Nachweise prüfen und entscheiden, was zu verbessern ist. | Zugeteilte Massnahmen, Fristen und akzeptierte Restrisiken. |
Kürzen Sie bei einer Sitzung von 60 Minuten die Szenariodiskussion; behalten Sie die Zugangsvorführung und die Auswertung der Wiederherstellung bei. Präsentieren Sie keine optimistische Wiederherstellungsschätzung des Anbieters als Beleg dafür, dass die Firma weiterarbeiten kann.
3. Den ganzen Rückfallpfad nachverfolgen
Beantworten Sie für jede vorgeschlagene Alternative die Frage «Können wir sie nutzen, wenn die Anmeldung beim Hauptanbieter ausfällt?» Halten Sie Nachweise fest, nicht nur den Namen eines Lieferanten.
| Abhängigkeit | Prüfung | Nachweis / ungelöste Lücke |
|---|---|---|
| Identität und MFA | Unabhängige berechtigte Anmeldung; verfügbare Wiederherstellungsmethode; die Stellvertretung kann ihre eigenen freigegebenen Zugangsdaten nutzen. | __________________ |
| Gerät | Dateien sind tatsächlich heruntergeladen; das verschlüsselte Gerät lässt sich entsperren; benötigte Lesesoftware und Lizenzen funktionieren. | __________________ |
| Netz und DNS | Die alternative Verbindung ist nutzbar; die nötige Namensauflösung funktioniert; kritische gemeinsame Abhängigkeiten sind verstanden. | __________________ |
| Dokumente und Backups | Benötigte Unterlagen sind lesbar; Backup-Konsole, Schlüssel und Wiederherstellungsanleitungen bleiben zugänglich. | __________________ |
| Kommunikation | Der freigegebene Kanal erreicht Mitarbeitende und Kunden; die Kontaktliste ist zugänglich; Absender und Empfänger lassen sich überprüfen. | __________________ |
| Personen und Kapazität | Die Stellvertretung kennt das Verfahren; gleichzeitige Nutzung und anhaltende Arbeitslast sind machbar. | __________________ |
Eine unabhängige Backup-Kopie liefert Wiederherstellungsmaterial; sie belegt nicht, dass das Personal es in der verlangten Zeit nutzen kann. Eine zweite SaaS-Anwendung kann trotzdem vom ursprünglichen Identitätsdienst, von der Geräteverwaltung oder von einer gemeinsamen Netzkomponente abhängen.
4. Das Szenario ändern, bevor die Reaktion gewählt wird
| Ausfallszenario | Angemessene Frage und Reaktion |
|---|---|
| Dienst nicht verfügbar; Daten vermutlich intakt | Welche freigegebenen Mindestfunktionen können mit zugänglichen Kopien und alternativen Kanälen weiterlaufen? Neue Arbeit für den späteren Abgleich festhalten. |
| Mögliche Verfälschung oder Sicherheitsvorfall | Welchen Kopien, Identitäten und Geräten kann man vertrauen? Die Verfahren für Vorfälle befolgen, Beweise sichern und Wiederherstellungsmaterial prüfen. Automatische Synchronisation kann Schaden weitertragen. |
| Zugang beim Anbieter oder rechtlicher Zugang entzogen | Kann die Firma wesentliche Informationen rechtmässig abrufen und anderswo nutzen, mit Schlüsseln, Berechtigungen und den nötigen Verträgen? Ein Export- und Migrationsplan muss über einen vorübergehenden Ausfall hinaus machbar sein. |
Improvisieren Sie keine Transaktionsfreigaben, geben Sie keine Zugangsdaten weiter und verschieben Sie keine vertraulichen Unterlagen in private Konten. Halten Sie Anfragen, Entscheide, Zeitstempel, verantwortliche Personen und Bestätigungen im freigegebenen Rückfallprotokoll fest. Legen Sie fest, wie die Aufzeichnungen aufbewahrt und mit dem Hauptsystem abgeglichen werden.
Das NIST erkennt die vorübergehende manuelle Verarbeitung als Kontinuitätsoption an. Die FCA mahnt, dass manuelle Behelfe den Nachweis ausreichender Kapazität und Ausdauer brauchen.2322
5. Optionale begrenzte Zugangsübung
Verwenden Sie ein bestimmtes Testgerät oder Testkonto und eine kleine, freigegebene Menge nicht sensibler Testdatensätze. Simulieren Sie den Ausfall des Hauptdienstes, indem Sie eine Übungsregel befolgen, die dessen Nutzung verbietet. Das zeigt den Ablauf, beweist aber für sich allein keine technische Unabhängigkeit. Prüfen Sie Authentifizierung und Datenwege gesondert, einschliesslich einer frischen berechtigten Anmeldung und der Anforderungen an die Sitzungserneuerung. Halten Sie Abhängigkeiten fest, die ungetestet bleiben. Schalten Sie nicht die Produktividentität ab, ändern Sie kein aktives DNS, entziehen Sie keine echten Zugriffe und unterbrechen Sie keine laufenden Dienste.
Bitten Sie eine Stellvertretung, die Anleitung zu finden, über den berechtigten Weg auf die Rückfallebene zuzugreifen, die Testdatensätze zu öffnen und eine Scheinanfrage zu erfassen. Stellen Sie dann die normalen Übungsbedingungen wieder her und gleichen Sie diese Anfrage in einem Testprotokoll ab. Notieren Sie jede Abhängigkeit, bei der die Moderation helfen musste. Ein Ergebnis, das nur auf Diskussion beruht, bleibt eine Annahme, bis es vorgeführt wurde.
Erfassen Sie die verstrichene Aktivierungszeit, die nutzbaren im Verhältnis zu den benötigten Datensätzen, das Alter der Daten, erfolgreiche berechtigte Anmeldungen, bearbeitete Anfragen, fehlende Prüfspureinträge und die Zeit für den Abgleich. Die verantwortliche Person im Geschäft sollte diese Ergebnisse mit den Anforderungen des gewählten Prozesses vergleichen und nicht mit einem externen Richtwert.
6. Entscheiden, welche Investition gerechtfertigt ist
Ein geschütztes Offline-Paket kann genügen, wenn ein kleiner, relativ stabiler Bestand an Unterlagen einen akzeptablen vorübergehenden Dienst trägt und das Personal ihn sicher pflegen kann. Die Aufteilung auf mehrere Anbieter wird attraktiver, wenn das Geschäft Live-Zusammenarbeit, anhaltende Transaktionskapazität oder eine Wiederherstellung in einer Zeit braucht, die der einfachere Notbehelf nicht erreichen kann.
Bevor Sie eine weitere Plattform kaufen, klären Sie ihre Unabhängigkeit, Datenaktualität, Zugriffskontrollen, Betriebskosten und den Abgleichaufwand. Prüfen Sie, ob das Team beide Vorkehrungen betreiben kann. Die Resilienzgrundsätze des Basler Ausschusses stützen die Beurteilung praktischer Ersatzlösungen und Ausstiegsvorkehrungen für kritische Dritte.26
Nachgewiesene Leistungsfähigkeit: __________________________________________________
Noch ungetestete Annahmen: ________________________________________________
Massnahmen / Verantwortliche / Termine: __________________________________________________
Restrisiko akzeptiert durch / Datum der Überprüfung: ____________________________________
Anmerkung zur Recherche
Die Recherche wurde am 13. November 2026 abgeschlossen, auf Grundlage von Vorfallsberichten und Vereinbarungen der Anbieter, Forschung des Uptime Institute, Leitlinien des NIST sowie Aufsichtsmaterial des Schweizer und des britischen Finanzsektors. Die technischen Vorfallsbeispiele veranschaulichen Fehlermechanismen; sie bilden keine vergleichende Rangliste der Anbieter. Die Jahresanalyse 2026 des Uptime Institute wurde anhand ihrer öffentlichen Zusammenfassung geprüft, nicht anhand des kostenpflichtigen Vollberichts. Ein allgemeiner Faktor für die Verfügbarkeit von Cloud gegenüber selbst verwaltetem Betrieb wurde nicht festgestellt.
Die Darstellung des Microsoft-Vorfalls ist eine datierte Momentaufnahme. Microsoft hat angekündigt, einen vollständigen Nachbericht (Post-Incident Report) zu veröffentlichen, sobald die Behebung abgeschlossen ist; dieser Bericht, nicht diese Momentaufnahme, wird für Dauer und Ursache des Vorfalls massgeblich sein.1 Dieser Band enthält nicht die Behauptung, jeder Nutzer oder jede Funktion sei während des gesamten Vorfallzeitraums ausgefallen. Berechnungen und synthetische Abbildungen sind als solche gekennzeichnet.
Weiterführende Lektüre in der Bibliothek
- Der Exit-Test: die praktische Fähigkeit, eine Abhängigkeit zu verlassen.
- Souveränität ist nicht Selbstversorgung: Abhängigkeit steuern und dabei handlungsfähig bleiben.
- Die ersten zehn Minuten eines Lieferantenausfalls: das bestehende Kurzdossier dazu, was zuerst zu tun ist, wenn ein Lieferant ausfällt.
Quellen
Die Quellen wurden am 13. November 2026 geprüft. Jede nummerierte Anmerkung nennt ihre Quellenkennung (S01–S28).
Im Quellenverzeichnis des Autors aufgeführt, im Text aber nicht zitiert: S03 (Reuters, Hours-long Microsoft outage disrupts businesses governments globally, 12.–13. November 2026, laufende Berichterstattung, www.reuters.com); S16 (Google Cloud, 14 December 2020 authentication incident report, Bericht vom 18. Dezember; Korrektur vom 22. Dezember 2020, status.cloud.google.com).
Anmerkungen und Quellen
-
Microsoft via University of Pennsylvania, Microsoft incident reports EX1550543 and MO1550821. Meldungen um den 13. November 2026, 13:00 UTC. mailservices.isc.upenn.edu. (Quelle S01) ↩ ↩2
-
Workhorse Group, Workhorse Group postpones third quarter earnings release and conference call. 12. November 2026. ir.workhorse.com. (Quelle S02) ↩
-
Google SRE, Service Level Objectives. Kapitel des SRE-Buchs, abgerufen am 13. November 2026. sre.google. (Quelle S23) ↩ ↩2
-
Microsoft, Service Level Agreement for Microsoft Online Services. 1. Oktober 2026, jüngste aufgeführte englische Ausgabe. www.microsoft.com. (Quelle S05) ↩ ↩2
-
Google Workspace, Google Workspace Service Level Agreement. 31. August 2026. workspace.google.com. (Quelle S06) ↩ ↩2
-
Amazon Web Services, Amazon Compute Service Level Agreement. 25. Mai 2022, aktuelle Seite abgerufen am 13. November 2026. aws.amazon.com. (Quelle S07) ↩
-
Google Cloud, Compute Engine Service Level Agreement. 14. Oktober 2026. cloud.google.com. (Quelle S08) ↩
-
Microsoft Learn, Service health and continuity. Live-Tabelle, abgerufen am 13. November 2026; bis 2. Quartal 2026. learn.microsoft.com. (Quelle S04) ↩
-
Google Workspace, Business continuity and transformation offerings announcement. 16. Oktober 2025. workspace.google.com. (Quelle S26) ↩
-
Microsoft Learn, Shared responsibility for reliability. Abgerufen am 13. November 2026. learn.microsoft.com. (Quelle S22) ↩
-
NIST, SP 800-40 Rev 4 Guide to Enterprise Patch Management Planning. April 2022. csrc.nist.gov. (Quelle S21) ↩
-
Uptime Institute, Global Data Center Survey 2025. Juli 2025; Erhebung April–Mai 2025. datacenter.uptimeinstitute.com. (Quelle S10) ↩
-
Uptime Institute, Survey findings link higher redundancy to lower outage risk. 14. Oktober 2026. journal.uptimeinstitute.com. (Quelle S11) ↩
-
Uptime Institute, Annual Outage Analysis Report 2026 announcement. 13. Mai 2026. connect.uptimeinstitute.com. (Quelle S09) ↩
-
Uptime Institute, Outage data shows cloud apps must be designed for failure. 9. April 2025; Analyse von 2024. journal.uptimeinstitute.com. (Quelle S12) ↩
-
FINMA, Annual Report 2025 measures for promoting stability. Jahresbericht 2025, abgerufen am 13. November 2026. Abschnitt zu kritischen Dienstleistern und zur Konzentration bei Auslagerungen. report.finma.ch. (Quelle S17) ↩ ↩2
-
Google Cloud, Incident report for 12 June 2025. Bericht vom 13. Juni 2025 zum Vorfall vom 12. Juni. status.cloud.google.com. (Quelle S13) ↩
-
Cloudflare, Cloudflare service outage June 12 2025. Juni 2025; Vorfall vom 12. Juni 2025. blog.cloudflare.com. (Quelle S14) ↩
-
Amazon Web Services, Summary of the Amazon DynamoDB service disruption in Northern Virginia. Vorfall vom 19.–20. Oktober 2025 (PDT). aws.amazon.com. (Quelle S15) ↩
-
Google SRE, Implementing SLOs. Kapitel des SRE-Workbooks, abgerufen am 13. November 2026. sre.google. (Quelle S24) ↩
-
Google Workspace, Business Continuity. Aktuelle Dokumentation, abgerufen am 13. November 2026. knowledge.workspace.google.com. (Quelle S25) ↩
-
NIST, Contingency planning. Aktuelle Themenseite, abgerufen am 13. November 2026. Erläutert die Ansätze in SP 800-34 Rev. 1. csrc.nist.gov. (Quelle S19) ↩ ↩2
-
Financial Conduct Authority, Operational resilience demonstrating resilience in practice. 11. November 2026. Die Beobachtungen betreffen in erster Linie Firmen im festgelegten Geltungsbereich der FCA; sie dienen hier als praktischer Beleg, nicht als Aussage über Schweizer Rechtspflichten. www.fca.org.uk. (Quelle S18) ↩ ↩2 ↩3
-
NHS Essex Integrated Care Board, Temporary disruption to NHS email services caused by global Microsoft outage. 13. November 2026. www.essex.icb.nhs.uk. (Quelle S28) ↩
-
NIST, SP 800-34 Rev 1 Contingency Planning Guide for Federal Information Systems. Mai 2010, aktualisiert am 11. November 2010. csrc.nist.gov. (Quelle S20) ↩
-
Basel Committee on Banking Supervision, Operational resilience ORR20. Aktuelle konsolidierte Leitlinien, abgerufen am 13. November 2026. Siehe besonders die Absätze 20.29–20.31 zu Abhängigkeiten von Dritten, Kontinuität und Ersetzbarkeit. www.bis.org. (Quelle S27) ↩ ↩2