De la machine analytique à l’ère des agents : une histoire de machines, de promesses et de définitions qui changent.
L’été qui devait régler la question de l’intelligence
En août 1955, quatre chercheurs déposent une proposition pour l’été suivant. Ils veulent réunir un petit groupe de scientifiques pendant deux mois au Dartmouth College pour chercher si des machines peuvent utiliser le langage, former des concepts, résoudre des problèmes et s’améliorer elles-mêmes. Leur hypothèse de départ est radicale : peut-être chaque trait de l’apprentissage ou de l’intelligence peut-il être décrit assez précisément pour qu’une machine le simule.
John McCarthy, Marvin Minsky, Nathaniel Rochester et Claude Shannon donnent au domaine envisagé son nom : intelligence artificielle. Leur document est daté du 31 août 1955 ; la rencontre a lieu à l’été 1956. Ces dates comptent, car la version populaire du récit a tendance à fondre en un seul instant une proposition, un événement et la naissance de toute une discipline.12
La proposition contient aussi une phrase qui mérite d’être relue aujourd’hui. Pour ses auteurs, le principal obstacle n’était pas simplement le manque de puissance de calcul, mais l’incapacité à écrire des programmes qui tirent parti des machines déjà disponibles.1
Soixante-dix ans plus tard, nous débattons de la même question, mais par l’autre bout. La puissance de calcul ne manque plus. Nous avons des systèmes qui écrivent des programmes. Et pourtant, nous peinons encore à dire ce que signifie, pour ces systèmes, être fiables, véridiques, autorisés à agir, ou assez compétents pour assumer des conséquences sans surveillance constante.
Le groupe de Dartmouth n’a pas résolu l’intelligence. Il a donné un nom durable à une dispute déjà commencée, et qui n’a jamais cessé d’en changer les termes.
C’est cette histoire-là qui mérite d’être racontée.
01 · Avant d’avoir un nom, l’IA avait déjà un problème
En 1843, Ada Lovelace publie de longues notes sur la machine analytique projetée par Charles Babbage. La machine ne sera jamais construite telle qu’elle avait été conçue. Mais Lovelace comprend qu’une machine symbolique universelle pourrait, en principe, traiter autre chose que l’arithmétique ordinaire. Si des relations peuvent s’exprimer formellement, la machine peut travailler avec elles. Elle met aussi en garde contre l’exagération : la machine peut exécuter ce que les humains savent lui ordonner, non anticiper d’elle-même des vérités mathématiques.3
Ce n’était ni une prédiction de ChatGPT ni une réfutation définitive de la créativité des machines. C’était plus utile : une distinction entre la machine, les instructions, et ce que l’on prétend au nom des deux. Un siècle plus tard, Turing reviendra sur ce que l’on appellera « l’objection de Lady Lovelace ».4
En 1936, Alan Turing donne une définition mathématique des procédés calculables. En 1943, Warren McCulloch et Walter Pitts décrivent en termes logiques des éléments simplifiés, proches des neurones. En 1948, Cybernetics de Norbert Wiener propose un autre vocabulaire : rétroaction, communication, commande, et les ressemblances entre organismes et machines. Ce sont des projets distincts, non des variantes d’un même algorithme. Mais ils permettent de se demander si penser et agir peuvent se traiter comme des processus plutôt que comme des mystères.567
En 1950, Turing demande si les machines peuvent penser, puis remplace la question par une épreuve concrète fondée sur la conversation : le jeu de l’imitation. Il ne propose pas un appareil à mesurer la conscience. Il invite ses lecteurs à examiner quelles preuves d’un comportement intelligent ils accepteraient, et pourquoi.4
Voyez l’ordre des choses. D’abord le calcul formel, les neurones artificiels, la rétroaction et le débat sur les preuves. Ensuite seulement l’étiquette institutionnelle IA.
Le nom n’a pas créé la possibilité. Il a créé un domaine où des méthodes incompatibles pouvaient se disputer le droit de l’expliquer.
02 · Les premières démonstrations et leurs petits mondes
Avant même Dartmouth, en 1954, IBM et l’université de Georgetown organisent une démonstration publique de traduction automatique. Un vocabulaire restreint du russe vers l’anglais et une poignée de règles de grammaire suffisent à impressionner. Dans ce cadre soigneusement contrôlé, la machine fait ce qu’on la montre faire. Elle ne démontre pas la traduction générale d’une langue libre.8
Après Dartmouth, le domaine se découvre vite plusieurs personnalités.
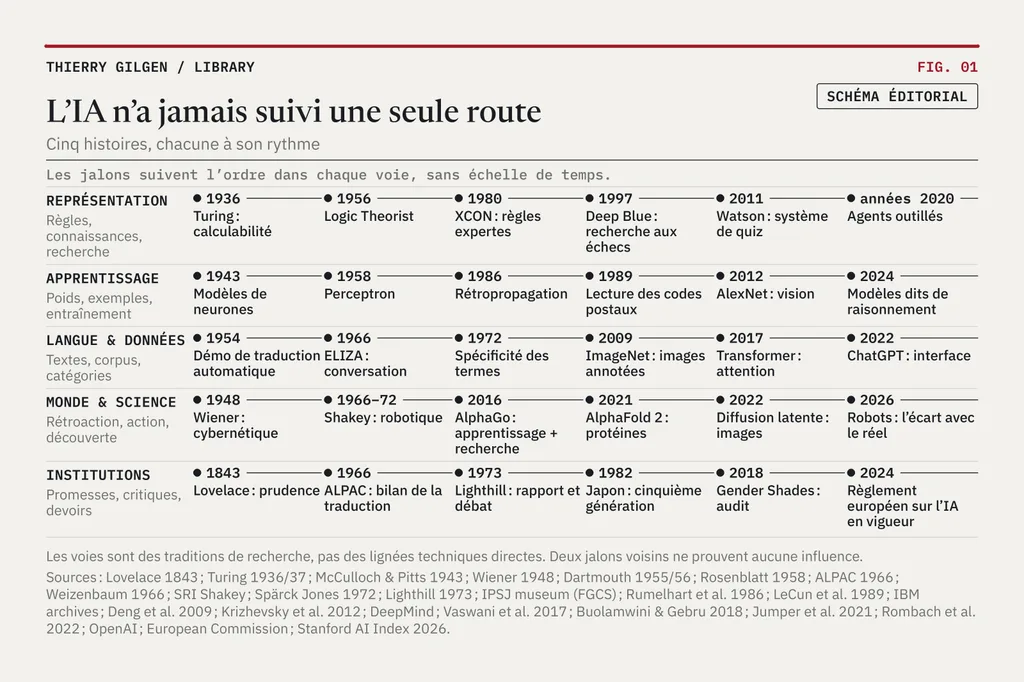
Allen Newell, Herbert Simon et Cliff Shaw travaillent sur des programmes qui manipulent des symboles et cherchent des démonstrations logiques. Cette tradition voit l’intelligence comme un raisonnement structuré : représenter le monde, définir les opérations permises, chercher des conclusions. Le perceptron de Frank Rosenblatt, présenté publiquement en 1958, poursuit une tout autre ambition : adapter le comportement de la machine en modifiant, à partir d’exemples, des connexions numériques. Les travaux d’Arthur Samuel sur le jeu de dames montrent qu’un programme peut mieux jouer grâce à l’expérience.2910
L’idée répandue selon laquelle l’IA aurait commencé par le raisonnement symbolique et découvert l’apprentissage des décennies plus tard est fausse. L’apprentissage était là presque dès le début. Tout comme des méthodes tournées vers les probabilités, la commande, la recherche et l’incarnation. La question n’était pas de savoir si les ordinateurs devaient apprendre ou raisonner, mais quelle approche tiendrait encore une fois l’exemple bien rangé épuisé.
Il y avait aussi un décalage récurrent entre démonstration et déploiement. Dans une démonstration, les chercheurs choisissent la tâche, les exemples, le moment et les limites. Dans un déploiement, c’est le monde qui choisit une grande partie de tout cela.
Cette différence allait marquer presque chaque engouement et chaque déception qui suivraient.
03 · La machine qui avait l’air de comprendre
ELIZA, décrit par Joseph Weizenbaum en 1966, simulait une conversation en repérant des motifs et en réarrangeant selon des règles des morceaux du texte de l’utilisateur. L’un des scripts imitait un psychothérapeute non directif. Ses réponses parvenaient étonnamment bien à relancer l’échange, malgré l’absence de la compréhension que beaucoup d’utilisateurs étaient prêts à lui prêter.11
ELIZA compte non parce qu’il serait l’ancêtre rudimentaire des modèles de langage actuels. Techniquement, il en était profondément différent. Il compte parce qu’il a révélé quelque chose de durable sur nous : nous déduisons compétence, bienveillance ou compréhension de la forme d’un échange avant d’examiner comment le système fonctionne.
La même année, l’Automatic Language Processing Advisory Committee américain rend un bilan sceptique de la traduction automatique. Le rapport conteste les affirmations optimistes sur les progrès et l’utilité pratique, et contribue à réorienter les priorités de financement aux États-Unis. Il n’arrête pas la recherche partout et ne prouve pas que la traduction soit impossible.12
Une seule année a donc vu à la fois l’apparence d’une compréhension conversationnelle et la perte de confiance institutionnelle dans les technologies de la langue.
La contradiction apparente est la leçon. Une machine peut produire une expérience locale convaincante sans résoudre le problème général. Et un domaine peut progresser beaucoup sans livrer encore les résultats économiques ou opérationnels qu’il avait promis.
04 · Pourquoi le premier hiver est venu
Les chercheurs en IA apprenaient que les exemples évidents étaient souvent les plus faciles. Une énigme mathématique, un plateau de jeu simplifié ou une pièce aménagée exprès se laissaient décrire formellement. La perception ordinaire, le sens commun, le langage et l’action physique résistaient à toute description nette.
Shakey, mis au point au Stanford Research Institute entre 1966 et 1972, était un robot mobile remarquable. Il pouvait percevoir un environnement contraint, planifier un trajet et agir sur des objets simples. Ce n’était pas un robot autonome pour le monde humain et imprévisible. Sa réussite tenait à l’intégration difficile de la vision, de la planification et du mouvement, non à la disparition des hypothèses sur son environnement.13
En 1969, Perceptrons de Marvin Minsky et Seymour Papert expose les limites de classes importantes de perceptrons de première génération. Une rétrospective simplifiée prétend souvent que ce livre aurait à lui seul tué les réseaux de neurones. C’est trop net. Des limites mathématiques précises, les contraintes du matériel, les modes de la recherche et les structures de financement ont joué ensemble ; le travail sur les réseaux apprenants a continué.14
Au Royaume-Uni, James Lighthill rédige en 1972 une évaluation critique de la recherche en IA. Elle est publiée en 1973 et discutée la même année lors d’un débat télévisé. Programmes et priorités de recherche sont remis en question. Les financeurs américains durcissent eux aussi leurs attentes dans une partie du domaine. Les historiens parlent aujourd’hui d’un premier hiver de l’IA, situé le plus souvent au milieu des années 1970. Mais l’hiver est une métaphore rétrospective, pas un interrupteur mondial que quelqu’un aurait basculé.15
Le plus révélateur n’est pas que l’enthousiasme ait été irrationnel. Beaucoup de premiers systèmes étaient ingénieux. Le problème, c’est qu’on prenait facilement leurs succès pour la preuve d’une généralité imminente. Les tâches que l’on sait formaliser en premier ne sont pas forcément représentatives du travail qu’on attend finalement de la machine.
On peut venir à bout d’un benchmark sans que le monde en soit changé.
05 · Quand l’intelligence devint un produit de règles
L’intelligence artificielle n’a pas disparu après les premières déceptions. Elle est devenue utile, dans des tâches plus étroites et mieux définies.
DENDRAL aidait à analyser des données scientifiques en chimie. MYCIN explorait des recommandations médicales fondées sur des règles. Dans les entreprises, les systèmes experts consignaient un savoir spécialisé sous forme de règles et de procédures d’inférence. XCON, de Digital Equipment Corporation, introduit vers 1980 pour configurer les commandes d’ordinateurs, devint l’emblème de cette approche : un logiciel pouvait appliquer un ensemble compliqué de règles d’experts avec une réelle valeur opérationnelle.16
Mais il fallait bien que les règles viennent de quelque part. Des experts du domaine les fournissaient. Des ingénieurs de la connaissance les traduisaient. D’autres corrigeaient les incohérences, mettaient à jour les exceptions, testaient les résultats et entretenaient un réseau de dépendances toujours plus dense.
Qualifier ce logiciel d’intelligent ne supprimait pas le travail humain qui rendait cette intelligence utile.
En 1982, le Japon lance le projet Fifth Generation Computer Systems, un effort national ambitieux centré sur la programmation logique, le calcul parallèle et de nouvelles architectures. Il est perçu dans le monde entier comme un signal de concurrence : l’IA n’est plus seulement une affaire d’universités, mais de stratégie industrielle. Le projet produit des recherches et des résultats techniques, tandis que ses ambitions commerciales plus larges s’avèrent plus difficiles à réaliser.17
Une deuxième période de désillusion suit l’essor des systèmes experts, à la fin des années 1980 et au début des années 1990. Coûts de maintenance, manque de souplesse, marchés du matériel en mutation et attentes gonflées ont tous pesé. Là encore, le domaine ne s’arrête pas. Certaines entreprises partent, d’autres chercheurs continuent, et des méthodes utiles se fondent dans le logiciel ordinaire.
Ce cycle contient un avertissement pour les plateformes d’agents d’aujourd’hui. Un prototype qui maîtrise le cas idéal n’est pas un processus métier. Fiabilité, mises à jour, gestion des exceptions, autorisations, reprise après incident et coût de la supervision humaine décident si un système apparemment habile mérite d’être déployé.
06 · Ce qui a survécu sous l’hiver
L’histoire habituelle saute des systèmes experts à l’apprentissage profond. Ce faisant, elle efface une partie des travaux les plus importants.
Les recherches de Karen Spärck Jones sur la spécificité des termes, en 1972, ont contribué à poser les principes de la recherche d’information statistique : certains mots distinguent mieux que d’autres. Les méthodes statistiques et probabilistes ont progressé en reconnaissance de la parole, en traitement de la langue, en classification et en recherche d’information, alors même que les grandes ambitions de l’IA étaient réévaluées.1819
En 1986, David Rumelhart, Geoffrey Hinton et Ronald Williams montrent comment la rétropropagation de l’erreur permet d’entraîner des réseaux multicouches à apprendre des représentations internes utiles. C’était une démonstration et une diffusion décisives, non l’invention exclusive de l’idée de rétropropagation. Des travaux mathématiques et informatiques antérieurs avaient compté.20
En 1989, Yann LeCun et ses collègues appliquent la rétropropagation à la lecture de codes postaux manuscrits. Des systèmes neuronaux ultérieurs traiteront des documents dans un cadre commercial. Ce n’était pas une intelligence générale. C’était le pont entre une théorie séduisante de l’apprentissage et des tâches répétitives et mesurables, dont on pouvait étudier les erreurs et les coûts.21
La leçon plus large passe facilement inaperçue : ce qui transforme le monde n’est pas toujours nouveau au moment où cela devient célèbre. Une idée peut attendre les données, les puces, les outils, les institutions et l’économie qui lui conviennent. Parfois, la percée est l’algorithme. Parfois, c’est l’environnement dans lequel cet algorithme devient enfin praticable.
Les progrès de l’IA ressemblent davantage à un réseau d’affluents qu’à un seul fleuve.
07 · La machine gagne aux échecs, la définition se déplace
En 1997, Deep Blue d’IBM bat le champion du monde d’échecs Garry Kasparov dans un match en six parties. Le résultat est historique. Il est aussi très particulier. Deep Blue combinait une recherche massive, des connaissances échiquéennes, des fonctions d’évaluation, de l’ingénierie et une préparation humaine. Il n’avait pas besoin de penser comme Kasparov pour le battre aux échecs.22
Une fois le match terminé, on pouvait en tirer des conclusions opposées : les ordinateurs avaient franchi un seuil jusque-là réservé à l’intelligence humaine ; ou bien les échecs s’étaient révélés une tâche de calcul spécialisée plutôt que la mesure de l’esprit qu’on croyait.
Chacune de ces thèses contient du vrai, et aucune ne tranche la question philosophique de fond.
En 2011, Watson d’IBM bat des joueurs humains chevronnés à Jeopardy!, en combinant analyse de la langue, recherche, classement et ingénierie structurée dans un système conçu pour le cadre étroit d’un jeu télévisé. Sa victoire était réelle ; son architecture et les limites de la tâche comptaient.23
Ce n’étaient pas des détours sur la route du chatbot. Ils montraient que des formes différentes de performance d’allure intelligente peuvent se construire avec des combinaisons différentes de méthodes.
Si l’on a sans cesse déplacé la barre, ce n’est pas seulement par refus de reconnaître le mérite des machines. C’est que le succès nous obligeait à voir combien l’intelligence dépasse la tâche que nous avions choisie pour la représenter.
08 · Les données entrent dans l’invention
Le projet ImageNet, présenté en 2009 dans un article de Jia Deng et ses collègues, a permis de bâtir une ressource bien plus vaste, étiquetée de façon hiérarchique, pour reconnaître des objets dans des images. Il a fallu construire des catégories, collecter des images et les faire annoter par des humains. Les données ne sont pas arrivées comme un inventaire objectif et naturel du monde. Des chercheurs et des travailleurs les ont conçues et assemblées.24
En 2012, Alex Krizhevsky, Ilya Sutskever et Geoffrey Hinton montrent qu’un réseau de neurones convolutif profond, entraîné avec une puissance de calcul importante, obtient un résultat spectaculaire en classification sur ImageNet. La portée dépassait une architecture de réseau. C’était la convergence des données d’entraînement, des processeurs graphiques, des techniques d’optimisation, d’une infrastructure de benchmark et d’expériences reproductibles.25
Voyez ce que l’équipe devait désormais rédiger elle-même. Dans un système expert, un humain codait un vaste ensemble de règles de décision. Dans un système neuronal entraîné, les ingénieurs définissaient l’architecture, le procédé d’apprentissage, le jeu de données, les objectifs et l’évaluation ; les représentations ajustées naissaient de l’optimisation.
Le travail a changé de forme. Il n’a pas disparu.
Les biais n’ont pas disparu non plus parce que plus personne n’écrivait les règles à la main. Ce que le jeu de données représentait, ce que le modèle optimisait et ce que le benchmark récompensait restaient des choix humains, parfois explicites, parfois invisibles.
09 · Le monde cesse d’être un benchmark après l’autre
En 2016, AlphaGo de DeepMind bat Lee Sedol par quatre parties à une. Sa réussite s’appuyait sur l’apprentissage profond, l’apprentissage par renforcement et la recherche arborescente. On l’invoque souvent comme preuve que l’apprentissage aurait remplacé l’IA classique. L’architecture réelle raconte une histoire plus intéressante : des méthodes distinctes peuvent se renforcer.26
En 2017, huit chercheurs présentent l’architecture Transformer dans Attention Is All You Need. L’article part de la modélisation de séquences et de la traduction automatique. Sa conception retire le calcul récurrent de l’architecture encodeur-décodeur principale et place l’attention au centre. Ce choix a aidé à rendre plus efficace l’entraînement de modèles de langage à grande échelle. L’article n’annonçait pas que l’intelligence générale était résolue.27
Les années suivantes produisent plusieurs branches, pas un produit inévitable. BERT, publié en 2019 à partir de travaux diffusés en 2018, montre la force du préentraînement bidirectionnel pour la compréhension de la langue. GPT-3, décrit en 2020, montre des capacités frappantes à partir de quelques exemples, issues d’un très grand modèle de langage autorégressif. Les recherches sur la mise à l’échelle documentent des relations empiriques entre calcul, données, taille du modèle et perte, tandis que des travaux ultérieurs sur l’entraînement optimal en calcul remettent en cause l’idée répandue que le nombre de paramètres suffirait à faire le progrès.28293031
Ailleurs, AlphaFold 2 apporte une contribution majeure à la prédiction de la structure des protéines ; l’article de référence paraît en 2021. En 2022, la base de données associée contient des prédictions pour environ 200 millions de structures. Une prédiction n’est pas une structure mesurée expérimentalement, et prédire la forme des protéines n’est pas résoudre la biologie. L’utilité scientifique reste considérable.32
La génération d’images par diffusion ouvre une autre voie vers des systèmes génératifs utiles. L’IA moderne ne convergeait pas uniquement vers une forme de modèle de langage. Elle devenait une famille de techniques industrielles et scientifiques, partageant l’infrastructure de calcul mais résolvant des problèmes différents.33
Plutôt que « Quel modèle est devenu intelligent ? », mieux vaut demander : « Quelles capacités sont devenues assez fiables pour compter, et dans quels contextes ? »
10 · Quand l’interface devint le tournant
Le public se souvient du 30 novembre 2022. OpenAI publie ChatGPT comme aperçu de recherche conversationnel. Ce jour-là, on n’invente ni les transformers, ni les réseaux de neurones, ni les modèles de langage. C’est une interface, une recette d’entraînement, une décision de diffusion et un moment culturel qui rendent une catégorie de systèmes jusque-là spécialisés exceptionnellement faciles à interroger.34
Les travaux sur le retour humain et le suivi d’instructions ont aidé à transformer la simple prédiction de texte en modèles qui se comportaient plus souvent en assistants. Le travail sur InstructGPT, en 2022, est ici particulièrement important. Les préférences humaines pouvaient façonner le comportement des modèles, mais optimiser pour des préférences ne confère pas d’office la véracité, la compétence dans un domaine ni un devoir envers les intérêts réels de l’utilisateur.35
GPT-4, présenté en mars 2023, élargit l’idée que le public se fait de ce qu’un seul modèle peut accomplir sur des tâches et des types d’entrées variés, alors même que son développeur en documente les faiblesses, dont des réponses fausses assénées avec assurance. D’autres groupes ouvrent plus largement l’accès aux poids des modèles et contestent la centralisation de ces capacités. Avoir accès aux poids n’est toutefois pas avoir pleinement accès aux données d’entraînement, au calcul, à la documentation ou aux moyens de recréer le système de façon indépendante.3637
L’interface a compté parce qu’elle a changé l’échelle à laquelle on adopte une technologie. Les systèmes antérieurs exigeaient souvent une équipe de recherche ou une application dédiée. Un chatbot invitait presque n’importe qui à essayer des milliers d’usages, simplement en tapant. Pour la première fois, beaucoup de gens rencontraient l’IA non comme une fonction étroite d’un produit, mais comme un interlocuteur à tout faire.
La technologie devenait plus facile à comprendre en surface, et bien plus difficile à évaluer sérieusement.
Nous avons vu un paradoxe remarquable : plus les systèmes devenaient fluides, plus les utilisateurs devaient travailler pour distinguer l’éloquence de la preuve, l’achèvement de l’exactitude, et la suggestion utile de la décision autorisée.
11 · Ce que les courbes de benchmark laissent hors de l’histoire
Le progrès mesuré en précision et en vitesse est réel. Mais il n’est pas toute l’histoire.
En 2018, Joy Buolamwini et Timnit Gebru documentent d’importants écarts d’erreur dans des systèmes commerciaux de classification du genre. Leur étude Gender Shades rappelle qu’une bonne performance moyenne peut cacher qui subit les échecs. Ses résultats valent pour les systèmes, le jeu de données et la tâche étudiés ; il ne faut pas les reporter comme taux d’erreur universels sur chaque modèle ultérieur.38
En 2021, l’article Stochastic Parrots d’Emily Bender, Timnit Gebru, Angelina McMillan-Major et Shmargaret Shmitchell met en garde contre les risques liés à l’échelle des données d’entraînement, aux coûts environnementaux, à l’opacité et aux torts sociaux. Certaines de ses thèses sur ce que les modèles de langage peuvent comprendre restent débattues. Son importance historique ne dépend pas de tenir pour tranché l’un ou l’autre camp de ce débat philosophique.39
Les données d’entraînement sont collectées, sous licence, filtrées, annotées et parfois contestées. Derrière les jeux de données, il y a des créateurs, des travailleurs, des langues, des institutions et des rapports de force inégaux. Derrière le déploiement industriel, il y a l’infrastructure, l’électricité, le refroidissement, les politiques nationales et la concentration des marchés. Derrière un système présenté comme autonome, il y a souvent des évaluations humaines, des interventions de sécurité, des autorisations d’outils et des opérateurs qui traitent les exceptions.
En 2024, le règlement européen sur l’intelligence artificielle entre en vigueur, un cadre juridique fondé sur les risques dont les dispositions s’appliquent par étapes. Aux États-Unis, le AI Risk Management Framework du NIST propose une structure de gouvernance volontaire. Ce sont des instruments différents. Aucun ne clôt le débat. Leur apparition est en soi un tournant historique : évaluer l’IA ne se résume plus à savoir si elle fonctionne. Il s’agit aussi de ce que la société lui permet de faire, de qui peut contester un résultat et de qui doit le corriger.4041
C’est ici que l’histoire de l’intelligence artificielle devient une histoire des institutions. La question « Peut-on l’automatiser ? » appelle une compagne nécessaire : « Sous quelle autorité, avec les informations de qui, et avec quel droit de refuser ? »
12 · 2024–2026 : plus de raisonnement, plus d’autonomie, plus d’exposition
À partir de 2024, les développeurs d’IA mettent de plus en plus en avant des modèles entraînés à consacrer davantage de calcul aux tâches difficiles, ainsi que des systèmes capables d’appeler des outils et d’enchaîner des travaux en plusieurs étapes. OpenAI présente ses modèles de raisonnement o1 en septembre 2024. DeepSeek-R1, publié en 2025, montre à quelle vitesse les méthodes axées sur le raisonnement se diffusent d’un laboratoire et d’un pays à l’autre. Les étiquettes raisonnement et agent sont des descriptions de produit utiles, pas des verdicts philosophiques admis sur l’esprit ou l’intention.4243
Le progrès mesuré est considérable. Selon l’AI Index 2026 de Stanford, le taux de réussite des meilleurs agents sur OSWorld, un benchmark d’utilisation d’ordinateur, est passé d’environ 12 % à 66,3 % au cours de 2025. Le même rapport indique que les robots n’ont réussi que 12 % de tâches domestiques réelles, malgré des performances bien meilleures en simulation. Des benchmarks, des tâches, des dates et des protocoles différents ne doivent pas être fondus en un seul chiffre baptisé intelligence.44
Le même rapport constate que l’industrie a produit plus de 90 % des modèles de pointe notables en 2025, et que l’AI Incident Database a recensé 362 incidents d’IA documentés pour cette année, contre 233 en 2024. Ce décompte reflète les signalements et la documentation autant que les événements eux-mêmes ; ce n’est pas un recensement complet des torts causés par l’IA. Mais il montre que capacité, concentration et exposition évoluent désormais ensemble.4546
Cela ne veut pas dire que les systèmes autonomes ne marchent jamais. Cela veut dire qu’il faut juger la performance agentique au niveau de la tâche, de l’environnement, de l’autorité accordée, de la possibilité de rattraper les erreurs et de la fréquence des interventions humaines. Réussir un épisode de benchmark n’est pas gérer la paie d’une entreprise, traiter des données de patients ou mettre en production sans surveillance.
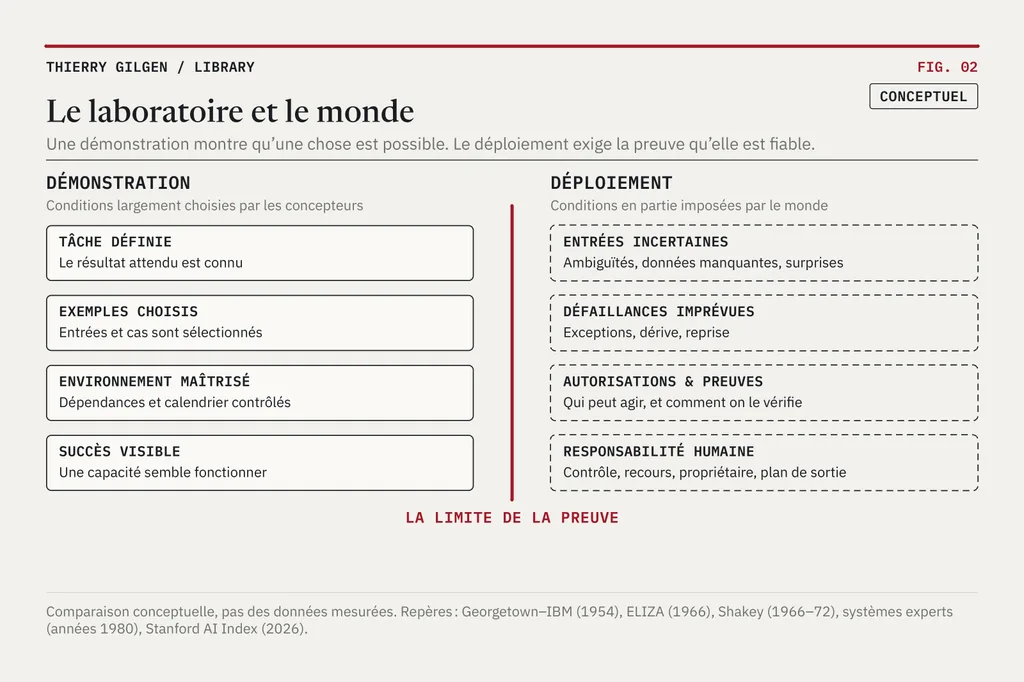
Les chercheurs de 1955 voulaient des machines capables d’utiliser le langage et de s’améliorer elles-mêmes. En 2026, cette ambition n’est plus seulement rhétorique. Mais les questions pratiques que leur proposition pouvait laisser de côté (coût, propriété, données, sécurité, souveraineté, besoins environnementaux, reprise après incident et responsabilité) sont désormais inséparables de la technologie.
13 · Sept choses que cette histoire ne cesse de nous dire
1. La démonstration n’est pas le déploiement. La vitrine de traduction de Georgetown, le dialogue fluide d’ELIZA, les premiers robots mobiles, les victoires dans les jeux télévisés et les benchmarks d’agents d’aujourd’hui enseignent tous la même distinction. Une performance obtenue dans un environnement construit ne se transpose pas en silence au monde non maîtrisé.
2. L’apprentissage n’est pas venu après le raisonnement. Méthodes symboliques, méthodes neuronales, statistiques, rétroaction et recherche sont emmêlées depuis des décennies. L’histoire n’est pas une succession ordonnée de religions qui s’excluent.
3. Le benchmark n’est pas l’esprit. Le jeu d’échecs, la classification d’images, la qualité de traduction, les mathématiques de benchmark et l’exécution de tâches sur ordinateur sont des réussites réelles. Aucune n’est à elle seule la preuve d’une compréhension, d’une conscience, d’un jugement ou d’une capacité morale semblables à ceux des humains.
4. Le travail humain se déplace. Les règles ont cédé la place aux données, les jeux de données au préentraînement à grande échelle, les réponses figées aux agents outillés. À chaque étape, des humains ont fixé les objectifs, choisi les preuves, donné leur avis, fourni l’infrastructure et porté la responsabilité quand le système échouait.
5. L’économie choisit quelles inventions entrent dans l’histoire. Un calcul plus rapide, un stockage moins cher, des jeux de données, l’adoption par les organisations et le soutien des investisseurs peuvent faire d’une vieille technique la percée d’une nouvelle décennie. Une histoire écrite uniquement comme une suite d’articles scientifiques le cache.
6. L’hiver est un jugement sur des promesses, pas une absence de progrès. Des travaux importants ont continué pendant que l’argent et l’attention migraient. La disparition d’un gros titre ne prouve pas l’échec de la recherche qui se trouve derrière.
7. Capacité et autorité sont deux choses différentes. Savoir produire une réponse juste ne donne pas le droit d’accéder à un jeu de données, de se faire passer pour un professionnel, de dépenser l’argent d’autrui ou d’agir sans voie de recours ni de réparation.
14 · La question qu’il aurait fallu poser depuis le début
Il existe une manière tentante de finir cette histoire. On aligne les jalons, on ajoute une courbe de calcul croissant, et l’on conclut que les machines approchent de leur destination inévitable.
Mais une chronologie peut être une piètre explication. Elle met les percées bout à bout et donne au chemin l’air d’avoir été voulu. L’histoire n’a rien eu de voulu. Des chercheurs ont misé sur des théories rivales. Des produits commerciaux ont réussi pour des raisons que la philosophie n’avait pas prévues. Les financements ont disparu puis sont revenus. Un algorithme a pu être ignoré pendant vingt ans avant de trouver soudain le matériel et les données qu’il lui fallait. Un système de dialogue rudimentaire a pu en dire plus sur la confiance humaine qu’une prouesse scientifique bien plus compliquée.
Ada Lovelace prévenait que toute machine nouvelle nous pousse d’abord à surestimer ses pouvoirs, puis, déçus, à sous-estimer ce qu’elle sait vraiment accomplir.3 Près de deux siècles d’intelligence artificielle n’ont pas aboli ce rythme.
Les systèmes actuels font des choses qui auraient stupéfié les organisateurs de Dartmouth. Cela compte. Le progrès n’est pas une illusion. Il n’autorise pas pour autant à supposer que le prochain système fera ce que le précédent ne savait pas faire, ni que des réponses fluides garantissent une action fiable.
Peut-être l’histoire de l’IA ne porte-t-elle donc pas d’abord sur le moment où les machines deviennent intelligentes. Elle porte sur le moment, sans cesse répété, où les humains décident quelles capacités ils appellent intelligence, et sur ce qui se passe quand ces capacités quittent le laboratoire.
Chaque génération a voulu régler la question par une nouvelle démonstration.
La question la plus lourde de conséquences vient après.
Qui comprend assez la machine pour la gouverner, qui peut la contredire quand elle se trompe, et qui peut encore l’éteindre ?
Cette question attendait déjà en 1843. Elle attend de nouveau en 2026.
Repères historiques : quelques jalons
| Année | Jalon | Ce qui a changé, et ce qui n’a pas changé |
|---|---|---|
| 1843 | Notes de Lovelace sur la machine analytique, jamais construite, de Babbage | Une machine symbolique programmable est imaginée ; pas encore d’IA en état de marche |
| 1936 | Article de Turing sur la calculabilité | Limites et possibilités formelles du calcul mécanique |
| 1943 | Modèle de neurone de McCulloch et Pitts | Lien mathématique entre réseaux, neurones et logique |
| 1948 | Cybernetics de Wiener | La rétroaction et la commande comme cadre commun aux organismes et aux machines |
| 1950 | Jeu de l’imitation de Turing | Un test du comportement d’allure intelligente, pas de la conscience |
| 1954 | Démonstration de traduction Georgetown–IBM | Une vitrine linguistique qui fonctionne, dans un cadre très restreint |
| 1955 / 1956 | Proposition / projet d’été de Dartmouth | Un domaine reçoit son nom, pas une théorie commune |
| 1958 / 1959 | Perceptron de Rosenblatt / jeu de dames de Samuel | Des systèmes apprenants à côté des travaux symboliques |
| 1966 | ELIZA et rapport ALPAC | Un dialogue persuasif à côté du scepticisme institutionnel |
| 1966–1972 | Projet de robot Shakey | Planification, perception et mouvement intégrés, sous contraintes |
| 1973 | Critique de Lighthill et débat public | De fortes attentes face à un examen sévère |
| années 1980 | Systèmes experts ; cinquième génération japonaise | Une vraie valeur pour des tâches spécialisées ; limites de maintenance et de généralité |
| 1986 / 1989 | Article sur la rétropropagation / lecture d’écriture manuscrite | Apprendre des représentations devient manifestement utile |
| 1997 | Deep Blue gagne le match contre Kasparov | Supériorité de la machine dans un jeu bien défini, pas une cognition générale |
| 2009 | Présentation du jeu de données ImageNet | De grandes collections d’images étiquetées fondent des benchmarks reproductibles |
| 2011 | Watson d’IBM gagne à Jeopardy! | Réponse aux questions sophistiquée, dans un cadre étroit |
| 2012 | AlexNet bouleverse les résultats sur ImageNet | Processeurs graphiques et réseaux profonds deviennent décisifs en vision |
| 2016 | AlphaGo bat Lee Sedol | Apprentissage profond renforcé par la recherche et le jeu contre soi-même |
| 2017 | Publication du Transformer | La modélisation par attention refaçonne l’IA du langage |
| 2018–2020 | BERT, GPT-3 et études de mise à l’échelle | Préentraînement large et transfert d’une tâche à l’autre |
| 2021 / 2022 | Article sur AlphaFold 2 / prédictions publiées à grande échelle | Grande utilité pour la science ; les prédictions restent des prédictions |
| 2022 | Systèmes de diffusion, InstructGPT, ChatGPT | Les capacités génératives deviennent accessibles au public |
| 2023 | GPT-4 ; modèle de recherche LLaMA | Capacités multimodales et stratégies d’accès concurrentes |
| 2024 | Règlement européen sur l’IA en vigueur ; accent sur les modèles de raisonnement | La gouvernance et le calcul à l’inférence gagnent en importance |
| 2025–2026 | Concurrence des modèles de raisonnement ; agents outillés | De meilleures performances sur des tâches réelles, des lacunes de fiabilité persistantes |
Méthode et note éditoriale
Ce volume est une synthèse historique, pas l’histoire définitive de chaque sous-domaine de l’IA. Les dates s’appuient autant que possible sur les articles originaux, les archives officielles et les documents des institutions. L’essai distingue un article de recherche, une démonstration publique, un déploiement commercial et une rétrospective ultérieure. Ses jugements, notamment sur l’engouement, la confiance et les limites des benchmarks, sont des interprétations éditoriales fondées sur ces sources, non des affirmations qu’elles font elles-mêmes. Les points contestés sont signalés comme tels dans le texte : les titres de « premier programme » autour de Lovelace, la paternité de la rétropropagation, les causes et la portée des hivers de l’IA, et le passage du benchmark au monde.
Les jalons laissent de côté d’importantes contributions individuelles, régionales et disciplinaires, dont la cybernétique soviétique et une grande partie de la recherche d’Europe continentale, du Canada et de Chine. Leur choix vise à expliquer des changements conceptuels, non à attribuer un mérite exclusif. Toutes les observations sur la technique et les politiques reflètent l’état de la recherche au 20 octobre 2026. Les sources ci-dessous indiquent, pour chaque référence, de quel type de preuve il s’agit et ce qu’elle ne montre pas.
Sources
Footnotes
-
McCarthy, Minsky, Rochester and Shannon, Dartmouth AI summer project proposal (1955). www-formal.stanford.edu; source complémentaire : doi.org. Proposition originale (archives de Stanford ; republiée par AI Magazine). Datée du 31 août 1955. Une proposition n’est pas le résultat de l’atelier de 1956. ↩ ↩2
-
Dartmouth project fiftieth-anniversary retrospective (2006 on 1956). doi.org. Rétrospective de témoins, 2006. Témoignage écrit cinquante ans après ; recoupé avec la proposition. ↩ ↩2
-
Ada Lovelace, Notes to Sketch of the Analytical Engine (1843). psychclassics.yorku.ca; source complémentaire : www.hsm.ox.ac.uk. Texte historique primaire. La machine n’a jamais été construite telle que conçue ; les titres de « premier programme » ou de précurseur de l’IA sont discutés. ↩ ↩2
-
Alan M. Turing, Computing Machinery and Intelligence (1950). academic.oup.com. Article original. Un test de comportement, pas un test validé de la conscience. ↩ ↩2
-
Alan M. Turing, On Computable Numbers (1936/1937). doi.org. Article mathématique original. Reçu en 1936 ; l’éditeur date le volume de 1937. ↩
-
Warren McCulloch and Walter Pitts, A Logical Calculus of the Ideas Immanent in Nervous Activity (1943). doi.org. Article de recherche original. Neurones mathématiques stylisés, pas les architectures entraînables d’aujourd’hui. ↩
-
Norbert Wiener, Cybernetics (1948). direct.mit.edu. Monographie originale. Première édition en 1948 ; l’édition en ligne est une réimpression récente. ↩
-
Georgetown–IBM machine translation demonstration (1954). aclanthology.org; source complémentaire : www.ibm.com. Étude historique spécialisée ; archives d’IBM. Une démonstration restreinte, pas une traduction généraliste. ↩
-
Frank Rosenblatt’s perceptron (1958). news.cornell.edu. Rétrospective universitaire. Écrite avec le recul. ↩
-
Arthur Samuel, Some Studies in Machine Learning Using the Game of Checkers (1959). doi.org. Article de recherche original d’IBM. Pas une revendication du « premier » système apprenant. ↩
-
Joseph Weizenbaum, ELIZA—A Computer Program for the Study of Natural Language Communication Between Man and Machine (1966). doi.org. Article de recherche original. À base de règles ; ELIZA ne partage pas le mécanisme d’entraînement des modèles de langage. ↩
-
ALPAC, Language and Machines: Computers in Translation and Linguistics (1966). www.nationalacademies.org; source complémentaire : www.nationalacademies.org. Rapport original du National Research Council américain. Ses effets ont varié selon les financeurs, les langues et les pays. ↩
-
SRI, Shakey the Robot (1966–1972). www.sri.com; source complémentaire : www.darpa.mil. Rétrospective de recherche ; archives institutionnelles. Environnement contrôlé ; les institutions aiment souligner leurs premières. ↩
-
Minsky and Papert, Perceptrons, and reassessments of AI winter (1969). www.open.edu; source complémentaire : ai100.stanford.edu. Synthèses historiques. Évite le récit selon lequel un seul livre aurait arrêté la recherche sur les réseaux de neurones. ↩
-
Lighthill debate/report at University of Edinburgh (1973). www.aiai.ed.ac.uk. Archives du rapport et du débat (Université d’Édimbourg). Rapport écrit en 1972, publié et débattu en 1973 ; pas un arrêt général de l’IA. ↩
-
DENDRAL, MYCIN and XCON expert-system era (1960s–1980s). doi.org; source complémentaire : ai100.stanford.edu. Étude de cas originale sur XCON ; synthèse historique. Applications restreintes et entretenues ; un succès précoce ne prouvait pas une intelligence large. ↩
-
Japanese Fifth Generation Computer Systems project (1982–1992). museum.ipsj.or.jp. Musée informatique de la Société japonaise de traitement de l’information. Des ambitions commerciales déçues ne signifient pas une absence d’apport scientifique. ↩
-
Karen Spärck Jones, A Statistical Interpretation of Term Specificity (1972). doi.org. Article original en recherche d’information. Un précurseur influent, pas l’unique origine du traitement statistique de la langue. ↩
-
Speech Recognition with Continuous-Parameter Hidden Markov Models (1987). research.ibm.com. Publication de recherche d’IBM. Un courant de recherche, pas un panorama complet de l’IA statistique. ↩
-
Rumelhart, Hinton and Williams, Learning Representations by Back-Propagating Errors (1986). doi.org. Article de recherche original. Pas la première formulation de la rétropropagation. ↩
-
LeCun et al., Backpropagation Applied to Handwritten Zip Code Recognition (1989). direct.mit.edu. Article de recherche original. Une tâche étroite ; le déploiement commercial s’est développé ensuite. ↩
-
IBM, Deep Blue (1997). www.ibm.com. Archives historiques d’IBM. Source d’entreprise ; pas la première victoire d’un ordinateur sur un humain aux échecs. ↩
-
IBM, Watson and Jeopardy! (2011). www.ibm.com. Archives historiques d’IBM. Un cadre de compétition conçu sur mesure, pas un raisonnement général. ↩
-
Deng et al., ImageNet: A Large-Scale Hierarchical Image Database (2009). collaborate.princeton.edu. Communication originale. La taille de 2009 diffère des extensions ultérieures d’ImageNet. ↩
-
Krizhevsky, Sutskever and Hinton, ImageNet Classification with Deep Convolutional Neural Networks (2012). papers.nips.cc. Communication originale. Les résultats dépendent du jeu de test, de la mesure et de l’année. ↩
-
DeepMind, AlphaGo versus Lee Sedol (2016). deepmind.google. Rétrospective du développeur. Source du développeur ; affirmations limitées au match. ↩
-
Vaswani et al., Attention Is All You Need (2017). arxiv.org. Article de recherche original. Paru en 2017 ; les usages ultérieurs n’étaient pas écrits d’avance. ↩
-
Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding (2018/2019). aclanthology.org. Communication originale. Prépublication 2018, actes 2019. ↩
-
Brown et al., Language Models Are Few-Shot Learners (GPT-3) (2020). arxiv.org. Article de recherche original. Sensible aux consignes et à l’évaluation ; pas une preuve de véracité. ↩
-
Kaplan et al., Scaling Laws for Neural Language Models (2020). arxiv.org. Prépublication originale. Ajustements empiriques valables dans un régime donné, pas des lois physiques. ↩
-
Hoffmann et al., compute-optimal language-model training (Chinchilla) (2022). deepmind.google. Synthèse de recherche du développeur. Source du développeur ; aucun nombre de paramètres ne détermine à lui seul l’utilité. ↩
-
Jumper et al., highly accurate protein structure prediction with AlphaFold; EMBL-EBI database expansion (2021/2022). www.nature.com; source complémentaire : www.ebi.ac.uk. Article original ; publication de la base EMBL-EBI. Des prédictions calculées ne sont pas des structures mesurées expérimentalement. ↩
-
Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models (2022). openaccess.thecvf.com. Communication originale. Ne recouvre pas tous les générateurs d’images. ↩
-
OpenAI, Introducing ChatGPT (30 November) (2022). openai.com. Annonce du fournisseur. Source du fournisseur ; établit la date de lancement, pas l’impact indépendant. ↩
-
Ouyang et al., Training Language Models to Follow Instructions with Human Feedback (2022). arxiv.org. Article de recherche original. Optimiser pour les préférences humaines ne garantit pas l’exactitude. ↩
-
OpenAI, GPT-4 Research (2023). openai.com. Rapport du développeur. Évaluation déclarée par le développeur. ↩
-
Meta AI, Introducing LLaMA (2023). ai.meta.com. Annonce du développeur. Des poids ouverts ne sont ni un processus d’entraînement ni des données ouverts. ↩
-
Buolamwini and Gebru, Gender Shades (2018). proceedings.mlr.press. Article évalué par les pairs. Écarts propres aux systèmes et à la période étudiés. ↩
-
Bender et al., On the Dangers of Stochastic Parrots (2021). doi.org. Article évalué par les pairs. Ses thèses philosophiques restent débattues ; citées, non tenues pour acquises. ↩
-
European Commission, AI Act Enters into Force (2024). commission.europa.eu. Communiqué de la Commission européenne. En vigueur depuis le 1er août 2024 ; obligations applicables par étapes, dates susceptibles de changer. ↩
-
NIST, AI Risk Management Framework 1.0 (2023). www.nist.gov. Ressource de l’agence américaine de normalisation. Un cadre volontaire, ni obligation légale ni certification. ↩
-
OpenAI, Learning to Reason with LLMs (2024). openai.com. Annonce du développeur. « Raisonnement » est une étiquette de produit, pas une preuve de pensée. ↩
-
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (2025). arxiv.org; source complémentaire : www.nature.com. Prépublication, puis article évalué dans Nature. Les résultats déclarés dépendent du protocole d’entraînement et de la date. ↩
-
Stanford HAI, AI Index: Technical Performance (2026). hai.stanford.edu. Indice annuel de recherche, chapitre technique. Chiffres propres à chaque benchmark ; jeux de test et références évoluent. ↩
-
Stanford HAI, 2026 AI Index: Top Takeaways (2026). hai.stanford.edu. Indice annuel de recherche, synthèse. Les définitions de « l’industrie » et des « modèles notables » influent sur la part. ↩
-
Stanford HAI, AI Index: Responsible AI (2026). hai.stanford.edu. Indice annuel de recherche, chapitre IA responsable. Les chiffres de l’AI Incident Database dépendent des signalements et des critères d’inclusion. ↩