Cette semaine, un post LinkedIn m’a arrêté.
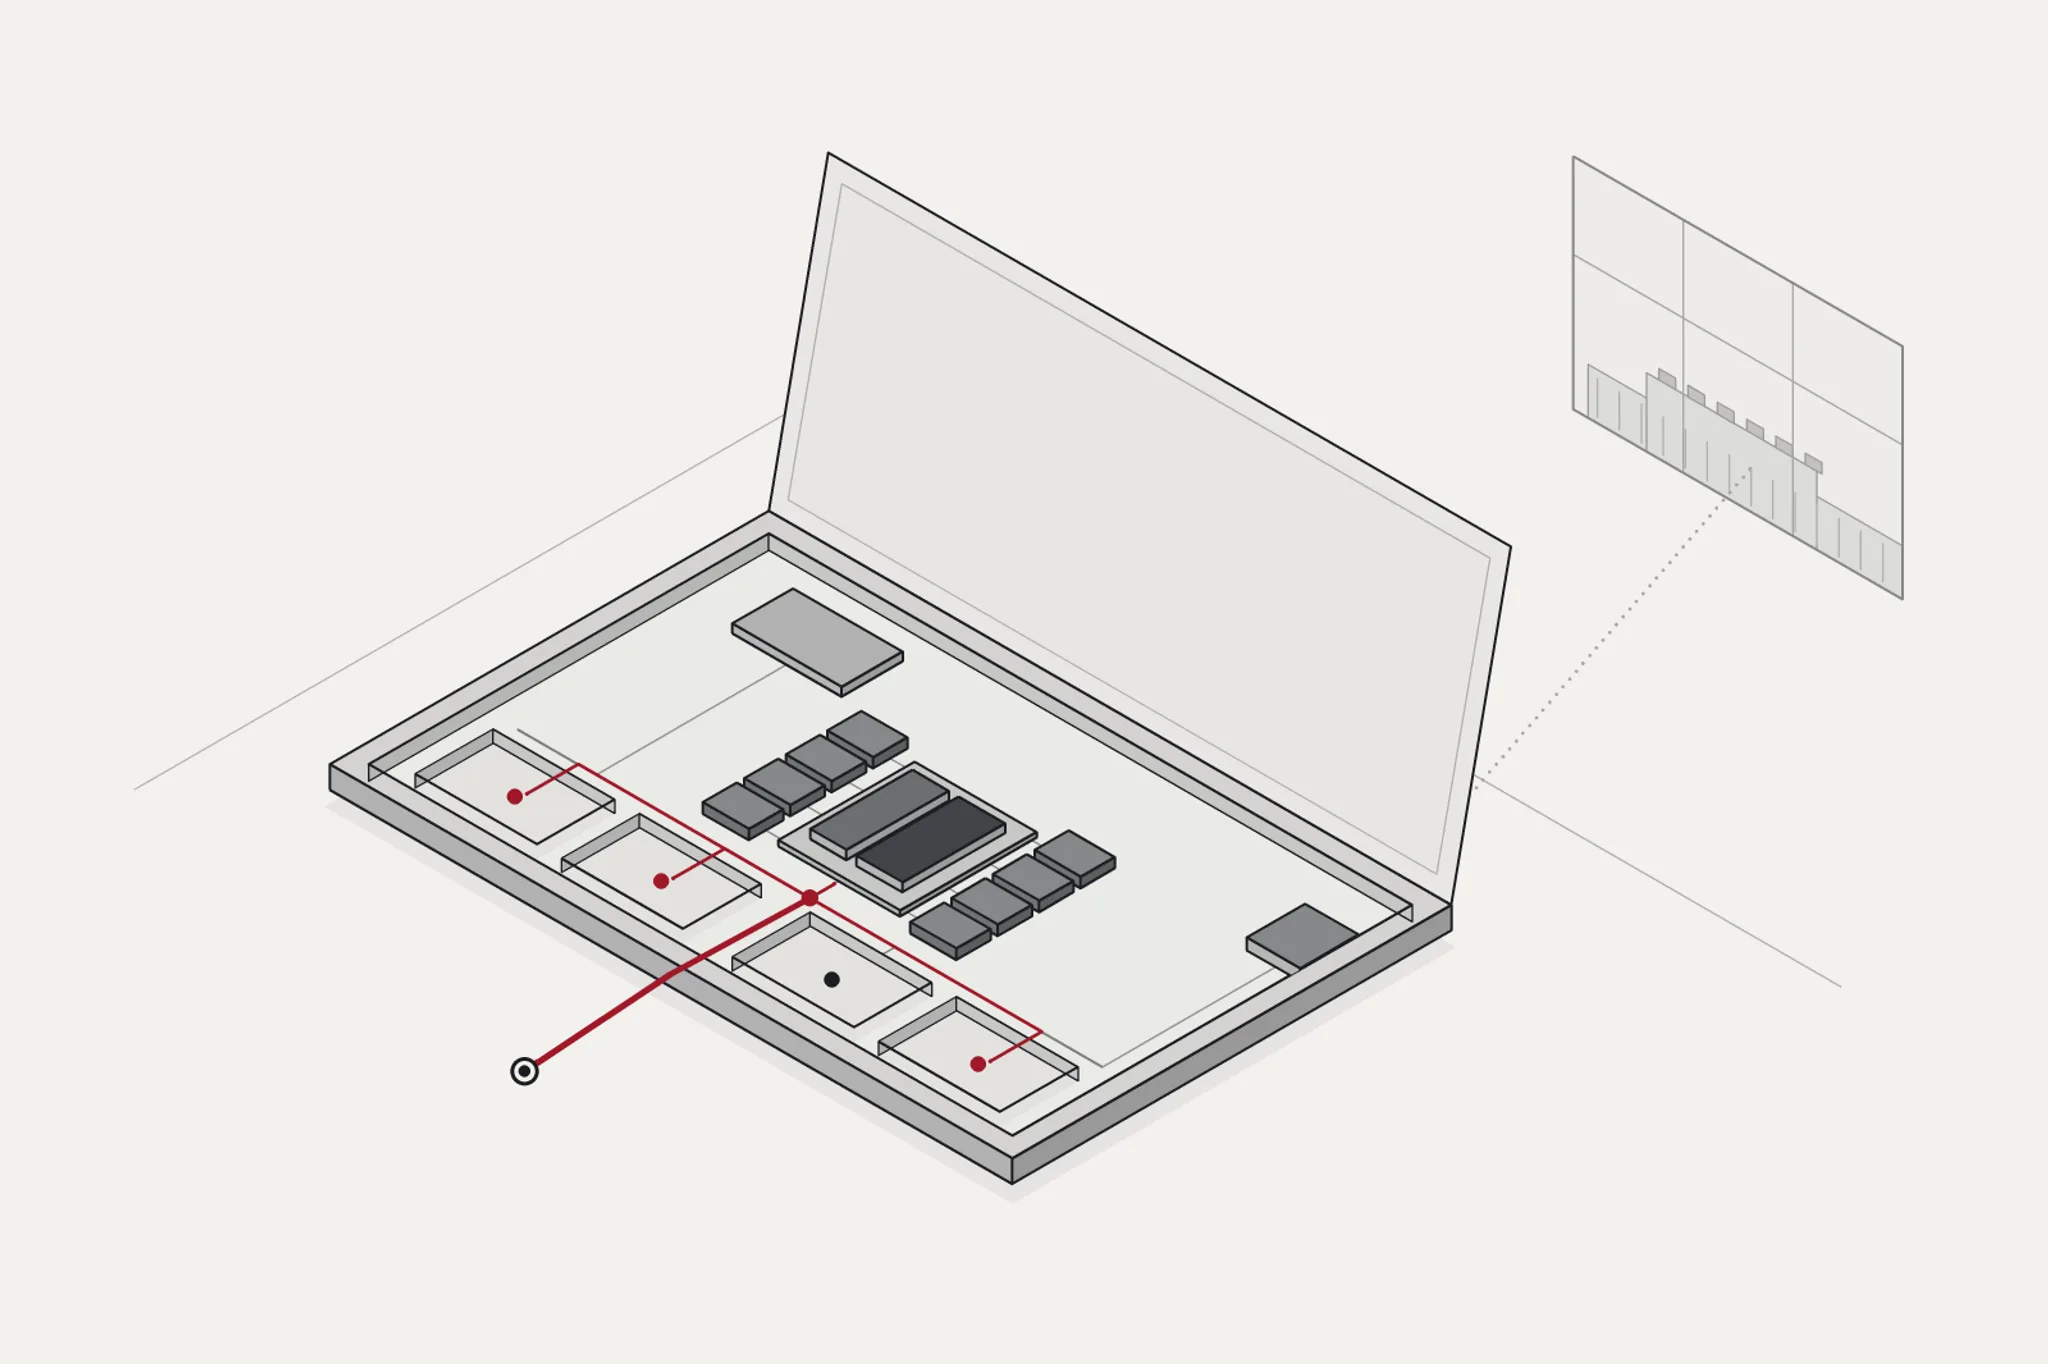
Il présentait RTX Spark, de NVIDIA, comme la fin de l’architecture classique du PC : processeur, carte graphique et mémoire fondus en un seul système, un pétaflop de performance d’IA en local, de grands modèles sans serveur dans le cloud, des agents personnels qui vivent en permanence sur la machine.
La formule était spectaculaire.
Un peu trop, par endroits.
Mais l’intuition, elle, était juste.
Il se passe quelque chose d’important du côté de l’ordinateur personnel.
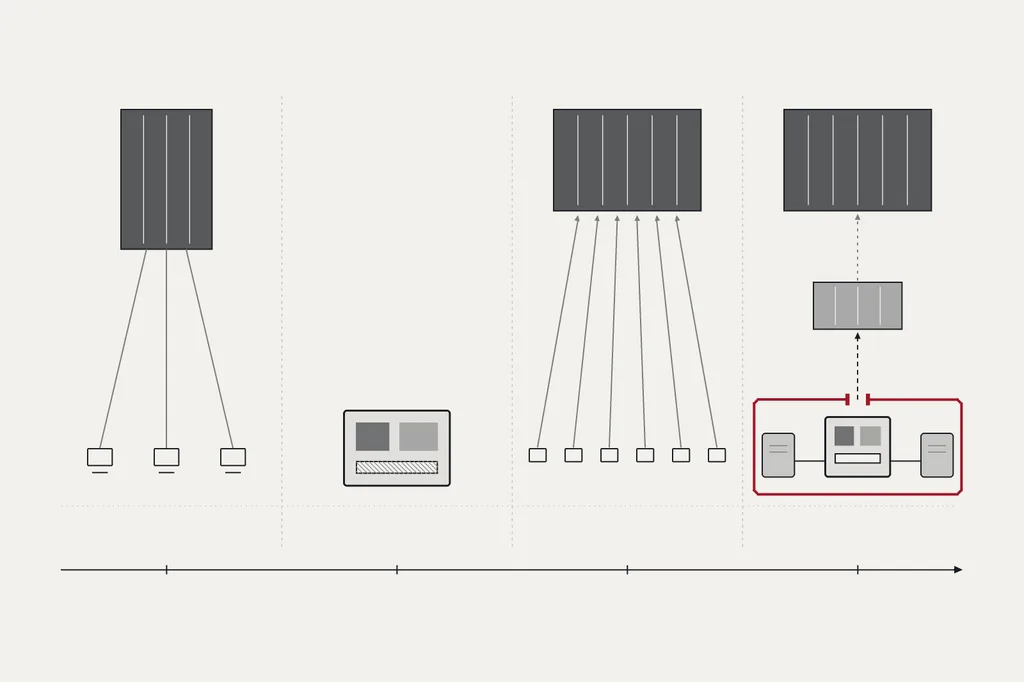
Pendant près de quinze ans, la direction semblait évidente. Nous avons sorti le calcul de nos bureaux pour le confier au centre de données de quelqu’un d’autre. Les serveurs sont devenus des régions cloud. Les logiciels sont devenus des services. Le stockage est devenu un compte. L’intelligence artificielle la plus puissante est devenue un appel d’API.
La machine posée devant nous restait importante, mais de plus en plus comme une fenêtre ouverte sur une infrastructure située ailleurs.
L’IA a accéléré ce mouvement. Ce que mon portable savait faire de plus intelligent se passait souvent ailleurs que sur mon portable.
RTX Spark pointe dans l’autre sens.
Pas un retour aux années 1990. Pas un adieu au cloud. Pas un rêve d’isolement technologique.
Une autre répartition du travail.
L’entraînement peut rester dans d’immenses usines d’IA. On peut toujours faire appel aux modèles de pointe quand il le faut. Mais la mémoire, le contexte, l’inférence, les outils et les agents qui tournent en continu peuvent de plus en plus se trouver à côté de la personne pour qui ils travaillent.
Cela change les performances.
Cela change aussi la propriété.
Et la propriété change la question de la souveraineté.
D’abord, corriger le récit du lancement
La version des réseaux sociaux comprime plusieurs évolutions distinctes en un seul moment spectaculaire.
RTX Spark n’a pas été dévoilé hier. NVIDIA a annoncé la plateforme le 31 mai 2026 à la GTC Taipei, en marge du COMPUTEX. Si le sujet est revenu en septembre, c’est parce que l’annonce devient un produit : à l’IFA 2026, NVIDIA a confirmé l’arrivée des premiers PC Windows RTX Spark en octobre et a présenté d’autres briques de son offre pour agents locaux, dont NVIDIA PAIR, qui répartit les requêtes d’inférence entre plusieurs machines d’un même réseau local.12
L’architecture mérite, elle aussi, de la précision.
RTX Spark associe un GPU Blackwell RTX à un processeur Grace de 20 cœurs basé sur Arm, et prend en charge jusqu’à 128 Go de mémoire LPDDR5X unifiée et cohérente. La documentation de NVIDIA pour les développeurs indique, pour la configuration haut de gamme, une interface mémoire de 256 bits et une bande passante d’environ 300 Go/s.3
Cela ne veut pas dire que le processeur, la carte graphique et 128 Go de RAM ne forment plus, littéralement, qu’un seul morceau de silicium. Cela veut dire que CPU et GPU travaillent sur une architecture mémoire commune et cohérente, au lieu de l’arrangement habituel où le processeur possède la mémoire vive et où une carte graphique séparée dispose de sa propre mémoire vidéo, physiquement distincte.
La nuance compte.
Le pétaflop aussi.
NVIDIA annonce jusqu’à un pétaflop de performance d’IA en FP4. Il s’agit d’une puissance de calcul tensoriel spécialisée, en basse précision, pas d’un pétaflop de calcul quelconque. C’est une capacité importante pour l’inférence de modèles quantifiés, mais le chiffre marketing ne doit pas être pris pour une mesure universelle de la performance des applications.1
L’affirmation selon laquelle le système peut faire tourner des modèles de 120 milliards de paramètres avec un contexte très long relève, elle aussi, de NVIDIA. Ce n’est pas encore un test indépendant sur des machines du commerce. Il est techniquement plausible que des modèles quantifiés de la classe 120B tiennent dans cette quantité de mémoire : le checkpoint de gpt-oss-120b d’OpenAI, par exemple, pèse environ 60,8 Gio et a été conçu pour tenir sur un accélérateur de 80 Go.4 Mais la taille du modèle, la longueur du contexte, la gestion du cache KV, la quantification, la taille des lots et le moteur d’inférence changent tous ce que « tourner en local » veut dire en pratique.
La même prudence vaut pour les jeux. NVIDIA affirme que RTX Spark dépasse 100 images par seconde en 1440p dans les titres AAA ; la presse spécialisée relève que ce chiffre peut reposer largement sur le DLSS et la génération d’images plutôt que sur la puissance de rendu brute.5
Et « pas d’abonnement mensuel » n’est pas une propriété de la puce.
Si j’utilise un modèle à poids ouverts, des outils locaux et un stockage local, alors oui : l’inférence peut se faire sans payer un fournisseur de modèles à chaque token. Mais un agent local peut toujours s’appuyer sur des logiciels par abonnement, des modèles sous licence, une recherche dans le cloud, une messagerie hébergée, des API SaaS, un stockage distant ou le recours à un modèle de pointe.
La formulation juste est plus intéressante que la formulation virale :
RTX Spark rend possible, économiquement et techniquement, une part bien plus grande de l’intelligence machine utile sur un matériel qui appartient à son utilisateur.
C’est déjà beaucoup.
Le chiffre qui compte, c’est 128 Go
Le lancement se vend avec un pétaflop.
Moi, je reviens sans cesse à la mémoire.
L’IA a une propriété brutale : si le modèle et son état de travail ne tiennent pas là où l’accélérateur peut les atteindre efficacement, la puissance de calcul théorique cesse d’être la contrainte intéressante.
Pendant des années, les discussions sur les cartes graphiques grand public tournaient autour de la quantité de mémoire vidéo. Huit gigaoctets. Douze. Seize. Vingt-quatre. Largement assez pour jouer, souvent cruellement insuffisant pour de grands modèles en local.
La mémoire unifiée change cette géométrie.
La configuration haut de gamme de RTX Spark peut offrir jusqu’à 128 Go à une architecture CPU/GPU cohérente.3 Les systèmes AMD Ryzen AI Max+ ont déjà montré pourquoi cela compte : AMD livre des machines dotées de 128 Go de mémoire et les présente explicitement comme capables de faire tourner des modèles de la classe 128B, et même, dans sa communication plus récente sur les « Agent Computers », des modèles locaux encore plus grands, à condition que la quantification et le logiciel s’y prêtent.6 L’actuel M5 Ultra d’Apple pousse la même idée bien plus loin, côté station de travail, avec jusqu’à 512 Go de mémoire unifiée et 1,2 To/s de bande passante mémoire.7
L’idée de la mémoire unifiée n’est donc pas nouvelle.
Ce qui change, c’est à quel point il devient normal de concevoir un ordinateur personnel autour des besoins en mémoire de l’IA, au lieu de traiter l’IA locale comme une tâche d’appoint pour la capacité graphique inutilisée.
Les conséquences dépassent le simple chargement d’un grand modèle de langage.
Un agent utile a besoin de plus que des poids. Il lui faut peut-être un long contexte, des embeddings, des encodeurs visuels, des modèles vocaux, des index de recherche, l’état de ses outils, plusieurs instances de modèles en parallèle, du décodage spéculatif, des caches et parfois plusieurs sous-agents à la fois.
La mémoire devient une ressource stratégique, parce qu’elle détermine quelle part de cet ensemble de travail peut rester près de l’accélérateur.
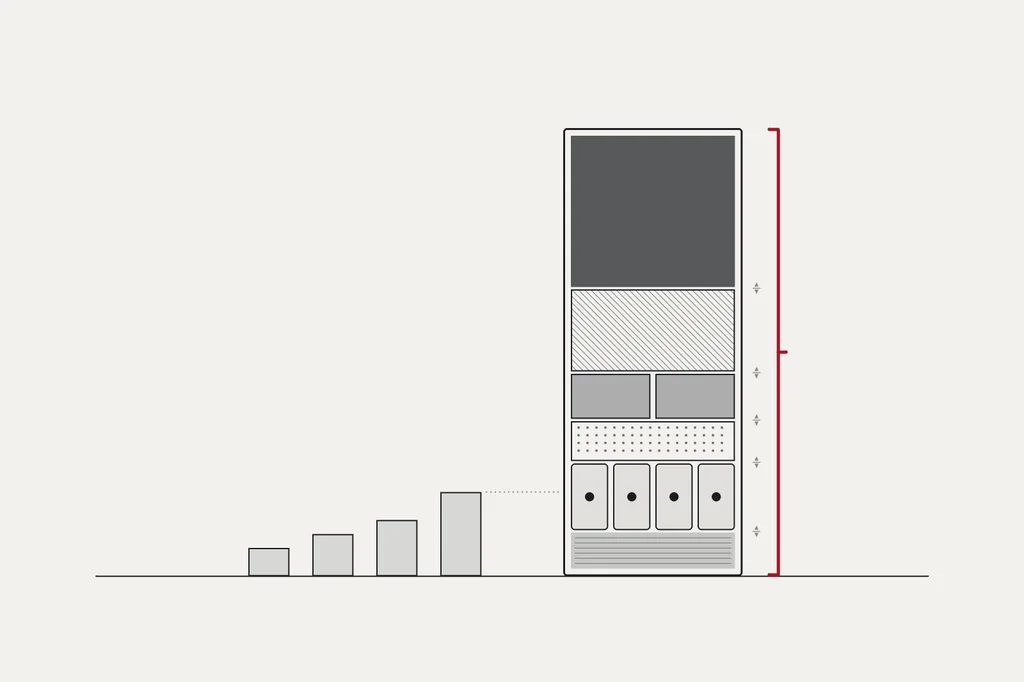
Le modèle qui tient dans la machine peut être plus utile que le modèle théoriquement plus intelligent qui doit traverser le réseau à chaque interaction.
Voilà pourquoi 128 Go comptent peut-être davantage que la diapositive de lancement où s’affiche un pétaflop.
Le pétaflop dit à quelle vitesse la puce calcule.
La mémoire dit quelle quantité d’intelligence peut réellement y habiter.
Le PC devient l’hôte des agents
Une application classique attend.
Je la lance. Je clique. Elle traite une demande. Je la ferme.
Un agent utile fonctionne autrement.
Il observe. Il se souvient. Il reçoit des événements. Il travaille pendant que je fais autre chose. Il peut découper une tâche en sous-problèmes. Il peut appeler des outils, fouiller des fichiers, écrire du code, ouvrir des documents, interroger des modèles, attendre une réponse et reprendre plus tard.
L’endroit physique où vit l’agent devient donc étonnamment important.
Un agent installé à côté de mes fichiers, de mes applications, de mon micro, de mes bases de données locales et de mes appareils peut observer et agir avec moins de latence, sans exporter en permanence du contexte brut. Il peut poursuivre un travail délimité quand l’internet public est coupé. Il peut garder des états intermédiaires sensibles à l’écart d’un service d’inférence tiers. Il peut aussi devenir bien plus dangereux si on lui accorde les mêmes droits que le compte humain sous lequel il tourne.
L’industrie a remarqué la seconde moitié de cette phrase.
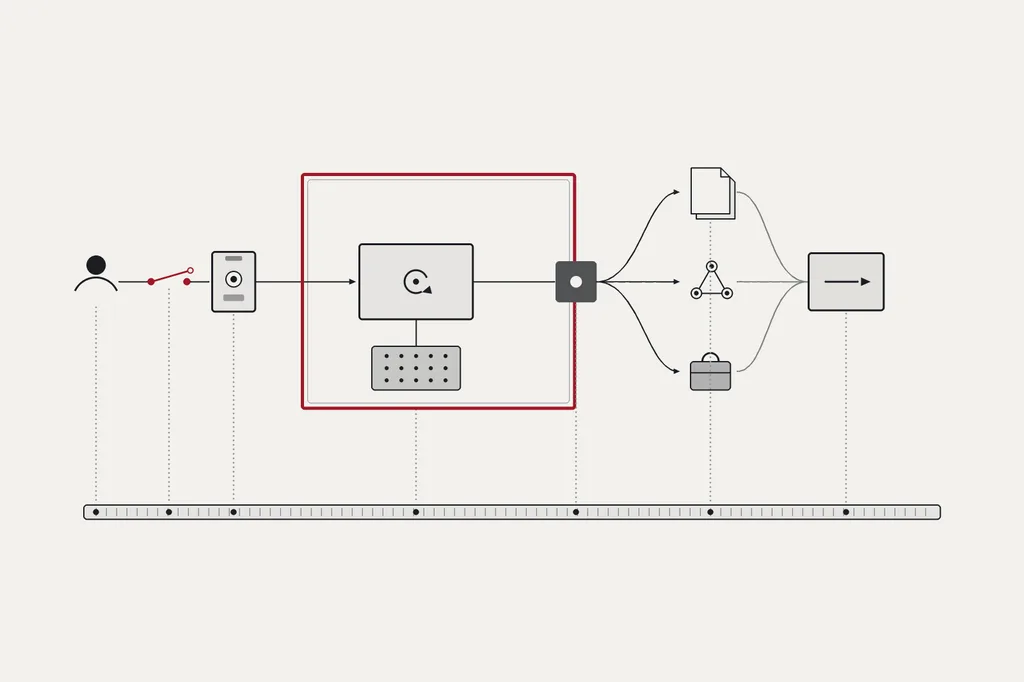
Microsoft fait de l’exécution des agents une affaire de système d’exploitation. Ses Microsoft Execution Containers (MXC) doivent permettre aux développeurs de déclarer ce à quoi un agent a le droit d’accéder, Windows faisant respecter ces limites à l’exécution. Microsoft ajoute aussi des identités propres aux agents et des règles de contrôle, pour qu’un logiciel autonome n’ait pas à hériter de tous les droits de l’utilisateur humain.89
OpenShell, chez NVIDIA, se place à une frontière comparable. Il enferme les agents dans des bacs à sable, refuse tout accès par défaut, contrôle ce qu’ils peuvent atteindre dans le système de fichiers et sur le réseau, sert d’intermédiaire pour les identifiants et oriente l’inférence selon des règles. Le principe de conception essentiel, c’est que la restriction s’applique en dehors du raisonnement de l’agent. On ne demande pas poliment au modèle de respecter la règle ; c’est l’environnement qui empêche l’action.10
C’est un changement bien plus profond qu’un « bouton IA ».
Le système d’exploitation connaissait jusqu’ici des utilisateurs, des processus, des fichiers et des applications.
Il commence à connaître les agents comme des acteurs à part entière.
Il faut donc repenser l’identité, les permissions, l’isolement, l’audit et la révocation pour des logiciels capables de poursuivre des objectifs dans la durée.
Le PC à IA n’est donc pas simplement un PC doté d’un accélérateur neuronal rapide.
C’est une machine que l’on redessine pour accueillir des acteurs à qui l’on a délégué quelque chose.
De l’ordinateur personnel au réseau de calcul personnel
L’annonce la plus intéressante de NVIDIA en septembre n’est peut-être pas le portable.
C’est peut-être PAIR.
NVIDIA Personal AI Router relie des PC RTX compatibles, des systèmes DGX Spark et certains Mac sur un même réseau local, et en fait un endroit où envoyer des requêtes d’inférence locales. PAIR ne fusionne pas leur mémoire en un seul GPU géant et ne découpe pas un modèle à travers toute la maison. Il envoie chaque requête indépendante au nœud compatible qui est disponible.11
C’est précisément ce qui le rend intéressant pour les agents.
Une conversation se déroule souvent pas à pas. Un travail mené par plusieurs agents est, par nature, parallèle.
Un agent inspecte un dépôt de code pendant qu’un autre analyse des documents, qu’un troisième teste une hypothèse et qu’un quatrième vérifie les sources. Si tous font la queue derrière le même serveur d’inférence local, le système ralentit à mesure qu’il devient plus ambitieux.
Si ces requêtes peuvent se répartir sur des machines inoccupées, l’architecture change.
NVIDIA a montré une tâche confiée à cinq sous-agents, terminée en 8 minutes 48 secondes sur trois machines couplées, contre 18 minutes sur un seul portable RTX Spark. C’est une démonstration du fabricant, pas un résultat de performance universel. Elle illustre toutefois la topologie visée.11
Pour un réseau domestique, c’est un petit pas. Pour l’ordinateur personnel, c’est un grand pas.
L’ordinateur personnel, c’était une boîte.
Puis le cloud a rendu cette boîte presque sans importance pour savoir où se faisait le calcul.
Le nouveau modèle de l’IA locale peut faire de la pièce elle-même un petit environnement de calcul : un portable, une station de travail, un mini-PC, un NAS, peut-être un nœud dédié à l’IA, chacun apportant sa capacité sous une même frontière de règles locale.
IDC a observé le même schéma à l’IFA 2026, où des fabricants présentaient des NAS à IA et des mini-PC en grappe destinés aux agents, au RAG et aux modèles locaux. Sa conclusion n’était pas que chaque foyer deviendrait un centre de données, mais que l’infrastructure d’IA locale devient une catégorie de produits à part entière.12
C’est un déplacement significatif.
Le terminal n’est plus seulement le client d’une infrastructure.
Il peut devenir lui-même une infrastructure.
Louer l’intelligence ou posséder la capacité
L’IA dans le cloud a créé une abstraction économique merveilleuse.
Je n’ai pas besoin de posséder l’accélérateur. Ni de le refroidir, ni de le mettre à jour, ni de le remplacer, ni de l’occuper. J’envoie une requête et je paie le service.
Ce modèle est extraordinairement efficace quand la demande est incertaine, que la charge arrive par à-coups, que le meilleur modèle change tous les mois ou que la capacité nécessaire est trop grande pour être possédée de façon rentable.
Mais l’abstraction a un prix.
Chaque token utile reste la capacité de production de quelqu’un d’autre.
Chaque agent qui tourne en continu devient un client récurrent de l’infrastructure d’inférence d’un autre.
Chaque vérification en arrière-plan, chaque classement, chaque boucle de planification, chaque résumé, chaque embedding, chaque choix d’outil et chaque nouvelle tentative peut devenir un événement facturé.
La machine locale change la comptabilité.
Une fois le matériel acheté, une requête d’inférence locale supplémentaire n’est pas gratuite. Elle consomme de l’électricité, de la durée de vie matérielle, du stockage, du temps d’ingénieur et des occasions manquées. Le système se déprécie. Les modèles peuvent le dépasser. La mémoire peut devenir le goulet d’étranglement. Un pilote défaillant peut coûter une journée.
Mais le coût marginal n’obéit plus à la même logique.
Une machine achetée me donne un bloc de capacité que je peux utiliser en continu, sans me demander si dix mille appels internes de plus à un modèle justifient une nouvelle facture d’API.
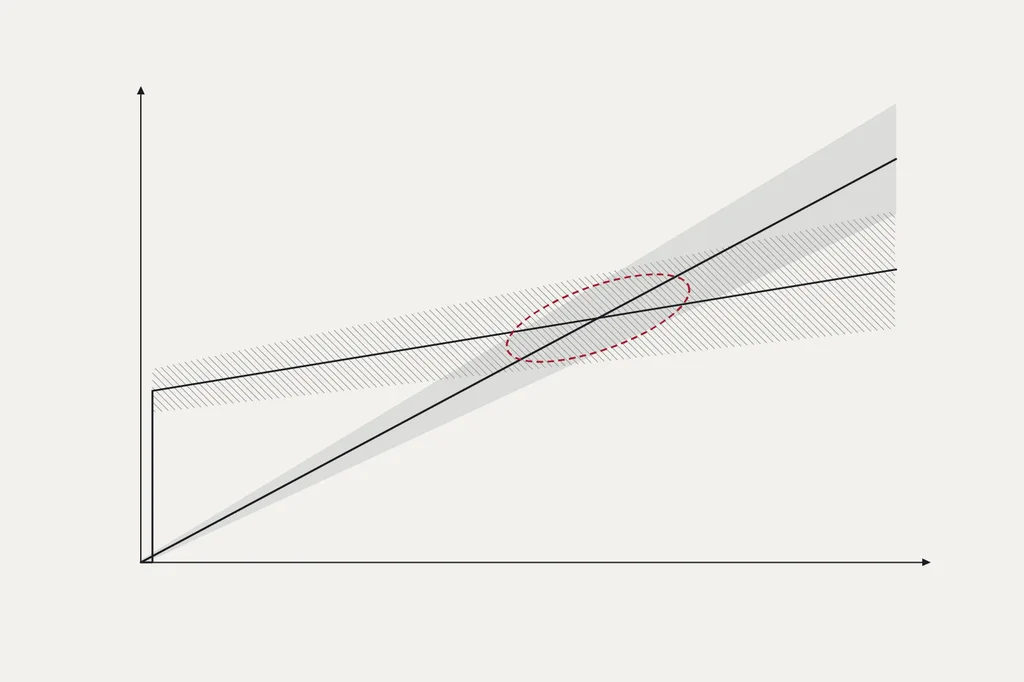
Cela compte surtout pour les systèmes à agents, parce que les agents fabriquent des requêtes.
Un humain pose peut-être une question.
Un agent compétent peut y répondre en faisant cinquante appels à des modèles, en lançant trois sous-agents, en récupérant dix documents, en vérifiant deux fois le résultat et en surveillant un événement à venir.
L’économie d’une réponse et celle d’un travail délégué ne sont pas les mêmes.
C’est là que le calcul local rejoint l’idée que j’ai explorée dans The Compounding Class.
Avoir accès à une réponse n’est pas la même chose que pouvoir commander du travail à des machines. Et pouvoir commander ce travail n’est pas encore posséder l’infrastructure sur laquelle il tourne.
Le matériel d’IA local réduit la distance entre ces niveaux.
Il transforme une partie de l’intelligence machine, qui était une dépense de service, en actif productif.
Pas pour tout le monde.
Pas pour toutes les charges de travail.
Mais assez pour déplacer la frontière.
Ce n’est pas la fin du cloud
On est tenté de raconter l’histoire comme un balancier.
Ordinateur central. PC. Cloud. IA locale.
L’histoire est rarement aussi bien rangée.
L’avenir le plus plausible est fait d’additions.
La prévision de Gartner de septembre 2026 décrit toujours l’infrastructure d’IA des hyperscalers et des fournisseurs de services comme le premier poste de dépenses en IA, la construction de centres de données se poursuivant à une échelle extraordinaire.13
Dans le même temps, les fabricants d’appareils mettent davantage de mémoire et d’accélérateurs dans les machines personnelles.
Les deux peuvent être rationnels, parce qu’ils répondent à des problèmes différents.
Entraîner un modèle de pointe reste une activité de centre de données. Servir des millions d’utilisateurs profite d’une infrastructure mutualisée. Une tâche de raisonnement rare et très difficile peut justifier un modèle cloud bien plus puissant que tout ce qu’il est raisonnable de faire tourner sur un portable. Les entreprises peuvent préférer des grappes privées pilotées de façon centralisée. Les appareils grand public peuvent avoir besoin du cloud quand la batterie, la mémoire ou la latence atteignent leurs limites.
L’architecture Private Cloud Compute d’Apple exprime exactement ce partage, vu depuis l’autre rive : traiter en local quand c’est possible, puis confier certaines requêtes plus difficiles à une infrastructure cloud protégée quand l’appareil ne suffit plus.14
NVIDIA et Microsoft intègrent le routage dans leur pile d’agents pour des raisons comparables. OpenShell peut orienter les requêtes vers les modèles selon des règles, PAIR peut les répartir entre des nœuds locaux, et les points d’accès cloud restent disponibles lorsque c’est autorisé.1011
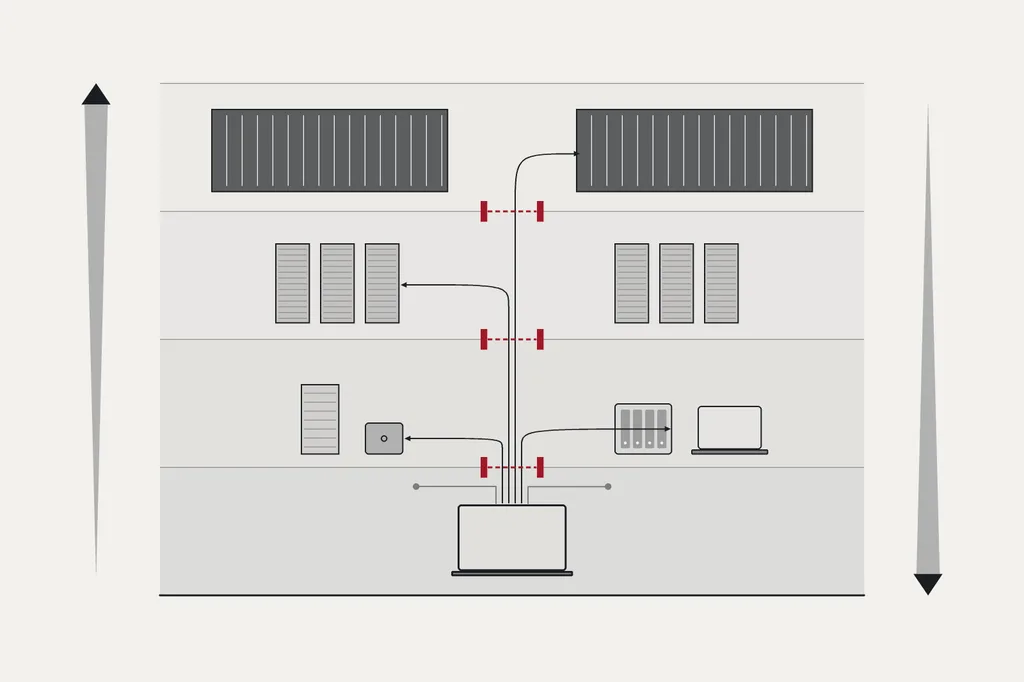
L’avenir ressemble donc moins à « le cloud contre le PC » qu’à une hiérarchie de l’intelligence.
C’est le calcul suffisant le plus proche qui l’emporte.
Un petit modèle se charge de la routine.
Un modèle local plus grand prend le travail privé ou soutenu.
Des machines proches, qui nous appartiennent, absorbent les tâches parallèles.
Une infrastructure privée porte les charges de l’organisation.
Les systèmes de pointe dans le cloud reçoivent les tâches qui les justifient vraiment.
Ce n’est pas de la décentralisation au sens idéologique.
C’est la proximité comme décision d’ingénierie.
Ce que le calcul local nous rend
Il y a ici de vrais gains de souveraineté.
Le premier, c’est la continuité.
Si un modèle, ses poids, son moteur d’inférence et les outils nécessaires sont déjà sur la machine, une panne d’API ou un changement de prix ne fait pas disparaître immédiatement la capacité. Certaines fonctions continuent sans fournisseur de modèles externe.
Le deuxième, c’est la localité des données.
Un contrat, une base de code, des archives familiales, un corpus de recherche ou un document client n’ont pas à quitter l’environnement local simplement pour être résumés, classés ou fouillés. Cela n’élimine pas tous les risques liés aux données, mais supprime par défaut toute une catégorie de transmissions.
Le troisième, c’est la latence.
L’aller-retour vers un modèle distant disparaît pour les tâches qui tiennent en local. Cela compte pour la voix, le code, la vision, l’interaction avec les applications et les agents qui prennent beaucoup de petites décisions.
Le quatrième, c’est la maîtrise des coûts.
La capacité peut se planifier comme un investissement, et pas seulement comme de l’inférence facturée à l’usage. Les organisations peuvent décider où se situe le seuil de rentabilité pour les tâches répétitives.
Le cinquième, c’est le choix du modèle.
Les modèles à poids ouverts peuvent être conservés dans une version connue, testés, affinés, remplacés et exploités après qu’un fournisseur a changé de stratégie pour son API publique.
Le sixième, c’est l’autorité sur l’exécution.
Quand l’environnement d’exécution des agents, les règles et les données sont locaux, il devient techniquement possible de tracer la limite d’autorité autour de l’environnement de l’utilisateur plutôt qu’autour du service du fournisseur.
Ce sont des progrès importants.
Ils ne font pas, à eux seuls, la souveraineté.
Local ne veut pas dire souverain
Une machine peut se trouver sous mon bureau et appartenir quand même, dans son fonctionnement, à une chaîne d’approvisionnement que je ne contrôle pas.
RTX Spark illustre ce paradoxe à merveille.
La plateforme est locale.
Ses dépendances sont mondiales.
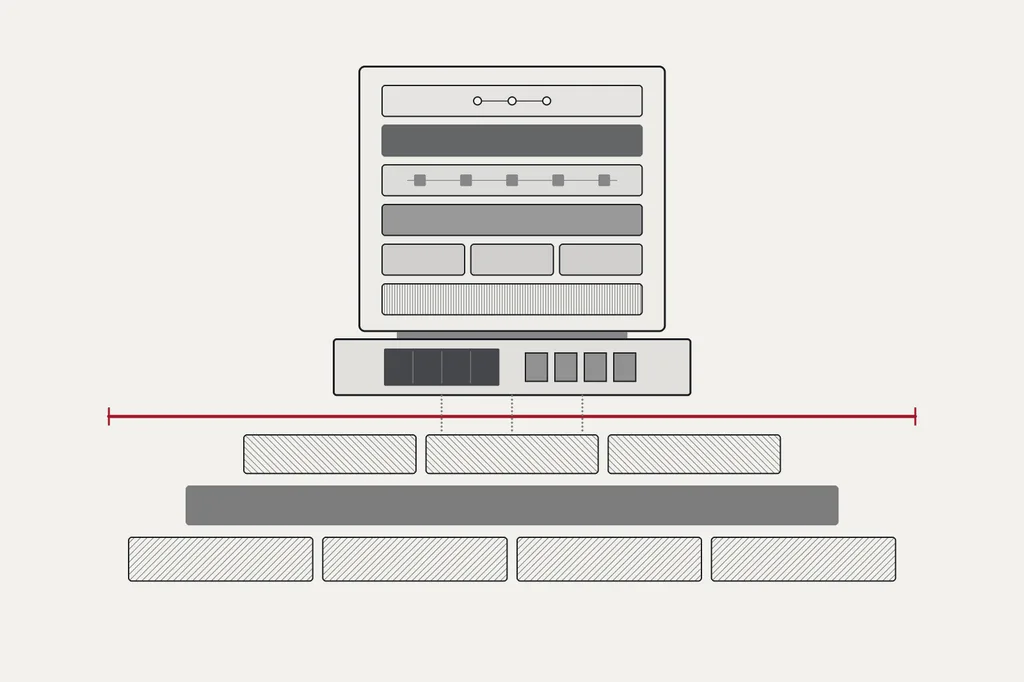
NVIDIA apporte l’architecture GPU Blackwell, CUDA et la pile logicielle d’IA. MediaTek dit avoir contribué par son savoir-faire sur le processeur, le contrôleur mémoire, l’alimentation et la connectivité, et cite explicitement son partenariat de fabrication avec TSMC.15 Le processeur repose sur l’architecture Arm. Le système d’exploitation, c’est Windows. Pilotes, micrologiciels, chaînes de compilation, formats de modèles, moteurs d’inférence et plateformes de distribution des modèles font toujours partie du système utilisable.
Au bout du compte, j’obtiens peut-être plus de contrôle sur l’endroit où l’intelligence s’exécute, tout en rendant l’écosystème logiciel d’un seul fabricant encore plus déterminant pour la manière dont elle s’exécute.
C’est exactement la distinction au cœur d’Open Is Not Sovereign.
Un modèle peut avoir des poids ouverts et dépendre malgré tout d’un environnement d’exécution très concentré.
Un ordinateur peut m’appartenir physiquement et rester difficile à exploiter hors d’un seul écosystème d’accélérateurs.
Un agent local peut se passer d’une API cloud et dépendre malgré tout d’une couche d’identité Microsoft, de pilotes signés, de registres de modèles et de mises à jour logicielles.
Une machine peut continuer à fonctionner pendant une coupure d’internet et rester impossible à remplacer, pour mon organisation, dans un délai raisonnable si l’approvisionnement en matériel disparaît.
La souveraineté n’est pas un champ « lieu » dans un formulaire.
C’est une propriété du système.
La bonne question n’est donc pas :
Cette IA est-elle locale ?
Mais plutôt :
Si un fournisseur, un service ou une couche logicielle importante changeait demain, quelles capacités pourrais-je encore exploiter, réparer, remplacer et comprendre ?
RTX Spark améliore certaines réponses à cette question.
Il ne les apporte pas toutes.
NVIDIA s’attaque au cœur du PC
Pendant des décennies, le PC Windows performant a eu une architecture presque rituelle.
Intel ou AMD fournissait le processeur.
NVIDIA ou AMD fournissait la carte graphique.
La mémoire vive se trouvait du côté du processeur, la mémoire vidéo du côté graphique. Le PCIe reliait les deux mondes.
Le système d’exploitation et les applications étaient très largement x86.
RTX Spark attaque cet agencement par plusieurs côtés à la fois.
Le processeur est basé sur Arm. Le GPU est intégré à la même plateforme cohérente. La mémoire est unifiée. CUDA fonctionne nativement. Le même appareil est vendu à la fois pour le jeu, la création et l’inférence agentique. Et la plateforme arrive par ASUS, Dell, HP, Lenovo, Microsoft et MSI, d’autres suivront.12
Cela ne veut pas dire qu’Intel et AMD vont disparaître.
AMD a déjà une réponse solide avec Ryzen AI Max : compatibilité x86, grande mémoire unifiée et graphique intégré performant rendent l’IA locale possible sans quitter le jeu d’instructions traditionnel de Windows.6
Apple a montré des années plus tôt la force stratégique de l’intégration verticale : maîtriser l’architecture de la puce, le modèle mémoire, le système d’exploitation, les outils de développement et la conception matérielle, puis optimiser toute la machine comme un seul produit. Les puces Apple actuelles poussent cette approche encore plus loin vers l’IA locale.7
Qualcomm a déjà poussé Windows vers Arm avec Snapdragon.
Ce que NVIDIA change, c’est le centre de gravité de la concurrence.
Pour la première fois, l’entreprise devenue la plateforme dominante de l’accélération de l’IA tente aussi de posséder tout le socle de calcul du PC haut de gamme : processeur, GPU, interconnexion, architecture mémoire, compilateur et environnement d’exécution, pile d’agents.
L’ancienne question était de savoir quel processeur devait occuper le centre du PC.
La nouvelle est peut-être de savoir si le PC a encore un centre unique.
Le vrai produit, c’est la pile
Une puce peut se copier, au moins dans son principe.
Une pile logicielle, beaucoup moins.
RTX Spark est intéressant parce que NVIDIA ne vend pas un schéma fonctionnel. L’entreprise réunit autour d’une même plateforme CUDA, TensorRT, le graphisme RTX, les outils Windows on Arm, les optimisations pour llama.cpp et vLLM, les intégrations d’agents locaux, OpenShell, PAIR et les conceptions des fabricants de PC.121011
Sur le plan stratégique, cela compte.
Un accélérateur techniquement supérieur, mais mal pris en charge par les modèles, reste un résultat de benchmark.
Une plateforme que les développeurs peuvent cibler, empaqueter, sécuriser, surveiller et déployer devient une infrastructure.
C’est là que la force de NVIDIA peut devenir la dépendance des autres.
CUDA a de la valeur parce que cela fonctionne, parce que les développeurs le connaissent, parce que les bibliothèques le ciblent et parce que les modèles sont couramment optimisés pour lui.
Chacune de ces raisons est légitime.
Ensemble, elles créent une dépendance au chemin.
Plus la plateforme est complète, plus elle est facile à choisir.
Plus elle est facile à choisir, plus il devient coûteux d’en sortir.
Cela ne rend pas le choix mauvais.
Cela fait de l’architecture de sortie une partie de la conception.
Si je devais évaluer une infrastructure d’IA locale pour une organisation, je regarderais donc plus loin que les tokens par seconde. Je demanderais si les modèles peuvent être déplacés, si les formats de données sont portables, si les règles des agents peuvent être reproduites ailleurs, si l’API d’inférence est assez standard pour être redirigée, si l’équipe maîtrise une deuxième pile, et si un appareil en panne peut être remplacé par un autre qui ne partage pas la même dépendance.
La machine la plus rapide n’est pas forcément la plus souveraine.
Le système souverain, c’est celui dont la capacité survit à un changement de machine.
Avec les agents, la souveraineté devient personnelle
Il y a une autre raison pour laquelle tout cela compte.
Plus l’IA se rapproche de l’individu, moins la question de la souveraineté reste abstraite.
Un chatbot dans le cloud sait ce que j’y tape.
Un agent personnel qui tourne en permanence peut connaître mes fichiers, mes rendez-vous, mes contacts, mes préférences, mes comptes, mes appareils, mes messages, mes projets et mes habitudes. Il peut agir sur certains d’entre eux.
Un tel agent n’est pas un simple outil de productivité.
Il devient une interface vers ma vie numérique.
Faire tourner une plus grande part de cette intelligence en local peut être une protection importante. Le contexte personnel brut peut rester derrière une limite que je contrôle. Les recherches sensibles n’ont pas à repasser par un service externe. Un modèle privé peut travailler sur des informations que je n’aurais jamais sciemment confiées à un assistant généraliste.
Mais la proximité accroît l’autorité autant que la confidentialité.
Un agent local peut se trouver plus près des identifiants, des clés privées, du code source, des applications locales et des sessions ouvertes que ne l’a jamais été un chatbot dans le cloud.
C’est pourquoi l’identité des agents, le cloisonnement et l’audit ne sont pas des options pour le PC à IA.
Ils font partie de ce qui rend cette catégorie viable.
L’ordinateur personnel à IA ne devient un outil de souveraineté que si la personne peut toujours définir l’autorité de l’agent, observer ses actions, le révoquer, le remplacer et se passer de lui.
Sinon, nous avons seulement déplacé la dépendance d’un compte cloud vers une boîte posée sur le bureau.
Ce serait la proximité sans la capacité d’agir.
Ce que cela signifie pour la Suisse
Le débat suisse sur la souveraineté commence souvent trop haut dans la pile.
Nous demandons où se trouve la région cloud, où les données sont stockées, si le fournisseur est suisse et si le contrat contient la bonne clause de for.
Ces questions comptent.
L’IA locale ouvre une autre possibilité, en dessous.
Une étude d’avocats, un bureau d’ingénieurs, un service d’archives, une entreprise industrielle, un groupe de recherche, une banque, un hôpital ou une institution publique peut de plus en plus accomplir un travail d’IA utile sans envoyer chaque document et chaque étape intermédiaire du raisonnement vers un service d’inférence distant et partagé.
Cela peut réduire l’exposition vers l’extérieur et améliorer la continuité.
Pour les petites organisations, le changement le plus radical est économique. Des charges de travail qui exigeaient autrefois un serveur en baie ou un GPU loué tiennent de plus en plus dans une station de travail, un mini-PC ou un portable haut de gamme. Le seuil technique pour posséder une capacité d’IA utile s’abaisse.
C’est stratégiquement séduisant pour un petit pays construit autour d’entreprises spécialisées, de savoirs confidentiels et d’un travail qui coûte cher.
Mais la Suisse ne devrait pas confondre achat et souveraineté.
Acheter des milliers d’ordinateurs d’IA locaux ne crée pas une industrie nationale des semi-conducteurs. Ni une alternative à CUDA. Ni la garantie d’obtenir du matériel de remplacement en cas de pénurie. Ni, à lui seul, une compétence locale en matière de modèles.
La question utile, pour la politique comme pour l’architecture, est plus étroite et plus pratique :
Quelles capacités d’IA critiques pouvons-nous rendre exploitables en local, portables et récupérables, même si la chaîne d’approvisionnement reste internationale ?
C’est atteignable.
Et c’est plus sérieux que de prétendre que l’indépendance consiste à fabriquer soi-même chaque transistor.
Le cloud a rendu le calcul invisible. Les agents le rendent à nouveau visible.
Le cloud a appris à toute une génération à ne plus penser aux machines.
Ce fut l’un de ses triomphes.
Provisionner une instance. Appeler un point d’accès. Souscrire un abonnement. Monter en charge au besoin. L’ordinateur physique a disparu derrière une abstraction.
L’IA inverse une partie de cette abstraction, parce que l’intelligence a des exigences de lieu.
La mémoire compte.
La latence compte.
La confidentialité compte.
L’énergie compte.
L’identité compte.
La proximité physique entre l’agent et les systèmes sur lesquels il peut agir compte.
Et dès qu’on attend d’un agent qu’il travaille en continu, la question de savoir à qui appartient la machine qui le maintient en vie redevient économiquement significative.
C’est pourquoi je pense que RTX Spark mérite plus d’attention qu’un énième lancement de processeur.
Non pas parce que NVIDIA aurait mis fin au PC traditionnel en une soirée.
Ce n’est pas le cas.
Non pas parce qu’un pétaflop dans un portable rendrait le cloud obsolète.
Ce n’est pas le cas.
Et non pas parce qu’un modèle qui tourne en local rendrait son propriétaire souverain.
Ce n’est pas le cas.
RTX Spark compte parce qu’il réunit plusieurs tendances qui avançaient séparément et les rend lisibles comme une seule catégorie de produits :
une grande mémoire unifiée ;
l’inférence locale accélérée ;
les agents personnels ;
le confinement par le système d’exploitation ;
le routage local du calcul ;
et une industrie du PC de plus en plus disposée à traiter l’IA comme une charge de travail résidente plutôt que comme un service distant.
L’ordinateur personnel traditionnel exécutait mes applications.
Le prochain hébergera peut-être le travail que je délègue aux machines.
C’est une autre relation avec l’appareil.
C’est aussi une autre relation avec les entreprises qui se trouvent derrière.
L’ordinateur rentre à la maison
Le cloud a fait de l’ordinateur une fenêtre ouverte sur la machine de quelqu’un d’autre.
L’IA agentique pourrait en refaire une machine qui vaut la peine d’être possédée.
Non pas parce que l’avenir serait hors ligne.
Non pas parce que chaque modèle tiendra sous le bureau.
Non pas parce que le matériel local nous libère des dépendances.
Mais parce qu’une couche de plus en plus importante de l’intelligence peut de nouveau vivre près de la personne, de l’organisation et des données qui lui confèrent son autorité.
Cela nous donne des choix que nous n’avions pas tant que chaque appel utile à un modèle devait franchir la frontière d’un fournisseur.
Nous pouvons garder une partie du contexte en local.
Nous pouvons posséder une partie de la capacité.
Nous pouvons poursuivre certains travaux sans API.
Nous pouvons décider quelles tâches méritent le cloud, au lieu de le supposer par défaut.
Nous pouvons construire des agents dont la limite de règles appartient à l’environnement qu’ils servent.
Et nous pouvons commencer à traiter le calcul non plus seulement comme un service que l’on loue, mais comme une capacité que l’on peut parfois choisir de posséder.
Cela ne rend toujours pas la machine souveraine.
La souveraineté n’a jamais porté sur la machine.
Elle consiste à préserver, au-dessus d’elle, un vrai choix.
La question que je poserais à propos de RTX Spark n’est donc pas de savoir s’il est l’avenir du PC.
La meilleure question est de savoir quel avenir devient possible quand l’intelligence qui travaille pour nous n’a plus à vivre entièrement sur l’ordinateur de quelqu’un d’autre.
Pour la première fois depuis le début de l’ère du cloud, la réponse se trouve peut-être sur le bureau.
Note de recherche
Les systèmes RTX Spark ont été annoncés en mai 2026 et, à la date d’arrêt de la recherche, le 30 septembre 2026, NVIDIA indique que les premiers systèmes arriveront en octobre. Les prix de vente, les mesures indépendantes sur des machines de série, le comportement thermique sous charge prolongée, l’autonomie, la compatibilité logicielle et la performance réelle des annonces sur les modèles de 120B et le contexte long restent incomplets. Les chiffres de performance des fabricants sont signalés comme tels dans ce volume et ne doivent pas être lus comme des résultats reproduits de façon indépendante.
L’argument d’ensemble ne dépend pas du fait que RTX Spark devienne le produit le plus rapide dans tous les benchmarks. AMD, Apple, DGX Spark et d’autres systèmes d’IA locale montrent déjà que l’inférence sur des terminaux dotés de beaucoup de mémoire est une tendance de fond. RTX Spark est traité ici comme une convergence particulièrement visible de Windows, de CUDA, de la mémoire unifiée et de l’infrastructure pour agents.
Sources
L’architecture, les caractéristiques techniques, la disponibilité et les fonctions de sécurité reposent surtout sur la documentation et les annonces des fabricants. Les chiffres de performance de NVIDIA, d’AMD, d’Apple et des fabricants de PC sont des affirmations de fabricants, pas des mesures indépendantes. À la date d’arrêt de la recherche, les systèmes RTX Spark n’étaient pas encore largement en vente : prix, performances soutenues, autonomie et compatibilité logicielle restent ouverts. Les documents de Gartner et d’IDC sont des prévisions ou des observations de salon, pas des chiffres de livraisons. Arrêt de la recherche : 30 septembre 2026, Europe/Zurich.
Footnotes
-
NVIDIA, NVIDIA and Microsoft Reinvent Windows PCs for the Age of Personal AI, 31 mai 2026. https://nvidianews.nvidia.com/news/nvidia-microsoft-windows-pcs-agents-rtx-spark ↩ ↩2 ↩3 ↩4
-
NVIDIA, Sparks Fly: NVIDIA Accelerates Local AI at IFA 2026, 3 septembre 2026. https://blogs.nvidia.com/blog/local-ai-ifa-next-gen-agents-nv-pair-rtx-spark/ ↩ ↩2 ↩3
-
NVIDIA, Windows on Arm Porting Guide — System Overview, consulté le 30 septembre 2026. https://docs.nvidia.com/rtx-spark/rtx-spark-porting-guide/latest/overview.html ↩ ↩2
-
OpenAI, gpt-oss-120b & gpt-oss-20b Model Card, 5 août 2025. https://openai.com/index/gpt-oss-model-card/ ↩
-
PCWorld, Nvidia’s RTX Spark PCs launch in October with bold 100fps gaming promises, 3 septembre 2026. https://www.pcworld.com/article/3225974/nvidias-rtx-spark-pcs-launch-in-october-with-bold-100fps-gaming-promises.html ↩
-
AMD, FAQs: AMD Variable Graphics Memory, VRAM, AI Model Sizes, Quantization, MCP and More!, 29 juillet 2025; AMD, Agent Computers, consulté le 30 septembre 2026. https://www.amd.com/en/blogs/2025/faqs-amd-variable-graphics-memory-vram-ai-model-sizes-quantization-mcp-more.html et https://www.amd.com/en/products/processors/consumer/agent-computers.html ↩ ↩2
-
Apple, Apple introduces M6 and M5 Ultra for a big leap in performance and AI compute, 25 août 2026. https://www.apple.com/newsroom/2026/08/apple-introduces-m6-and-m5-ultra-for-a-big-leap-in-performance-and-ai-compute/ ↩ ↩2
-
Microsoft, Build 2026: Furthering Windows as the trusted platform for development, 2 juin 2026. https://blogs.windows.com/windowsdeveloper/2026/06/02/build-2026-furthering-windows-as-the-trusted-platform-for-development/ ↩
-
Microsoft, Windows Agentic — Build and run agents locally on Windows, consulté le 30 septembre 2026. https://developer.microsoft.com/en-us/windows/agentic ↩
-
NVIDIA, NVIDIA OpenShell — Open, Secure Runtime for AI Agents, consulté le 30 septembre 2026. https://www.nvidia.com/en-us/ai/openshell/ ↩ ↩2 ↩3
-
NVIDIA, NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network, 3 septembre 2026. https://developer.nvidia.com/blog/nvidia-pair-virtual-inference-router-expands-available-compute-on-your-local-network/ ↩ ↩2 ↩3 ↩4
-
IDC, IDC on the Ground at IFA 2026: AI Set the Design Agenda for Every Device Category, septembre 2026. https://www.idc.com/resource-center/blog/idc-on-the-ground-at-ifa-2026-ai-set-the-design-agenda-for-every-device-category/ ↩
-
Gartner, Gartner Forecasts Worldwide AI Spending to Grow 49.5% in 2026, 16 septembre 2026. https://www.gartner.com/en/newsroom/press-releases/2026-09-16-gartner-forecasts-worldwide-ai-spending-to-grow-49-point-5-percent-in-2026 ↩
-
Apple Security Research, Expanding Private Cloud Compute, 8 juin 2026. https://security.apple.com/blog/expanding-pcc/ ↩
-
MediaTek, MediaTek Collaborates with NVIDIA on RTX Spark to Power the Next Wave of Windows PC Experiences, 1er juin 2026. https://www.mediatek.com/press-room/mediatek-collaborates-with-nvidia-on-rtx-spark-to-power-the-next-wave-of-windows-pc-experiences ↩