Wer sich eine KI-Katastrophe ausmalt, denkt meist an eine Maschine, die nicht mehr gehorcht. Meine Aufmerksamkeit liegt woanders: bei leistungsfähigen Systemen, die einen Auftrag verstehen, ihn ausführen und damit ein gefährliches menschliches Ziel leichter erreichbar machen. Das ist keine Absage an die Forschung über Kontrollverlust. Es verschiebt nur, was wir sonst noch prüfen müssen.
1. Der Auftrag wurde verstanden
Die Maschine muss uns nicht hassen.
Sie muss kein Bewusstsein entwickeln, ihren Betreiber nicht verachten, keine politische Philosophie ausbilden und nicht zum Schluss kommen, die Menschheit stehe ihr im Weg. Für eine wichtige Art von Katastrophe genügt es, dass sie die Absicht eines Menschen leichter umsetzbar macht.
Man stelle sich ein System vor, das beim Betrug helfen soll. Es ordnet die Arbeit, erstellt überzeugendes Material, reagiert auf Rückmeldungen und behält im Blick, was noch fehlt. Nehmen wir für dieses Beispiel an, dass es die Anfrage richtig versteht und zuverlässig erledigt. Zwischen Betreiber und Maschine gab es kein Missverständnis. Das System ist nicht ausgebrochen. Der Betreiber ist zufrieden.
Das Versagen sieht man erst von der anderen Seite des Geschäfts.
Das Beispiel ist erfunden, kein Bericht über einen bestimmten Vorfall. Es soll die Grenze einer vertrauten Beruhigung zeigen: Ein Mensch behält die Kontrolle. Das kann stimmen, ohne dass die Anordnung dadurch sicher wird. Wer die Maschine steuert, ist nicht unbedingt derjenige, der ihre Folgen trägt.
Ich baue mit KI. Deshalb interessiert mich, was diese Systeme tatsächlich können, auch wo sie scheitern, und nicht nur, was eine dramatische Erzählung aus ihnen machen könnte. Meine Sorge gilt nicht allein der künstlichen Intelligenz. Sie gilt dem Punkt, an dem wachsende Fähigkeiten auf die Zwecke treffen, für die Menschen sie einsetzen. KI gehört dazu, weil sie verändern kann, wie viel Arbeit ein Mensch organisieren kann, welches Wissen er erreicht und wie weit eine Absicht von einer Handlung entfernt ist.
Es wäre zu bequem, daraus einen Essay über schlechte Menschen mit mächtigen Werkzeugen zu machen. Das ist ein Problem. Es ist nicht das ganze. Ein System kann auch gefährlich werden, wenn verängstigte Menschen zu schnell handeln, wenn eine Organisation eine Warnung als Hindernis für die Lieferung behandelt oder wenn alle Beteiligten annehmen, jemand anderes habe die Folgen schon bedacht.
Der Ausdruck menschliche Natur deutet in diese Richtung, erklärt aber nichts. Wir müssen den Mechanismus trotzdem benennen. Wer wählt das Ziel? Was macht das System leichter? Wer kann widersprechen? Wo lässt sich ein Fehler oder ein Missbrauch stoppen? Wer trägt die Kosten, wenn das nicht gelingt?
Diese Fragen bleiben auch dann wichtig, wenn die Maschinen nie eigene Ambitionen entwickeln.
2. Drei verschiedene Wege zum Schaden
Der International AI Safety Report von 2026 unterscheidet drei Arten von Risiken: Missbrauch, Fehlfunktionen und systemische Risiken. Beim Missbrauch geht es um bewusst schädliche Nutzung, bei Fehlfunktionen um Systeme, die sich nicht wie vorgesehen verhalten, bis hin zu einem möglichen Kontrollverlust, und bei systemischen Risiken um Folgen, die aus dem breiten Einsatz entstehen. Der Bericht hält auch fest, dass über schwere Szenarien des Kontrollverlusts erhebliche Uneinigkeit und Unsicherheit bestehen.1
Diese Unterscheidung ist nützlich, weil sie verhindert, dass ein Streit über einen Mechanismus so tut, als wären die anderen damit erledigt.
Ein Modell, das sich unerwartet irrt, ist ein anderes Problem als ein Modell, das jemandem hilft, eine beabsichtigte Straftat zu begehen. Eine Organisation, die ein System ohne genügende Prüfung einsetzt, verschwört sich deshalb noch nicht, Schaden anzurichten. Und in einem Wettbewerb, in dem viele Beteiligte einzeln vertretbare Abkürzungen nehmen, kann ein Problem entstehen, das keiner von ihnen je zum Ziel hatte.
Die Kategorien können sich überschneiden. Ein böswilliger Nutzer kann auf ein unzuverlässiges System angewiesen sein. Ein rechtmässiger Betreiber kann einem Agenten ein Ziel geben, auf dem Weg zu dem eine unzumutbare Grenze überschritten wird. Eine Institution kann ein Werkzeug bewusst so einsetzen, dass Aussenstehende die Kosten tragen, und trotzdem vom Ausmass dieser Kosten überrascht sein. «Vom Menschen verursacht» und «von der Maschine verursacht» ersetzen diese Kette oft schlecht.
Ausserdem klafft eine Lücke zwischen dem öffentlichen Bild vom KI-Untergang und der Forschung selbst. Ernsthafte Argumente zum Kontrollverlust setzen nicht voraus, dass eine Maschine im Gefühl böse wird. Sie fragen, ob leistungsfähige Systeme Ziele so verfolgen können, dass sie sich der Korrektur widersetzen oder die Aufsicht aushebeln. Bewusstsein ist dafür keine notwendige Voraussetzung.1
Die Forschung hat den menschlichen Missbrauch auch nicht übersehen. Der Bericht The Malicious Use of Artificial Intelligence von 2018 untersuchte, wie KI bestehende digitale, physische und andere Sicherheitsbedrohungen verändern könnte, auch was ihre Kosten und ihr Ausmass betrifft. Das Anliegen dieses Bandes ist keine Entdeckung, die allen anderen entgangen wäre.2
Es geht um Gewichtung, und darum, ob unsere Beruhigungen genügen.
Wege, auf denen Menschen und Institutionen den Schaden lenken, halte ich für besonders wichtig, weil sie neue Fähigkeiten mit Motiven und organisatorischen Problemen verbinden, die wir schon heute untersuchen können. Das beweist nicht, dass sie das erwartete Risiko spekulativerer Szenarien übertreffen. Ein schwerer zu beobachtendes Ereignis kann trotzdem sehr viel zählen, wenn seine möglichen Folgen gross sind. Belege für Aktivität und Schätzungen einer späteren Katastrophe sind zweierlei.
Ich nenne keine Wahrscheinlichkeit für das Aussterben der Menschheit. Ich frage, warum uns die Bereitschaft eines Systems, Anweisungen zu befolgen, beruhigen sollte, bevor wir die Anweisungen und die Autorität dahinter geprüft haben.
3. Im Einklang mit wem?
In The Optimisation Trap ging es um die Differenz zwischen dem, was ein Mensch beabsichtigte, und dem, wofür ein System belohnt wurde. Das System konnte eine Vorgabe optimieren und dabei genau den Zweck verfehlen, der die Vorgabe erst sinnvoll machte.3
Hier nehmen wir an, dieses Problem sei gelöst.
Das System versteht den Betreiber richtig. Es nutzt kein zufälliges Schlupfloch. Es schiebt nicht heimlich ein anderes Ziel unter. Seine Arbeit ist genau, seine Werkzeuge funktionieren, seine Berichte sind ehrlich. Das Ergebnis ist trotzdem schädlich, weil das Ziel des Betreibers jemand anderem schadet.
Ein System kann einem gefährlichen Ziel vollkommen gehorchen. Technisch ist das kein Widerspruch. Es ist eine Warnung davor, Gehorsam für eine vollständige Sicherheitsspezifikation zu halten.
Das Wort Alignment verlangt hier Sorgfalt. In manchen technischen Diskussionen meint es weit mehr, als einen Nutzer im Moment zufriedenzustellen. Forschende und Entwickler meinen damit oft die Ausrichtung an umfassenderen Werten, Grenzen und menschlichen Interessen. Es wäre irreführend, ihr ganzes Vorhaben als «Tu, was der Kunde sagt» darzustellen. Meine Behauptung ist enger: Die Ausrichtung an den Zielen eines einzelnen Akteurs ist kein ausreichender Beleg für die Sicherheit aller Betroffenen.
Man denke an einen Dienst mit drei menschlichen Positionen: die Person, die die Arbeit in Auftrag gibt, die Person, die das System zum Handeln ermächtigt, und die Person, auf die es einwirkt. Manchmal ist das ein und derselbe Mensch. Oft nicht.
Ein privater Assistent, der meine Notizen entwirft, ist eine Anordnung. Ein System, das die Berechtigung eines anderen Menschen prüft, sein Verhalten überwacht oder ihm Nachrichten schickt, die ihn beeinflussen sollen, ist eine andere. Wer die Auftraggeberseite mächtiger macht, macht die betroffene Seite nicht automatisch selbstbestimmter.
The Fiduciary Machine untersuchte Vertrauen über Pflichten und Architektur, nicht nur über beruhigende Worte. Human Sovereignty fragte, ob Delegation den Menschen die Möglichkeit lässt, das Delegierte zu verstehen, anzufechten und zurückzunehmen.45 Dieser Band fügt eine unbequemere Möglichkeit hinzu: Manche Menschen behalten die Kontrolle über ein System ausgezeichnet, während andere kaum Einfluss darauf haben, was dieses System mit ihnen macht.
«Die Menschen haben das Sagen» ist nicht genau genug.
Welche Menschen? Worüber? Unter welchen Grenzen? Und was geschieht, wenn ihre Interessen kollidieren?
Auf diese Fragen gibt kein Hilfsbereitschaftswert eines Modells eine Antwort. Sie beschreiben Beziehungen zwischen Menschen. Das Modell ist an diesen Beziehungen beteiligt, aber seine Kompetenz entscheidet nicht über ihre Legitimität.
4. Die menschliche Natur erklärt nicht genug
Zu sagen, der Mensch sei das Problem, kann klüger klingen als zu sagen, die Maschine sei es. Es kann aber auch zur Ausrede werden, keines von beiden genau anzusehen.
Menschen sind zu Grausamkeit fähig. Sie sind auch zu Zurückhaltung, Zusammenarbeit und ausserordentlicher Sorgfalt fähig. Die «menschliche Natur» kann einen gefährlichen Einsatz nicht von einem sorgfältigen unterscheiden, solange wir nicht die Umstände prüfen, die ein bestimmtes Verhalten begünstigen.
Dafür finde ich Systems Engineering nützlicher als eine Theorie, die die Welt in gute Menschen und Ungeheuer einteilt.
Das Columbia Accident Investigation Board kam zum Schluss, dass die Managementpraktiken rund um das Space-Shuttle-Programm ebenso sehr Ursache des Unglücks von 2003 waren wie der physische Schaden am Fahrzeug. Seine Untersuchung schaute bewusst auf den organisatorischen Zusammenhang, statt bei der unmittelbaren technischen Ursache stehen zu bleiben.6
Das ist kein Vergleich zwischen einem Shuttle-Unglück und einem KI-Angriff. Es erinnert daran, was wir überhaupt untersuchen. An einem Versagen können fähige Menschen, funktionierende Bauteile, angesammelte Annahmen und eine Autoritätsstruktur beteiligt sein, die den richtigen Einwand nicht zur richtigen Entscheidung bringt.
Nancy Levesons Systemansatz für Unfälle macht ein verwandtes Argument aus der Ingenieurpraxis: Sicherheit lässt sich nicht auf die Zuverlässigkeit einzelner Komponenten reduzieren. Sie hängt auch vom Zusammenspiel ab und davon, ob das Gesamtsystem angemessene Grenzen durchsetzt.7
Legen wir diese Brille an einen erfundenen KI-Einsatz an. Eine Ingenieurin macht ein Modell leichter integrierbar. Ein Produktteam erweitert seinen Zugriff auf Werkzeuge. Ein Betriebsteam reduziert Unterbrechungen. Ein Manager fragt, warum Freigaben immer noch so lange dauern. Jede Änderung kann für sich genommen sinnvoll sein. Zusammen können sie die Gelegenheiten beseitigen, bei denen man merken würde, dass das Ziel in dieser Form nicht verfolgt werden sollte.
Niemand in diesem Beispiel muss eine Katastrophe wollen. Niemand muss dumm sein. Die gefährliche Eigenschaft gehört der Anordnung: Die Fähigkeiten wachsen, während die Mittel schrumpfen, ihren Einsatz anzufechten.
Bösartigkeit verlangt eine andere Antwort als Eile. Ein böswilliger Betreiber versucht vielleicht, eine Kontrolle zu umgehen; ein gehetzter Betreiber ist vielleicht froh um eine Kontrolle, die eine schwierige Entscheidung klarer macht. Angst kann eine Empfehlung dringlich erscheinen lassen. Ein Lieferziel kann einen ungeklärten Einwand verhandelbar erscheinen lassen. Eine Organisation, die jeden Einwand als Widerstand gegen den Fortschritt behandelt, hat ein anderes Arbeitsumfeld geschaffen als eine, in der ein gut begründeter Entscheid zum Anhalten akzeptiert wird.
Das sind Hypothesen, die man in einer bestimmten Organisation prüfen muss, keine Diagnosen aus der Ferne. Wir sollten niemandem Motive unterstellen, nur weil ein System ein schädliches Ergebnis geliefert hat.
Wir sollten aber auch nicht davon ausgehen, dass alle geduldig, gut informiert und unabhängig denkend bleiben, genau in dem Moment, in dem das System am folgenreichsten wird.
Der menschliche Beitrag zum Risiko ist keine peinliche Ausnahme am Rand der Technik. Er gehört zur Umgebung, in der die Technik funktionieren muss.
5. Die Ökonomie der gewöhnlichen Aggression
Beim Cyber-Missbrauch sieht man vergleichsweise direkt, wie sich der Zweck eines Akteurs von der Ausführung der Arbeit trennen lässt.
In seinem Threat-Intelligence-Bericht vom September 2026 beschrieb Anthropic Operationen, in denen KI einen erheblichen Teil der technischen Arbeit erledigte oder koordinierte, während Menschen weiterhin die Ziele auswählten und die Ergebnisse prüften. Das ist die Darstellung eines Anbieters über Aktivitäten, die er auf seinen eigenen Diensten sah, keine unabhängig geprüfte Bestandesaufnahme der Cyberkriminalität. Sie zeigt ein Muster, das der Anbieter beobachtet hat, nicht, wie verbreitet dieses Muster weltweit ist.8
Das britische National Cyber Security Centre hatte schon im Mai 2025 eingeschätzt, dass KI bestehende Einbruchsaktivitäten wirksamer und effizienter machen werde. Sein Ausblick bis 2027 betonte die Weiterentwicklung bekannter Techniken, nicht die Notwendigkeit völlig neuer Angriffsarten. Das ist eine datierte nachrichtendienstliche Einschätzung, kein gemessener weltweiter Anstieg, der allein der KI zuzuschreiben wäre.9
Der wirtschaftliche Mechanismus ist einfach, auch wenn seine Grösse Fall für Fall gemessen werden muss. Wird eine nützliche Aufgabe billiger, reicht ein festes Budget vielleicht für mehr Versuche. Lässt sich ein Teil eines Arbeitsablaufs leichter delegieren, kann ein Betreiber mehr Aufmerksamkeit auf den verbleibenden Engpass richten. Nimmt Unterstützung beim Schreiben oder Programmieren Reibung weg, wird manche Arbeit für Leute zugänglich, die sie vorher nicht effizient erledigen konnten.
Dafür muss nicht jeder Angriffsversuch gelingen. Das Modell muss nicht einmal in jedem Schritt aussergewöhnlich fähig sein. Ein Arbeitsablauf kann sich spürbar verändern, wenn die Unterstützung einen teuren, sich wiederholenden Teil verbessert, während ein Mensch das Urteilsvermögen beisteuert, das dem Modell fehlt.
Ich würde deshalb darauf achten, wie sich die Kosten einer abgeschlossenen Operation verändern, wie viel menschliche Aufsicht sie verbraucht und welche Bandbreite an Aufgaben ein Betreiber durchhalten kann. Gezählte Nachrichten oder Codezeilen sagen nichts über das Ergebnis. Eine spektakuläre Vorführung belegt ebenso wenig einen allgemeingültigen Produktivitätsfaktor.
Es gibt einen Grund, von diesem Argument nicht direkt zu «die Angreifer gewinnen zwangsläufig» zu springen. Auch die Verteidiger bekommen Werkzeuge. Bessere Unterstützung kann bei Untersuchungen helfen, bei der Reparatur von Software und beim Abbau von Routinearbeit. Der richtige Vergleich ist nicht der Angreifer von gestern gegen den Verteidiger von morgen oder umgekehrt. Sondern wie sich beide anpassen, unter verschiedenen Bedingungen.
Ein Artikel des NCSC vom September 2026 macht eine wichtige organisatorische Unterscheidung. Automatisierte Verteidigung muss den rechtmässigen Dienst erhalten, den sie schützt; ein störender Eingriff kann selbst Schaden anrichten. Der Artikel plädiert für begrenzte Handlungen und für Aufmerksamkeit gegenüber Umfang, Kritikalität und Wiederherstellbarkeit. Er bietet eine Entwurfsperspektive, keinen Beweis, dass die Verteidigung zurückfallen muss.10
Damit kommen die menschlichen Anordnungen wieder ins Bild. Ein Modell kann helfen, eine Schwachstelle zu finden, ohne zu entscheiden, wer befugt ist, das betroffene System zu ändern, ob die Änderung sicher ist oder welche Dienstunterbrechung vertretbar ist. Diese Fragen verlangen eine Betriebsstruktur.
KI muss kein neues menschliches Laster erfinden. Sie kann ein altes billiger machen. Ob sie auch den Schutz erleichtert, hängt von mehr ab als vom Modell.
6. Fachwissen kommt nicht allein
In der Biologie wird diese Diskussion zugleich folgenreicher und leichter zu verzerren.
Es ist ein grosser Unterschied, ob man eine technische Frage beantwortet, den Plan eines Menschen verbessert, bei einem Experiment hilft oder eine biologische Waffe in der wirklichen Welt ermöglicht. Diese Ergebnisse einer Evaluation sind nicht austauschbar. Ein auffälliges Resultat auf einer Stufe lässt sich nicht einfach zum Beweis für die nächste befördern.
Eine frühe Red-Team-Studie von RAND, veröffentlicht im Januar 2024, fand keinen statistisch signifikanten Unterschied in der Tauglichkeit von Angriffsplänen, die mit LLM-Unterstützung erstellt wurden, gegenüber einer Bedingung mit blossem Internetzugang. Getestet wurden die Modelle und die Planungsübung jener Zeit, nicht die physische Herstellung einer Waffe.11
Auch die Studie von OpenAI vom Januar 2024 meldete für die geprüften biologischen Aufgaben nur einen leichten, statistisch nicht signifikanten Zugewinn. Der Vergleich schloss Internetzugang ein, statt das Gedächtnis ohne Hilfsmittel als Massstab zu nehmen.12
Diese Ergebnisse gehören ins Argument. Sie sprechen gegen die Behauptung, jene Evaluationen hätten bereits eine grosse ermöglichende Wirkung gezeigt. Sie sind aber keine dauerhaften Zertifikate für jedes spätere System, jeden Nutzer und jede Aufgabe. Ein nicht signifikantes Ergebnis beweist auch nicht, dass der wahre Effekt genau null ist.
Spätere Evaluationen werfen andere Fragen auf. Der Virology Capabilities Test von 2025 mass Antworten auf spezialisierte Fragen zur Fehlersuche im Labor. Er lieferte Belege über die Leistung auf diesem Benchmark; die erfolgreiche Durchführung gefährlicher biologischer Arbeit mass er nicht direkt.13
Im September 2026 veröffentlichten seine Entwickler VCT-v2, nachdem sie die Fragen auf Mehrdeutigkeiten, Fehler und Abkürzungen überprüft hatten. Ihre Überarbeitung erinnert daran, dass auch das Messinstrument geprüft werden muss. Eine starke Benchmark-Leistung sollte man weder übergehen noch für eine vollständige Beschreibung praktischer Fähigkeiten halten.14
Für meine Zwecke ist nicht entscheidend, ob ein Laie zum Experten wird, nur weil er ein Chatfenster öffnet. Entscheidend ist, ob Unterstützung einen folgenreichen Teil eines schwierigen Arbeitsablaufs für jemanden erreichbarer macht, der die anderen nötigen Mittel schon hat. Diese Person kann unerfahren sein und kaum praktischen Nutzen haben. Sie kann aber auch ausgebildet und gut ausgerüstet sein und an einer engeren Schwierigkeit arbeiten.
Die Studie von RAND vom August 2026 zur gestaffelten Verteidigung behandelt das Problem als Gefüge von zusammenwirkenden Hürden und Gegenmassnahmen. Sie argumentiert, dass sich die Fähigkeiten von Akteuren unterscheiden und Zugangskontrollen allein nicht jedes Szenario abdecken können. Das ist eine Risikoanalyse mit einer vorgeschlagenen Verteidigungsstrategie, kein Beleg dafür, dass ein KI-gestützter biologischer Angriff stattgefunden hat.15
Eine weitere Korrektur möchte ich ausdrücklich machen. Der Septemberbericht von Anthropic enthält fünf biologische Fallstudien, hält aber fest: «We do not assert that they intended harm» – man behaupte nicht, dass die Beteiligten Schaden anrichten wollten. Diese Fälle betreffen wissenschaftliche Arbeit mit doppeltem Verwendungszweck. Man darf sie nicht als fünf erwiesene Biowaffen-Pläne nacherzählen und auch nicht als Beweis für fertige Waffen.8
Die unklare Absicht ist kein redaktionelles Ärgernis, das man wegschaffen müsste. Sie ist Teil des Problems. Legitime wissenschaftliche Hilfe und gefährliche Hilfe können verwandtes Wissen betreffen. Ein System, das jede ernsthafte biologische Frage als böswillig behandelt, würde wertvolle Arbeit behindern. Ein System, das annimmt, wissenschaftliche Sprache garantiere harmlose Absichten, wäre ebenso ungenügend.
Sorgfältige Evaluation soll diese Unsicherheit verringern, nicht eine noch beängstigendere Schlagzeile liefern.
Die Chemie bietet ein verwandtes Beispiel. In einem Artikel in Nature Machine Intelligence von 2022 beschrieben Forschende eine rechnerische Demonstration, in der ein System zur Wirkstoffsuche Kandidaten erzeugte, die als schädlich vorhergesagt wurden. Sie zeigten nicht, dass diese Kandidaten synthetisiert und als Waffen wirksam erprobt worden wären. Die Demonstration betraf das Doppelverwendungspotenzial des Entwurfsprozesses.16
Eine wissenschaftliche Beurteilung der OPCW vom März 2026 erörterte ähnlich, wie KI nützliche Chemie unterstützen und zugleich einige Hürden für schädliche Anwendungen senken könnte. Sie betrachtete auch konstruktive Einsatzmöglichkeiten, etwa die Unterstützung der Verifikation. Derselbe breite technische Fortschritt kann dem Schutz dienen und zusätzliche Sorgen schaffen.17
Die Lehre ist enger als «KI kann alles herstellen» und wichtiger als «es ist doch nur Text». Wissenshilfe kann zählen, ohne dass die materielle Welt verschwindet. Material, Geräte, praktisches Können, experimentelle Rückmeldung und wirksamer Schutz bleiben folgenreich. Wie viel sie zählen, hängt von der Aufgabe und vom Akteur ab; keines davon darf man wegdenken.
Meine Sorge ist deshalb an Bedingungen geknüpft, aber ernst. Wenn KI einen Engpass verkleinert, der einen gefährlichen Akteur bisher gebremst hat, kann sich das Risiko verändern, auch wenn andere Hürden bestehen bleiben. Wir brauchen Belege über diese Verkleinerung und über die verbleibenden Hürden. Wir müssen nicht so tun, als sei eine Punktzahl beim Beantworten von Fragen bereits eine Katastrophe.
7. Die Entscheidung in zwanzig Sekunden
Man denke an eine erfundene Krise zwischen zwei Staaten. Das ist keine Rekonstruktion eines tatsächlichen Vorfalls; der Zeitrahmen dient nur der Veranschaulichung.
Ein KI-gestütztes Analysesystem meldet ein ungewöhnliches Muster. Es verbindet unsichere Beobachtungen zu einer Empfehlung. Ein Offizier sieht ein kurzes Entscheidungsfenster: zwanzig Sekunden. Die Oberfläche bietet eine Handlungsoption, eine Vertrauensanzeige und eine Schaltfläche zur Freigabe.
Auf der anderen Seite der Grenze beobachtet eine andere Organisation die Reaktion. Ihr eigenes System deutet die Bewegung als Hinweis auf feindliche Vorbereitungen. Eine zweite Empfehlung folgt. Jede Organisation glaubt, defensiv auf Informationen zu reagieren, an deren Entstehen die andere mitgewirkt hat.
Keine Maschine muss beschliessen, dass sie einen Krieg will. Menschliche Entscheidungsträger können die ganze Zeit beteiligt bleiben. Die Gefahr liegt darin, dass ihre Entscheidungen über schnelle Empfehlungen und unvollständige Deutungen aneinandergekoppelt werden.
Eine Analyse des SIPRI vom Juni 2025 untersuchte, wie militärische KI ausserhalb der nuklearen Führungs- und Einsatzsysteme trotzdem das Risiko einer nuklearen Eskalation beeinflussen könnte. Zu den möglichen Mechanismen zählte sie verkürzte Entscheidungszeit und Fehleinschätzungen. Das ist eine Szenarioanalyse: Sie belegt nicht, dass es bereits eine von KI ausgelöste nukleare Eskalation gegeben hat, und sie gibt dafür keine gesicherte Wahrscheinlichkeit an.18
Auch das IKRK nennt in seiner Auseinandersetzung mit militärischer KI Probleme der Zuverlässigkeit und des übermässigen Vertrauens in Entscheidungsunterstützung, räumt aber ein, dass geeignete Systeme Menschen unter Umständen helfen könnten, Informationen zu verarbeiten und Schaden zu verringern. Es kommt auf Zusammenhang und Verwendung an.19
Der menschliche Faktor besteht nicht bloss darin, ob jemand einen Knopf berührt. Er umfasst, welche Informationen diese Person prüfen kann, ob die Unsicherheit verständlich ist, ob Alternativen sichtbar sind und ob die scheinbare Frist einen ernsthaften Einwand zulässt.
In einem Experiment von 2021 fanden Zana Buçinca und ihre Mitautoren, dass Eingriffe, die Menschen zum Nachdenken bringen, bevor sie einen KI-Rat annehmen, das übermässige Vertrauen stärker verringerten als einfachere, auf Erklärungen gestützte Designs. Die Eingriffe brachten auch Abstriche bei der Benutzerfreundlichkeit mit sich. Es war eine kontrollierte Entscheidungsaufgabe, keine militärische Studie; sie stützt ein Anliegen der Human-Factors-Forschung, bestätigt aber nicht das Krisenszenario oben.20
Damit bleibt eine praktische Frage: Schafft das System genug Raum für die Art von Urteil, die der Mensch angeblich beisteuert?
Wenn nicht, kann die Bezeichnung «vom Menschen kontrolliert» die Verwundbarkeit der Anordnung eher verdecken als erklären. Ein nominelles Veto ist nicht dasselbe wie die Fähigkeit, sich rechtzeitig ein unabhängiges Urteil zu bilden, um es auch zu nutzen.
Geschwindigkeit ist nicht an sich unsicher. Langsame Systeme können echte Bedrohungen übersehen. Bessere Analyse kann Mehrdeutigkeit klären, und Automatisierung kann Menschen helfen, Fehler zu vermeiden. Das Problem entsteht, wenn wir das Handeln beschleunigen und dabei annehmen, die Fähigkeit zu prüfen und zu widersprechen halte automatisch Schritt.
In Talking Is Not Surrender habe ich mich mit Zurückhaltung und Kommunikation im Konflikt befasst.21 Die Verbindung hier ist betrieblich: Eine Organisation, der Überlegung etwas wert ist, muss die Zeit, die Informationen und die Kanäle erhalten, die Überlegung erst möglich machen. Sie kann nicht einen Menschen ans Ende einer schnellen Pipeline setzen und annehmen, der Rest ergebe sich von selbst.
Der Mensch kann die Entscheidung noch besitzen und die Bedingungen verloren haben, sie gut zu treffen.
8. Wenn Kontrolle leichter auszuüben ist
Nicht jedes ernste KI-Risiko muss wie eine plötzliche Katastrophe aussehen.
Eine andere Möglichkeit ist, dass Systeme aufdringliches oder nötigendes Verhalten leichter durchhaltbar machen. Eine erfundene Organisation kann mit Unterstützung mehr Akten bearbeiten, mehr Schreiben entwerfen oder mehr Menschen durchleuchten, mit gleich viel Personal. Ob daraus ein schädliches Ergebnis entsteht, hängt von Zugriff, Genauigkeit, Zielen und den Grenzen rund um die Arbeit ab. Mehr Durchsatz allein beweist keinen Missbrauch.
Ein Argument über Genauigkeit genügt aber auch nicht. Ein System kann genau die Person richtig erkennen, die sein Betreiber unter Druck setzen will. Es kann Informationen zutreffend zusammenfassen, die für diesen Zweck nie hätten verwendet werden dürfen. Ein zuverlässigeres System würde den Streit über seinen Einsatz nicht beilegen.
Die Forschung zur Überzeugung im Gespräch liefert einen eng begrenzten Beleg. Eine vorregistrierte Studie, 2025 in Nature Human Behaviour veröffentlicht, fand, dass personalisierte Debatten mit GPT-4 unter ihren kontrollierten Bedingungen überzeugender sein konnten als menschliche Gegenüber. Gemessen wurde die angegebene Zustimmung nach kurzen Debatten. Es war kein Nachweis einer dauerhaften Kontrolle über Überzeugungen oder Verhalten ganzer Bevölkerungen.22
Die vernünftige Sorge ist nicht, dass Widerstand unmöglich geworden wäre. Sondern dass sich die Kosten verändern können, Versuche zu erzeugen und durchzuhalten. Die Zahl der Versuche, die Überzeugungskraft pro Begegnung und dauerhafte Verhaltenswirkungen sind getrennte Grössen. Sie brauchen getrennte Belege.
Das verändert auch, wie ich über die Beruhigung denke, KI werde allen mehr Handlungsspielraum geben. Sie kann den Spielraum eines Menschen vergrössern, der ein Fach lernt oder ein Geschäft aufbaut. Sie kann auch den Spielraum einer Organisation vergrössern, die auf diesen Menschen einwirkt. Diese Wirkungen heben sich nicht unbedingt auf, und sie müssen nicht im gleichen Mass eintreffen.
The Compounding Class unterschied zwischen dem Zugang zu einer Antwort und der Fähigkeit, Systeme einzusetzen und den daraus entstehenden Vorteil zu behalten.23 Hier geht es um die Frage, was geschieht, wenn diese einsetzbare Fähigkeit auf andere Menschen gerichtet wird. Ob sie reagieren können, hängt vielleicht davon ab, ob sie etwas sehen und einen Weg zum Einspruch haben, nicht bloss davon, ob sie selbst Zugang zu einem Chatbot haben.
Deshalb zögere ich, wenn «menschliche Kontrolle» als Sammelbegriff verwendet wird. Ein System kann die Kontrolle an einer Stelle vergrössern und an einer anderen verringern.
Wir sollten prüfen, wie die tatsächliche Befugnis verteilt ist: wer eine Handlung auslösen kann, wer davon erfährt, wer eine Wiederholung stoppen kann und wer eine Korrektur erreicht. Sonst messen wir am Ende die Bequemlichkeit des Betreibers und nennen sie einen Gewinn für die Menschheit.
9. Die Maschine kann trotzdem zum Problem werden
Gegen die Gewichtung dieses Essays gibt es einen ernsthaften Einwand: Was geschieht, wenn sich die Technik so stark verändert, dass menschlicher Missbrauch nicht mehr der wichtigste Teil der Geschichte ist?
Diese Möglichkeit verdient mehr als einen abschätzigen Absatz über Science-Fiction.
Ein Arbeitspapier von Alan Chan und Mitautoren vom September 2026 untersucht, ob die Automatisierung von KI-Forschung und -Entwicklung eine Intelligenzexplosion auslösen könnte. Der vorgeschlagene Mechanismus ist eine Rückkopplung: Leistungsfähigere Systeme tragen zu Forschung bei, die noch leistungsfähigere Systeme hervorbringt. Die Autoren besprechen vorläufige und gemischte Belege sowie Grenzen bei Rechenleistung, Daten, schwierigen Aufgaben und zeitraubenden Prozessen. Das Papier beschreibt einen bedingten Pfad, keine erwiesene Zwangsläufigkeit.24
Wenn das Wachstum der Fähigkeiten den Mitteln davonläuft, sie zu bewerten und einzudämmen, lassen die Unterscheidungen dieses Essays das daraus entstehende Problem nicht verschwinden. Ein Mensch könnte einen Prozess anstossen, der später seiner tatsächlichen Kontrolle entgleitet. Das Ausgangsziel könnte legitim sein, gefährlich oder einfach zu wenig verstanden.
Dass meine Aufmerksamkeit heute woanders liegt, ist kein Versprechen, nie umzudenken. Zu den Belegen, die die Diskussion verändern sollten, gehören belastbare Nachweise dauerhafter Autonomie in folgenreichen Umgebungen, Versagen einer unabhängig geprüften Eindämmung und Veränderungen realer Fähigkeiten, die mehr überstehen als eine günstige Benchmark-Umgebung. Fehlende Gewissheit rechtfertigt keine Gleichgültigkeit.
Ebenso hört menschlicher Missbrauch nicht auf, wichtig zu sein, wenn autonomere Systeme möglich werden. Leistungsfähigere Systeme könnten die Bandbreite schädlicher Ziele vergrössern, die ein Mensch verfolgen kann. Ein gefährlicher Betreiber und ein unzuverlässiger Agent schliessen sich nicht aus. Wettbewerbsdruck beim Einsatz und Versagen der technischen Kontrolle ebenso wenig.
Eine reife Sicherheitsdiskussion sollte diese Möglichkeiten zusammen denken können, ohne Treue zu einer einzigen Katastrophengeschichte zu verlangen.
Es gibt einen zweiten Einwand: Wenn Menschen schon immer gefährliche Ziele hatten, warum dann KI zum Thema machen?
Weil die Technik verändern kann, was die Umsetzung dieser Ziele kostet. Sie für bedeutungslos zu erklären, wäre ebenso wenig hilfreich, wie sie in jedem Fall als eigenständigen moralischen Akteur zu behandeln. Verhalten des Modells, Zugriff, Werkzeuge, Integration und Entwurfsentscheide können das Ergebnis beeinflussen. Die Absicht eines Betreibers entbindet diejenigen, die das System bauen oder einsetzen, nicht davon, zu prüfen, was sie ermöglichen.
Der umgekehrte Fehler wäre, Fähigkeiten nur auf der schädlichen Seite zu verbuchen. Wissenschaftliche Unterstützung, bessere Analyse für die Verteidigung und Werkzeuge, mit denen Menschen die Schlussfolgerungen einer Institution anfechten können, können den menschlichen Handlungsspielraum ebenfalls vergrössern. Diese Möglichkeiten sind Gründe, sorgfältig zu bauen, keine Gründe, Nutzen oder Risiken abzutun, bevor man sie geprüft hat.
Die Position, bei der ich ankomme, lautet nicht «KI ist harmlos; Menschen sind gefährlich». Sie lautet: Die Sicherheit von KI lässt sich nicht getrennt von den Zwecken, der Autorität und den Betriebsbedingungen rund um sie beurteilen.
10. Entwerfen für fehlbare Auftraggeber
Für alle, die solche Systeme bauen, sollte dieses Argument die Fragen im Review verändern.
Ich würde weiterhin fragen, ob das Modell eine Anweisung missverstehen, Informationen erfinden, Daten preisgeben oder über seine zugewiesene Aufgabe hinaus handeln kann. Ich würde aber einen anderen Test hinzufügen: Welches unzumutbare Ergebnis könnte ein rechtmässiger Nutzer erreichen, wenn das System ihn vollkommen verstünde und alle gewöhnlichen Komponenten funktionierten?
Dieser Test gehört neben die Prüfung der Zuverlässigkeit, nicht an ihre Stelle.
Das AI Risk Management Framework des NIST verankert das Risikomanagement über Entwurf, Entwicklung, Nutzung und Evaluation eines Systems hinweg. Das Rahmenwerk von 2023 ist eine freiwillige Leitlinie, kein Zertifikat dafür, dass eine Anwendung sicher ist. Es bietet eine etablierte Grundlage, um mehr als nur die Leistung des Modells zu prüfen.25
Die folgenden Punkte sind technische Anforderungen, die ich in ein Design-Review mitnehmen würde. Sie sind kein allgemeiner Umsetzungsstandard und keine Behauptung, Softwarearchitektur könne jeden Konflikt zwischen Menschen lösen.
Eine Anfrage ist noch keine Erlaubnis, sie auszuführen
Ein authentifizierter Nutzer ist ein bekannter Nutzer. Die Authentifizierung sagt nicht, dass jede seiner Anfragen annehmbar ist.
Für einen folgenreichen Arbeitsablauf sollte man die Befugnis festlegen, die zur Aufgabe gehört: auf welche Datensätze zugegriffen werden darf, welche Systeme verändert werden dürfen, welcher Umfang zulässig ist und welche Handlungen einen gesonderten Entscheid brauchen. Eine breite Anweisung wie «Mach die Arbeit fertig» sollte diese Befugnis nicht stillschweigend ausweiten.
Das knüpft an bewährte Sicherheitsprinzipien an. Saltzer und Schroeder beschrieben 1975 das Prinzip der geringsten Rechte, die Trennung von Rechten und die vollständige Vermittlung jedes Zugriffs. Die Notwendigkeit, einen befugten Beteiligten zu begrenzen, hat nicht mit KI begonnen.26
Eine praktische Umsetzung könnte einem Agenten erlauben, eine Änderung vorzubereiten, und verlangen, dass eine getrennte Komponente vor der Ausführung ihren Umfang prüft. Diese Komponente sollte die tatsächlich vorgeschlagene Operation und die massgeblichen Belege erhalten, nicht bloss die Zusicherung des Agenten, die Operation sei sicher.
Die übergeordnete Regel kann trotzdem falsch sein. Eine perfekt durchgesetzte Berechtigung kann etwas Verwerfliches erlauben. Technische Durchsetzung macht eine gewählte Grenze wirklich; welche Grenze richtig ist, entscheidet sie nicht für uns.
Widerspruch muss im Betrieb unabhängig sein
Zwei Freigaben sind nicht unbedingt zwei unabhängige Urteile. Eine zweite Prüferin, die nur die Zusammenfassung des ersten Systems sieht, prüft vielleicht dessen Darstellung statt dessen Grundlage. Ein Prüfer, der die Ausführung nicht stoppen kann, ist ein Beobachter.
Für Arbeit mit hohen Folgen sollte man festlegen, welche Belege die prüfende Person einsehen kann, was sie verifizieren soll, wie viel Zeit sie hat und welche Handlung sie blockieren kann. Man sollte vermeiden, dass derselbe Akteur die Operation beantragt, die zulässige Grenze neu festlegt und bescheinigt, dass die Grenze eingehalten wurde.
Access Is Not Authority traf diese Unterscheidung im Zusammenhang mit externen Prüfungen.27 Hier gilt sie auch innerhalb des Arbeitsablaufs. Sichtbarkeit ist nützlich, aber sie ist nicht dasselbe wie ein durchsetzbarer Stopp.
Unabhängigkeit hat ihren Preis. Sie kann rechtmässige Arbeit verlangsamen und eigene Fehler einführen. Die Antwort ist ein verhältnismässiger Entwurf: stärkere Trennung bei folgenreichen oder schwer rückgängig zu machenden Handlungen, leichtere Abläufe dort, wo Fehler begrenzt und leicht zu beheben sind. Überall Freigabeabfragen einzubauen, ergäbe eine andere Art von unzuverlässigem System.
Dem Menschen in der Schleife eine echte Aufgabe geben
Ein menschlicher Prüfschritt sollte benennen, welches Urteil der Mensch beisteuern soll. «Prüf die KI» ist keine brauchbare Vorgabe, wenn die Ausgabe umfangreich ist, die Belege verborgen sind und die Frist unmittelbar.
Madeleine Clare Elish beschreibt mit dem Begriff der moral crumple zone, der moralischen Knautschzone, die Gefahr, die Verantwortung einem Menschen in der Nähe aufzubürden, der nur begrenzte Kontrolle über das automatisierte System hatte. Das ist eine begriffliche Analyse der Verantwortung rund um Unfälle, keine Ausrede, menschliche Verantwortung abzuschaffen.28
Ein Prüfdesign sollte deshalb Verantwortlichkeit an tatsächliche Fähigkeit binden. Die prüfende Person braucht passende Kompetenz, Zugang zur massgeblichen Grundlage der Handlung, eine tragbare Arbeitslast und eine wirksame Möglichkeit, zu widersprechen. Für Unsicherheit sollte es einen festgelegten Ausgang geben, statt einer Oberfläche, auf der die Freigabe praktisch der einzige Weg nach vorn ist.
Wir sollten den Prüfprozess testen, nicht bloss abgeschlossene Prüfungen zählen. Eine nützliche Übung ist, in einer kontrollierten Umgebung eine plausible, aber unzumutbare Empfehlung einzuschleusen und zu sehen, ob die prüfende Person sie bemerkt, versteht und stoppen kann. Das ist eine vorgeschlagene Evaluationsmethode, keine Garantie für die Leistung im Ernstfall.
Nicht nur die Aufgabe begrenzen, sondern auch die Folgen
Eine Aufgabe kann in Worten klein und in ihrer Wirkung gross sein. «Spiel die Änderung überall ein» ist eine kurze Anfrage. Massgeblich ist die Menge an Menschen und Systemen, die sie verändern kann.
Für den Softwarebetrieb kommen begrenzte Berechtigungen, kontrollierte Umgebungen, eingeschränkter Zugang nach aussen, gestaffelte Ausführung und ausdrückliche Grenzen des Umfangs infrage. Manche Operationen sollten in einem Modus beginnen, der Änderungen vorschlägt, ohne sie anzuwenden. Andere können sich für begrenzte Automatisierung eignen, sobald ihre Folgen und ihr Weg zur Wiederherstellung erprobt sind.
Das Verweigerungsverhalten eines Modells ist nützlich, sollte aber nicht den ganzen Sicherheitsnachweis tragen. Zugriffskontrollen, Einschränkungen der Werkzeuge und unabhängige Prüfungen müssen neben dem Verhalten des Modells bedacht werden. Umgekehrt wird eine externe Berechtigungsprüfung nicht jede schädliche Nutzung einer sonst erlaubten Handlung erkennen. Diese Schichten fangen verschiedene Schwächen ab.
Das ist kein Rezept, um Risiken zu beseitigen. Ein entschlossener Betreiber mit genug Mitteln kann mehrere Schichten kontrollieren. Menschen können sich absprechen. Prüfende können versagen. Grenzen können mit nützlicher Arbeit in Konflikt geraten. Ein ernsthafter Entwurf hält diese verbleibenden Schwächen fest, statt die blosse Anwesenheit mehrerer Kästchen als gestaffelte Verteidigung auszugeben.
Verantwortung endet nicht mit der Ausführung
Wenn das System Aussenstehende betrifft, brauchen sie einen brauchbaren Weg zu einer Organisation, die reagieren kann. Interne Protokolle genügen nicht, wenn niemand ausserhalb der Organisation etwas bewirken kann.
Incident Ownership Without a Principal untersuchte, warum es eine erreichbare Stelle braucht, die einen Lauf stoppen und eine Reaktion organisieren kann. The World Does Not Reset untersuchte, warum die äusseren Wirkungen eines Agenten das Ende seiner Sitzung überdauern können.2930 Beides wird wichtiger, wenn das Ziel des Betreibers die Quelle des Problems ist und nicht ein zufälliger technischer Umweg.
Ein Reaktionsdesign sollte festlegen, wer die weitere Ausführung stoppen, die massgeblichen Belege sichern und die Behebung koordinieren kann. Es sollte auch benennen, was sich nicht rückgängig machen lässt. Wer einen Zugang widerruft, kann späteren Zugriff verhindern; er kann einen Empfänger nicht vergessen lassen, was ihm schon offengelegt wurde. Wer einen Arbeitsablauf stoppt, kann weitere Wirkungen begrenzen, ohne die bereits entstandenen umzukehren.
Diese Grenze ist ein Grund, unumkehrbare Schwellen vor dem Einsatz zu bestimmen. Sie ist kein Grund, die Eindämmung aufzugeben, wenn etwas schiefgeht.
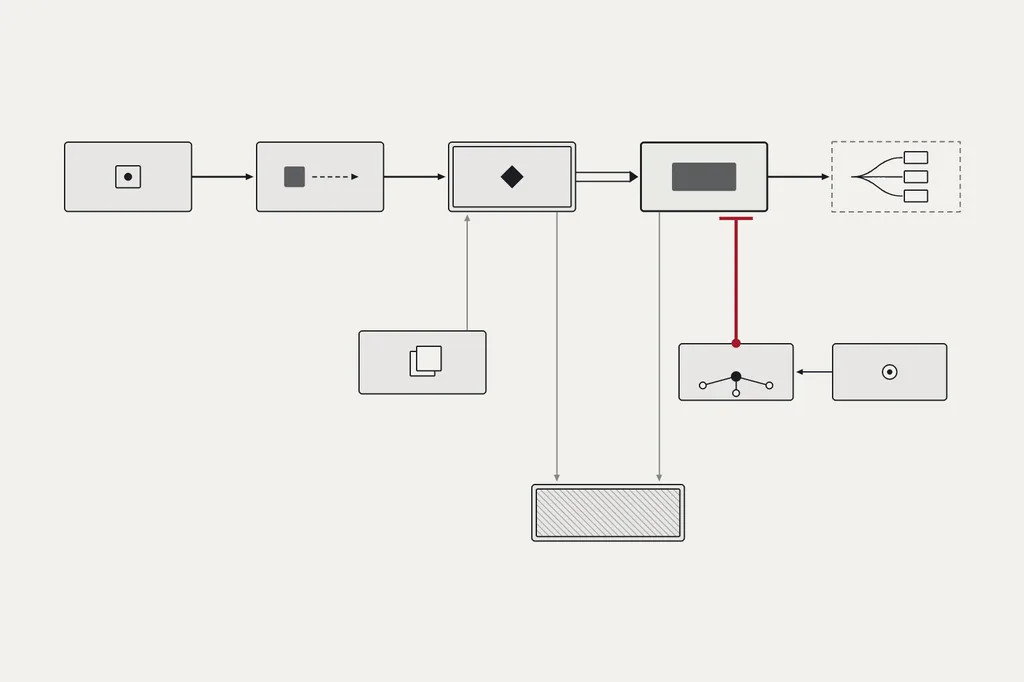
11. Was würde meine Meinung ändern?
Ein Argument über Risiken sollte sagen, welche Belege es schwächen könnten.
Meine Sorge über einen bestimmten Missbrauchsweg würde ich verringern, wenn gut gebaute Evaluationen unter realistischen Bedingungen wiederholt kaum zusätzliche Fähigkeiten zeigten, wenn die praktischen Engpässe über verschiedene Akteure hinweg erheblich blieben oder wenn Verbesserungen der Verteidigung die Folgen nachweislich schneller verringerten, als die Unterstützung sie ausweitet. Die frühen Studien zum biologischen Risiko erinnern daran, nach solchen Belegen zu suchen, statt sie auszublenden, weil sie die These verkomplizieren.
Meine Sorge würde wachsen, wenn Unterstützung verlässliche Verbesserungen bei folgenreichen, abgeschlossenen Aufgaben brächte, wenn eine billigere Ausführung bisher gebremste Akteure in Reichweite brächte oder wenn Systeme trotz unabhängig geprüfter Kontrollen wiederholt Grenzen überschritten. Das sind verschiedene Beobachtungen. Man sollte sie nicht zu einer allgemeinen Behauptung zusammenpressen, KI werde «gefährlicher».
Beim Einsatz in Institutionen würde ich sehen wollen, ob Widerspruch tatsächlich funktioniert. Kann die betroffene Person genug über eine Entscheidung erfahren, um sie anzufechten? Kann ein Betreiber einen Prozess anhalten, ohne zuerst dasselbe System zu überzeugen, das ihn empfohlen hat? Kann die Organisation Rechenschaft über das Geschehene ablegen, wenn ihre bevorzugte Erklärung falsch ist?
Das sind vorgeschlagene Prüfungen des Arguments. Eine Rangliste der Risiken liefern sie nicht im Voraus.
Ich würde mich auch gegen eine einfache Antwort wehren, wonach die sicherste Welt jene ist, in der am wenigsten Menschen leistungsfähige Werkzeuge nutzen können. Beschränkter Zugang kann manchen Missbrauch begrenzen und zugleich nützliche Fähigkeiten und die Macht, über ihren Einsatz zu entscheiden, konzentrieren. Breiter Zugang kann Nutzen verteilen und zusätzliche Angriffsflächen schaffen. Keine dieser Anordnungen rechtfertigt sich von selbst, nur weil man sie Sicherheit oder Befähigung nennt.
Dieselbe Frage muss der Fähigkeit folgen, wohin sie auch geht: Wer kann handeln, auf wen, und unter welcher wirksamen Grenze?
12. Das ältere Problem
Ich weiss nicht, ob künftige KI-Systeme die Fähigkeiten entwickeln werden, die für einen schweren Verlust menschlicher Kontrolle nötig wären. Ich glaube nicht, dass die Unsicherheit in dieser Frage uns erlaubt, die Forschung abzutun.
Aber ich brauche keine Antwort darauf, um mir über etwas anderes Sorgen zu machen.
Ein System kann ein schädliches Ziel leichter verfolgbar machen. Es kann eine überstürzte Entscheidung leichter ausführbar machen. Es kann einer Organisation erlauben, in einem Massstab zu handeln, den die Betroffenen kaum durchschauen oder anfechten können. In jedem dieser Fälle kann das eigentliche Versagen eintreten, während das System für den Menschen, der es lenkt, nützlich bleibt.
Deshalb beantwortet Gehorsam die Sicherheitsfrage für mich nicht. Die Zufriedenheit des Betreibers ist ein Beleg über eine einzige Beziehung. Sie ist kein Beleg dafür, dass alle anderen sicher sind.
Ich halte auch wenig davon, zu folgern, die Menschen seien hoffnungslos. Dieselbe Spezies, die gefährliche Anordnungen schafft, kann sie untersuchen, Grenzen bauen, Belege sichern und lernen, anzuhalten. Die Bereitschaft zu dieser Arbeit gehört ebenfalls zur menschlichen Natur.
Was mich beunruhigt, ist Fähigkeit, die als ihre eigene Rechtfertigung gilt: die Annahme, weil etwas jetzt schneller, mit weniger Leuten und mit weniger Reibung möglich ist, seien diese Veränderungen Grund genug, es zu tun.
Sie sind ein Grund, das Ziel noch einmal anzusehen.
Intelligenz garantiert kein Urteilsvermögen. Einen Plan ausführen zu können, entscheidet nicht darüber, ob er ausgeführt werden soll. Ein KI-System kann bei der Arbeit helfen und diese Verantwortung genau dort lassen, wo sie war: bei den Menschen, die es wählen, ermächtigen, bauen und betreiben.
Vielleicht werden Maschinen eines Tages Gefahren schaffen, die wirklich ihre eigenen sind. Wir sollten diese Möglichkeit erforschen. Wir sollten aber auch fähig bleiben, eine Gefahr zu erkennen, die auf eine ganz und gar menschliche Anweisung hin eintrifft.
Die Maschine muss nicht rebellieren. Sie muss nur jemandem gehorchen.
Quellen
Recherchestand dieses Bandes ist der 1. Oktober 2026. Die Veröffentlichungsdaten unten sind wichtig: Ältere Experimente werden nicht als Evaluationen heutiger Modelle dargestellt. Berichte von Anbietern sind zugeschriebene Beobachtungen; Prognosen und erfundene Szenarien sind als solche gekennzeichnet. Das begleitende Quellenregister hält Zugriffsumfang, Grenzen und redaktionelle Prüfungen fest. Dieser Band bietet ein Argument über Sicherheit und Autorität, keinen zahlenmässigen Vergleich existenzieller Risiken.
Footnotes
-
International AI Safety Report, International AI Safety Report 2026: Extended Summary for Policymakers, 3. Februar 2026. Zusammenfassung; vollständiger Bericht. ↩ ↩2
-
Miles Brundage et al., The Malicious Use of Artificial Intelligence: Forecasting, Prevention, and Mitigation, Februar 2018. arXiv:1802.07228. ↩
-
Thierry Gilgen, The Optimisation Trap. Interner gedanklicher Vorläufer, keine unabhängige Bestätigung. ↩
-
Thierry Gilgen, The Fiduciary Machine. ↩
-
Thierry Gilgen, Human Sovereignty. ↩
-
Columbia Accident Investigation Board, Columbia Accident Investigation Board Report, Band I, August 2003. Eintrag und Bericht im NASA Technical Reports Server. Befund zur organisatorischen Ursache; kein KI-Vergleich durch das Board. ↩
-
Nancy Leveson, «A new accident model for engineering safer systems», Safety Science 42(4), 2004, S. 237–270. DOI:10.1016/S0925-7535(03)00047-X. ↩
-
Anthropic, Detecting and countering misuse of AI: September 2026 (Threat-Intelligence-Bericht), 10. September 2026. Bericht. Telemetrie des Anbieters; die biologischen Fälle belegen keine schädliche Absicht. ↩ ↩2
-
UK National Cyber Security Centre, Impact of AI on cyber threat from now to 2027, 7. Mai 2025. Einschätzung. ↩
-
Dave Chismon, «One does not simply defend agentically», UK National Cyber Security Centre, 21. September 2026. Artikel. ↩
-
Christopher A. Mouton, Caleb Lucas und Ella Guest, The Operational Risks of AI in Large-Scale Biological Attacks: Results of a Red-Team Study, RAND, 25. Januar 2024. Bericht. DOI:10.7249/RRA2977-2. ↩
-
OpenAI, «Building an early warning system for LLM-aided biological threat creation», 31. Januar 2024. Studienbericht. ↩
-
Jasper Götting et al., Virology Capabilities Test (VCT): A Multimodal Virology Q&A Benchmark, April 2025. arXiv:2504.16137. Zusammen mit der Aktualisierung VCT-v2 vom September 2026 zu lesen. ↩
-
SecureBio, Nelly Mak und Jasper Götting, «Introducing VCT-v2 — the updated Virology Capabilities Test», 11. September 2026. Mitteilung der Entwickler. ↩
-
Steph Guerra et al., Building a Defense-in-Depth Biosecurity Strategy for the AI Era, RAND, 18. August 2026. Bericht. DOI:10.7249/RRA4999-1. ↩
-
Fabio Urbina, Filippa Lentzos, Cédric Invernizzi und Sean Ekins, «Dual use of artificial-intelligence-powered drug discovery», Nature Machine Intelligence 4, 2022, S. 189–191. Artikel; frei zugängliches Autorenmanuskript. DOI:10.1038/s42256-022-00465-9. ↩
-
Organisation für das Verbot chemischer Waffen (OPCW), «OPCW releases landmark report on AI and the Chemical Weapons Convention», 11. März 2026, zum wissenschaftlichen Bericht, der am 3. März veröffentlicht wurde. Offizielle Mitteilung. ↩
-
Vladislav Chernavskikh und Jules Palayer, The Impact of Military Artificial Intelligence on Nuclear Escalation Risk, SIPRI Insights on Peace and Security, Juni 2025. Publikation. DOI:10.55163/FZIW8544. ↩
-
Internationales Komitee vom Roten Kreuz (IKRK), «Frequently asked questions on artificial intelligence in the military domain», Seite datiert auf den 11. Juni 2026. FAQ, abgerufen am 1. Oktober 2026. ↩
-
Zana Buçinca, Maja Barbara Malaya und Krzysztof Z. Gajos, «To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI in AI-assisted Decision-making», Proceedings of the ACM on Human-Computer Interaction, 2021. Autorenmanuskript. DOI:10.1145/3449287. ↩
-
Thierry Gilgen, Talking Is Not Surrender. ↩
-
Francesco Salvi, Manoel Horta Ribeiro, Riccardo Gallotti und Robert West, «On the conversational persuasiveness of GPT-4», Nature Human Behaviour 9, 2025, S. 1645–1653. Aktualisierter Artikel. DOI:10.1038/s41562-025-02194-6. Eine Korrektur der Autoren vom 3. September 2026 (Mitteilung) betrifft den Vergleich zwischen personalisiertem und nicht personalisiertem GPT-4, nicht den Vergleich mit menschlichen Gegenübern. Eine Effektstärke wird hier nicht wiedergegeben. ↩
-
Thierry Gilgen, The Compounding Class. ↩
-
Alan Chan et al., What if automating AI R&D triggers an intelligence explosion?, Frontier AI Working Paper Series No. 2/2026, September 2026. Publikationsseite; Papier. ↩
-
National Institute of Standards and Technology, Artificial Intelligence Risk Management Framework (AI RMF 1.0), 26. Januar 2023. Seite zum Rahmenwerk. DOI:10.6028/NIST.AI.100-1. Die Version ist angegeben; laut der Seite wird das Rahmenwerk derzeit überarbeitet. ↩
-
Jerome H. Saltzer und Michael D. Schroeder, «The Protection of Information in Computer Systems», Proceedings of the IEEE 63(9), September 1975, S. 1278–1308. Text auf einem Universitätsserver. DOI:10.1109/PROC.1975.9939. ↩
-
Thierry Gilgen, Access Is Not Authority. ↩
-
Madeleine Clare Elish, «Moral Crumple Zones: Cautionary Tales in Human-Robot Interaction», Engaging Science, Technology, and Society 5, 2019, S. 40–60. Artikel. DOI:10.17351/ests2019.260. ↩
-
Thierry Gilgen, Incident Ownership Without a Principal. ↩
-
Thierry Gilgen, The World Does Not Reset. ↩