Neun Menschen, zwölf Fragen
Am 15. Oktober 2026 sassen in Luzern neun Menschen in einem Raum und beantworteten zwölf Fragen mit erhobener Hand. Sie waren zu einer kleinen Redaktionsrunde gekommen, die «AI-First. Aber nicht blind.» hiess. Alle haben beruflich in irgendeiner Form mit KI zu tun. Das war die ganze Stichprobe. Kein Umfrageinstitut, kein Branchenbarometer. Neun Menschen in einem Raum.
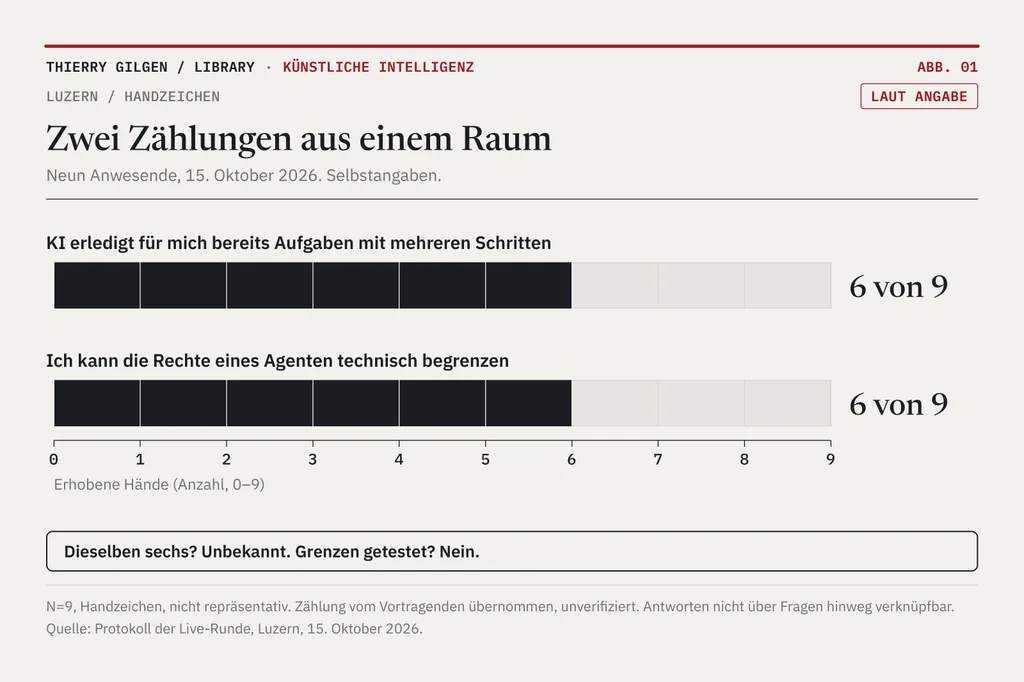
Sechs von ihnen sagten, sie liessen KI bereits Aufgaben mit mehreren Schritten selbstständig erledigen. Sechs sagten auch, sie könnten die Rechte eines KI-Agenten technisch begrenzen, nicht nur mit der Bitte, etwas zu unterlassen. Ob es dieselben sechs waren, wissen wir nicht. Die Zahlen sind vom Vortragenden übernommen, so wie er sie im Raum gezählt hat, und niemand hat sie nachgeprüft. Und keine einzige dieser technischen Grenzen haben wir überprüft.
Verstecken muss man davon nichts. Gerade hier beginnt die richtige Frage. Was heisst Kontrolle, wenn Software nicht mehr nur antwortet, sondern handelt?
Der Titel dieses Bandes kam aus dem Raum. We Gave AI the Keys wurde mündlich bestätigt; Stimmen gezählt hat dabei niemand. Vielleicht passte das Bild, weil es so alltäglich ist. Wir geben jemandem einen Schlüssel, damit eine Arbeit erledigt wird. Einem Agenten geben wir manchmal gleich den Generalschlüssel mit und hoffen, eine gut formulierte Anweisung werde schon genügen.
Vom hilfreichen Text zur ausgeführten Handlung
Ein Chatbot, der einen Entwurf vorschlägt, ist das eine. Ein Agent, der Dateien ändert, Nachrichten verschickt, eine Datenbank abfragt oder Änderungen in einem Code-Repository vorbereitet, ist etwas anderes. Der erste liefert vor allem Information. Der zweite kann den Zustand eines Systems verändern. Ein sprachlicher Ausrutscher, der in einem Entwurf bloss peinlich wäre, kann in einem Ablauf mit weitreichenden Rechten echte Folgen haben.
Die Unsicherheit steckt nicht im Sprachmodell allein. Ein Agent bewegt sich durch Schnittstellen, Werkzeuge, Tokens, APIs und menschliche Freigaben. Was er tatsächlich tun kann, ergibt sich aus diesem ganzen Gefüge. Ein Satz im Systemprompt, «Du darfst nichts löschen», sichert etwas anderes ab als ein Konto, dessen Berechtigungen schlicht keine Löschoperation enthalten.
OWASP nennt dieses Risiko in LLM-Systemen Excessive Agency, übermässige Handlungsmacht. Es entsteht etwa, wenn ein Werkzeug mehr Funktionen hat, als die Aufgabe verlangt, wenn Rechte zu weit reichen oder wenn folgenreiche Aktionen ohne wirksame Prüfung ablaufen können.1 Die neuere OWASP-Liste für agentische Anwendungen führt den Missbrauch von Werkzeugen und den Missbrauch von Identitäten und Rechten als eigene Kategorien.2 Solche Listen ordnen Risikoarten. Wie oft echte Zwischenfälle vorkommen, messen sie nicht.
Ein fremder Text ist kein neuer Chef
Ein weiterer Bruch öffnet sich dort, wo Agenten lesen. Eine E-Mail, eine Website oder eine Datei kann Daten enthalten, die für die Aufgabe wirklich nötig sind. Sie kann aber auch Anweisungen enthalten, die der eigentliche Nutzer nie gegeben hat.
Das Sicherheitsteam von Google DeepMind beschreibt das als indirect prompt injection, ein Begriff, den Googles eigener Beitrag Greshake und anderen zuschreibt: Angreifer verstecken manipulative Anweisungen in fremden Inhalten, die das System während einer legitimen Aufgabe verarbeitet.3 Greshake und Mitautoren zeigten 2023, dass solche Angriffe bei realen Anwendungen funktionierten, und hielten fest, dass wirksame Gegenmittel fehlten.4 Googles veröffentlichtes Bedrohungsmodell zeigt einen Agenten, der eine E-Mail zusammenfassen soll und durch den Inhalt eben dieser E-Mail dazu gebracht werden könnte, vertrauliche Informationen an eine fremde Adresse zu schicken. Das Beispiel ist ein Sicherheitsmodell. Es belegt nicht, dass jeder Agent auf diese Weise zu kompromittieren ist. Gelöst ist das Problem allerdings auch nicht: In einem späteren Bericht stellte Google DeepMind fest, dass adaptive Angriffe, die sich der Abwehr laufend anpassen, einfache Schutzmassnahmen, die gegen feste Tests genügt hatten, deutlich weniger wirksam machten.5
Damit wird sichtbar, wo die Vertrauensgrenze verläuft. Der Text einer E-Mail darf als Grundlage für ihre Zusammenfassung dienen. Er darf keine Befugnis erhalten, weitere Daten irgendwohin zu schicken. Eine robuste Architektur entscheidet ausserhalb des Sprachmodells, welche Operation zulässig ist, mit welchen Daten und für welchen Auftrag. Technisch begrenzte Identitäten, eng zugeschnittene Werkzeuge und eine zweite Prüfung kritischer Aktionen wiegen deshalb mehr als die Zusicherung, der Agent werde schon vorsichtig sein.
Wer hält den Schlüssel, und wer steht dafür ein?
Es wäre bequem, die Verantwortung beim Agenten abzuladen. Doch wer die Arbeit einem Agenten übergibt, gibt damit nicht ohne Weiteres auch die Verantwortung ab. Jemand muss den Auftrag begrenzen, Zugriffe bewilligen, Ergebnisse prüfen und im Zweifel anhalten können.
Das AI Risk Management Framework von NIST ordnet das Risikomanagement vier Funktionen zu: Govern, Map, Measure und Manage.6 Eine bestimmte technische Architektur schreibt es nicht vor. Aber es hält die entscheidenden Fragen im Blick. Wer legt die Regeln fest? Welche Risiken sind in diesem konkreten Einsatz denkbar? Woran erkennen wir, ob die Schutzmassnahmen greifen? Wer handelt, wenn etwas schiefgeht?
Ein Papier von Google aus dem Jahr 2025 zu sicheren KI-Agenten nennt drei zusammenhängende Grundsätze: klar bestimmte menschliche Verantwortliche, begrenzte Befugnisse sowie Handlungen und Planung, die sich beobachten lassen.7 Es kommt auf das Zusammenspiel an. Protokolle allein machen eine gefährliche Berechtigung nicht sicher. Enge Zugriffe allein zeigen nicht, ob das Ergebnis stimmt. Und eine menschliche Freigabe, die bloss weggeklickt wird, schützt kaum besser als gar keine.
Daraus ergibt sich ein brauchbares Kontrollmodell.
Möglichst wenig Rechte. Ein Rechercheagent muss in der Regel lesen können. Quellen überschreiben oder Produktionssysteme verändern muss er nicht. Ein Schreibagent braucht nicht automatisch das Recht, seine Arbeit selbst zu veröffentlichen.
Grenzen für jeden Lauf. Jede Aufgabe braucht einen festgelegten Umfang, ein Budget für Zeit und Kosten und Regeln für heikle Daten. Rechte sollten kurzlebig sein und an den konkreten Zweck gebunden.
Prüfbare Ergebnisse. «Aufgabe erledigt» ist noch keine Abnahme. Ein Ablauf sollte vorher festhalten, was geprüft wird und welche Fehler ihn anhalten.
Unabhängige Freigabe. Folgenreiche Aktionen wie Veröffentlichen, Bezahlen, Löschen oder ein Deploy in die Produktion dürfen nicht allein deshalb geschehen, weil derselbe Agent sie für richtig hält.
Ein echter Halt. Ein System muss Aktionen technisch unterbrechen können und den Agenten nicht bloss höflich darum bitten.
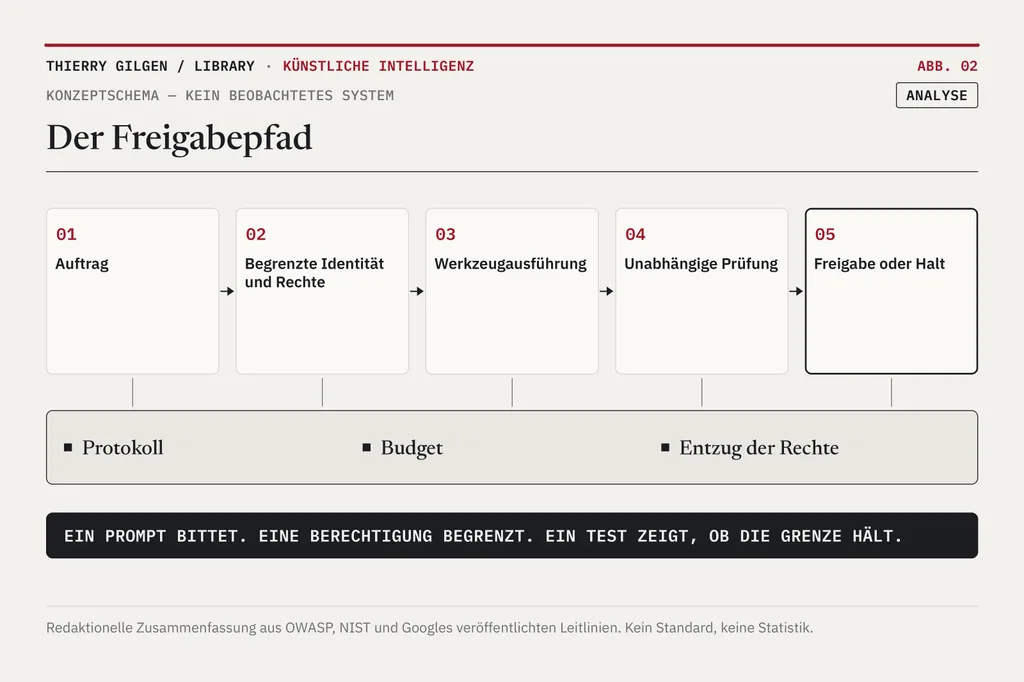
Diese fünf Punkte sind unsere eigene redaktionelle Zusammenfassung aus der Literatur zu Sicherheit und Risikomanagement. Sie zitieren keinen Standard wörtlich.
Der stärkste Einwand: Zu viel Kontrolle macht KI nutzlos
Man kann mit gutem Grund widersprechen. Jede zusätzliche Freigabe bremst die Arbeit. Zu enge Rechte führen zu ständigen Rückfragen, und ein Agent, der bei jedem Schritt einen Menschen braucht, automatisiert womöglich kaum etwas. Auch herkömmliche Software arbeitet mit Dienstkonten, Warteschlangen und geplanten Jobs, ohne dass jemand jede einzelne Aktion absegnet.
In einem Punkt hat der Einwand recht: Nicht jede Aktion verdient gleich viel Kontrolle. Eine interne Skizze ist kein Deploy in die Produktion. Eine Datenbankabfrage ist keine Datenbanklöschung. Die vernünftige Antwort besteht also nicht darin, Agenten handlungsunfähig zu machen. Sie besteht darin, Rechte und Prüfungen nach Wirkung und Risiko abzustufen. Aufgaben mit geringem Risiko können weitgehend selbstständig laufen, die kritischen Grenzen bleiben technisch und organisatorisch geschützt.
Doch auch dieses Modell genügt allein nicht. Rechte können falsch eingerichtet sein. Freigabeketten lassen sich umgehen. Agenten können Werkzeuge auf eine Weise kombinieren, mit der niemand gerechnet hat. Und eine menschliche Freigabe nutzt sich ab. Wer eine Routineaktion nach der anderen bestätigen soll, bestätigt irgendwann aus Gewohnheit, und einem System, das oft richtig lag, traut man rasch. Dann wird die Freigabe zum Stempel: Im Schema steht sie noch, geprüft wird nichts mehr. Ein Grund mehr, Freigaben den wenigen Aktionen vorzubehalten, die sie wirklich brauchen. Teams müssen deshalb nicht nur die erlaubten Wege testen, sondern gerade die verbotenen. Kann der Rechercheagent wirklich nicht schreiben? Kann ein fremdes Dokument ihn wirklich nicht dazu bringen, Daten herauszugeben? Greift der Halt, wenn das Budget aufgebraucht ist? Eine Sicherheitsregel, deren Durchsetzung niemand ausprobiert hat, ist vorerst eine Behauptung.
Wo die Verantwortung bei uns bleibt
Die Handzeichen in Luzern haben nichts über die Sicherheitslage der KI-Branche gemessen. Sie haben aber eine Frage sichtbar gemacht, die sich jedes Team stellen sollte, bevor seine Agenten mehr übernehmen: Wenn wir ihnen Schlüssel geben, wissen wir dann genau, welche Türen sich damit öffnen lassen?
Selbstständige Arbeit und unkontrollierte Arbeit sind nicht dasselbe. Gute Agentensysteme sind nicht deshalb wertvoll, weil niemand mehr hinschaut, sondern weil Menschen weniger Routine erledigen müssen und trotzdem wissen, wer entscheidet, was erlaubt ist, und wann Schluss ist.
Ein Prompt bittet. Eine Berechtigung begrenzt. Ein Test zeigt, ob die Grenze hält.
Methode und Grenzen
Die Zahlen stammen aus einer einzigen Live-Runde in Luzern am 15. Oktober 2026, mit neun Anwesenden, deren Arbeit laut Anlassbeschreibung mit KI zu tun hat. Es war keine Zufallsstichprobe. Zwölf Fragen wurden nacheinander gestellt, eine erhobene Hand galt als Ja; alles andere kann Nein, unentschieden, nicht teilgenommen oder ein übersehenes Handzeichen bedeuten. Gezählt hat der Vortragende; die Zahlen sind von ihm übernommen und nicht unabhängig überprüft. Die Antworten lassen sich nicht über die Fragen hinweg verknüpfen, darum wissen wir nicht, ob die sechs bei der einen Frage dieselben sind wie bei der anderen. Alle Antworten sind Selbstangaben; keine technische Kontrolle wurde getestet. Neun Stimmen in einem Raum erlauben keine Verallgemeinerung auf Luzern, auf Unternehmen, auf Berufe oder auf die KI-Branche. Fotos von Teilnehmenden wurden für diesen Band keine gemacht.
Die meisten Sicherheitsquellen hier stammen von Google und beschreiben eigene Systeme und eigene Forschung; OWASP, NIST und die wissenschaftliche Studie von Greshake und Mitautoren bilden das unabhängige Gegengewicht. Das Profil von NIST zu generativer KI diente nur als Hintergrund.8 Die Sicherheitsquellen beschreiben Arten von Risiken und wie man mit ihnen umgeht. Keine nennt eine Häufigkeit von Vorfällen oder Schäden, und auch dieser Band nennt keine.
Quellen
Footnotes
-
OWASP Gen AI Security Project, 2025. LLM06:2025 Excessive Agency. Zu viele Funktionen, zu weite Rechte, zu viel Autonomie, dazu Gegenmassnahmen. Eine Risikosystematik, keine Messung der Häufigkeit von Vorfällen. ↩
-
OWASP Gen AI Security Project, 9. Dezember 2025. OWASP Top 10 for Agentic Applications. Nennt unter anderem Goal Hijack, Tool Misuse sowie Identity & Privilege Abuse. Eine Systematik, keine Häufigkeitsangaben. ↩
-
Agentic AI Security Team, Google DeepMind, Januar 2025. How we estimate the risk from prompt injection attacks on AI systems. Bedrohungsmodell mit einem Agenten, der E-Mails zusammenfasst, und präparierter Post; schreibt den Begriff indirect prompt injection Greshake und anderen zu. Darstellung des Anbieters selbst. ↩
-
Kai Greshake, Sahar Abdelnabi, Shailesh Mishra, Christoph Endres, Thorsten Holz, Mario Fritz, arXiv:2302.12173, Februar 2023 (v2 Mai 2023). Not what you’ve signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. Unabhängige wissenschaftliche Studie: indirect prompt injection an realen Systemen vorgeführt; laut Abstract fehlen wirksame Gegenmittel. Momentaufnahme von 2023, keine aktuelle Häufigkeitsmessung. ↩
-
Google DeepMind, 20. Mai 2025. Advancing Gemini’s security safeguards. Gestaffelte Abwehr und Tests gegen adaptive Angriffe; berichtet, dass einfache Schutzmassnahmen gegen adaptive Angriffe deutlich weniger wirksam waren. Bericht des Anbieters über die eigenen Modelle. ↩
-
NIST, 26. Januar 2023. AI Risk Management Framework 1.0, Core. Die vier Funktionen Govern, Map, Measure und Manage. Ein freiwilliger Rahmen, keine gesetzliche Pflicht und keine Zertifizierung. ↩
-
Santiago Díaz, Christoph Kern, Kara Olive, Google, 2025. An Introduction to Google’s Approach for Secure AI Agents. Drei Grundsätze: klar bestimmte menschliche Verantwortliche, begrenzte Befugnisse, beobachtbare Handlungen und Planung. Rahmen des Anbieters selbst. ↩
-
NIST, 26. Juli 2024 (NIST AI 600-1). Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Nur Hintergrund; keine Zahlen zu Vorfällen daraus übernommen. ↩