Von der Analytical Engine bis zum Zeitalter der Agenten: eine Geschichte von Maschinen, Versprechen und wechselnden Definitionen.
Der Sommer, der die Intelligenz klären sollte
Im August 1955 reichten vier Forscher einen Antrag für den folgenden Sommer ein. Eine kleine Gruppe von Wissenschaftlern sollte zwei Monate am Dartmouth College untersuchen, ob Maschinen Sprache verwenden, Begriffe bilden, Probleme lösen und sich selbst verbessern können. Ihre Ausgangsvermutung war kühn: Vielleicht lasse sich jedes Merkmal des Lernens oder der Intelligenz so genau beschreiben, dass eine Maschine es nachbilden kann.
John McCarthy, Marvin Minsky, Nathaniel Rochester und Claude Shannon gaben dem geplanten Gebiet seinen Namen: künstliche Intelligenz. Ihr Dokument trägt das Datum 31. August 1955; das Treffen fand im Sommer 1956 statt. Die Daten sind wichtig, weil die populäre Fassung der Geschichte einen Antrag, eine Veranstaltung und die Geburt einer ganzen Disziplin gern zu einem einzigen Moment zusammenschiebt.12
Im Antrag steht auch ein Satz, den man heute noch einmal lesen sollte. Das Haupthindernis sahen die Autoren nicht einfach in fehlender Rechenleistung, sondern darin, dass niemand Programme zu schreiben verstand, die die vorhandenen Maschinen wirklich ausnutzten.1
Siebzig Jahre später streiten wir über dieselbe Frage, nur vom anderen Ende her. Rechenleistung haben wir im Überfluss. Wir haben Systeme, die Programme schreiben. Und doch tun wir uns schwer zu sagen, wann solche Systeme verlässlich sind, wahrhaftig, befugt zu handeln oder kompetent genug, um ohne ständige Aufsicht Folgen zu tragen.
Die Gruppe in Dartmouth hat die Intelligenz nicht entschlüsselt. Sie gab einem Streit, der längst begonnen hatte, einen dauerhaften Namen. Und dieser Streit hat seine Bedingungen seither immer wieder geändert.
Diese Geschichte lohnt es zu erzählen.
01 · Bevor die KI einen Namen hatte, hatte sie schon ein Problem
1843 veröffentlichte Ada Lovelace ausführliche Anmerkungen zu Charles Babbages geplanter Analytical Engine. Die Maschine wurde nie so gebaut, wie sie entworfen war. Aber Lovelace erkannte, dass eine universelle Symbolmaschine im Prinzip mehr bearbeiten konnte als gewöhnliche Arithmetik. Liessen sich Beziehungen formal ausdrücken, dann konnte die Maschine damit arbeiten. Zugleich warnte sie davor, ihre Kräfte zu überschätzen: Sie könne ausführen, was Menschen ihr anzuordnen wüssten, aber keine mathematischen Wahrheiten von sich aus vorwegnehmen.3
Das war weder eine Vorhersage von ChatGPT noch eine endgültige Widerlegung maschineller Kreativität. Es war etwas Nützlicheres: eine Unterscheidung zwischen der Maschine, den Anweisungen und den Behauptungen, die man über beide aufstellt. Turing griff diesen Einwand, später «Lady Lovelace’s objection» genannt, ein Jahrhundert danach wieder auf.4
1936 beschrieb Alan Turing mathematisch, was ein berechenbares Verfahren ist. 1943 fassten Warren McCulloch und Walter Pitts vereinfachte, neuronenähnliche Elemente in logische Begriffe. 1948 bot Norbert Wieners Cybernetics ein anderes Vokabular an: Rückkopplung, Kommunikation, Steuerung und die Ähnlichkeiten zwischen Lebewesen und Maschinen. Das waren verschiedene Vorhaben, keine Spielarten eines einzigen Algorithmus. Aber sie erlaubten die Frage, ob man Denken und Handeln als Vorgänge behandeln kann statt als Rätsel.567
1950 fragte Turing, ob Maschinen denken können, und ersetzte die Frage dann durch einen praktischen Test mit einem Gespräch, das Imitationsspiel. Ein Messgerät für Bewusstsein wollte er damit nicht liefern. Er forderte seine Leser auf zu prüfen, welche Belege sie für intelligentes Verhalten gelten lassen würden, und warum.4
Man beachte die Reihenfolge. Zuerst kamen die formale Berechnung, künstliche Neuronen, Rückkopplung und der Streit um Belege. Erst danach kam das institutionelle Etikett KI.
Der Name schuf nicht die Möglichkeit. Er schuf ein Fach, in dem unvereinbare Methoden um das Recht wetteifern konnten, sie zu erklären.
02 · Die ersten Vorführungen und ihre kleinen Welten
Schon vor Dartmouth, 1954, führten IBM und die Georgetown University öffentlich eine maschinelle Übersetzung vor. Ein begrenzter Wortschatz vom Russischen ins Englische und eine Handvoll Grammatikregeln ergaben einen eindrücklichen Auftritt. Im sorgfältig kontrollierten Rahmen tat die Maschine, was man sie tun liess. Was sie nicht zeigte, war die Übersetzung freier, unbeschränkter Sprache.8
Nach Dartmouth entwickelte das Fach rasch mehrere Persönlichkeiten.
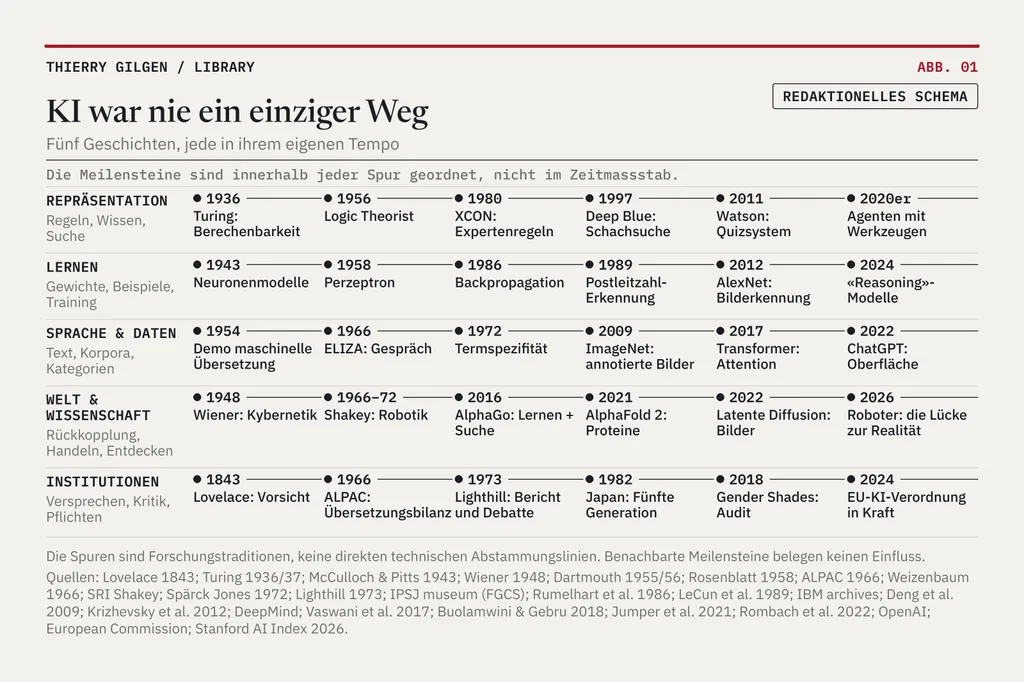
Allen Newell, Herbert Simon und Cliff Shaw arbeiteten an Programmen, die Symbole verarbeiteten und logische Beweise suchten. Diese Tradition verstand Intelligenz als geordnetes Schliessen: die Welt darstellen, erlaubte Operationen festlegen, nach Schlussfolgerungen suchen. Frank Rosenblatts Perzeptron, 1958 öffentlich vorgeführt, verfolgte einen ganz anderen Ehrgeiz: das Verhalten der Maschine anpassen, indem man aus Beispielen numerische Verbindungen verändert. Arthur Samuels Forschung am Damespiel zeigte, dass ein Programm durch Erfahrung besser spielen konnte.2910
Die verbreitete Vorstellung, die KI habe als symbolisches Schliessen begonnen und das Lernen erst Jahrzehnte später entdeckt, ist falsch. Lernen war fast von Anfang an da. Ebenso Methoden, die auf Wahrscheinlichkeit, Regelung, Suche und Verkörperung setzten. Die Frage war nicht, ob Computer lernen oder schliessen sollten. Die Frage war, welcher Ansatz noch trägt, wenn das ordentliche Beispiel aufhört.
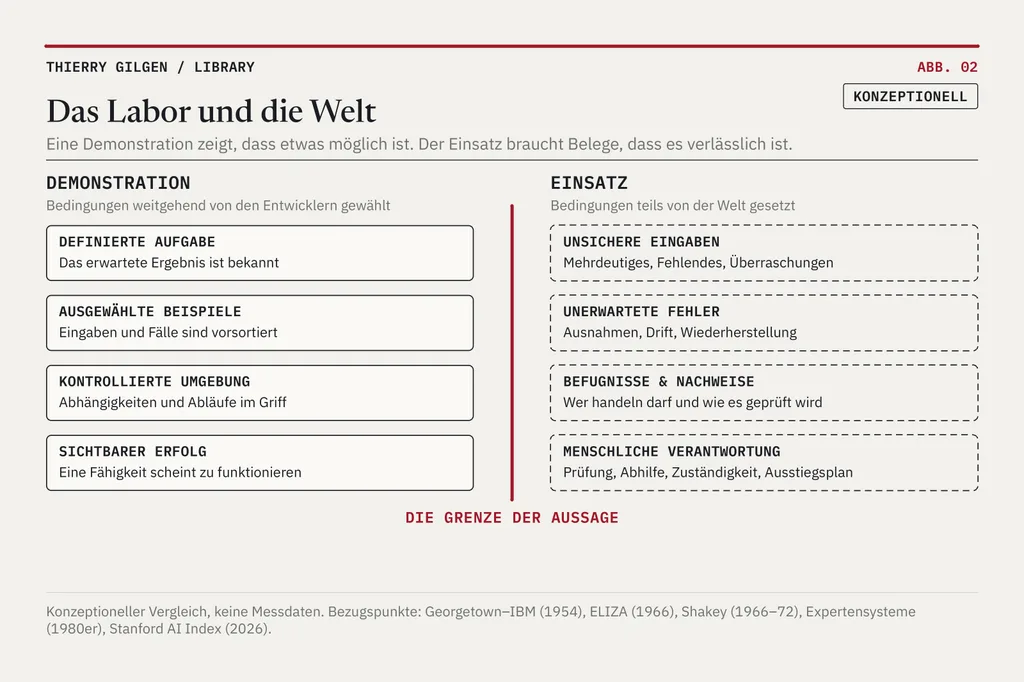
Zwischen einer Vorführung und einem Einsatz gab es zudem ein wiederkehrendes Ungleichgewicht. Bei einer Vorführung wählen die Forschenden die Aufgabe, die Beispiele, den Zeitpunkt und die Grenzen. Im Einsatz wählt die Welt vieles davon für sie.
Dieser Unterschied sollte fast jeden späteren Aufschwung und jede Enttäuschung prägen.
03 · Die Maschine, die klang, als verstünde sie
Joseph Weizenbaums ELIZA, 1966 beschrieben, konnte ein Gespräch nachahmen, indem es Muster erkannte und Teile des eingegebenen Textes nach Regeln umstellte. Eines der Skripte glich einem nicht-direktiven Psychotherapeuten. Die Antworten brachten Menschen erstaunlich gut dazu, weiterzureden, obwohl das Verständnis fehlte, das viele dem Programm zuschreiben wollten.11
ELIZA ist nicht deshalb wichtig, weil es eine frühe Form heutiger Sprachmodelle gewesen wäre. Technisch war es grundlegend anders. Wichtig ist es, weil es etwas Dauerhaftes über uns zeigte: Menschen schliessen aus der Form eines Austauschs auf Kompetenz, Zuwendung oder Verständnis, bevor sie nachsehen, wie das System funktioniert.
Im selben Jahr legte das amerikanische Automatic Language Processing Advisory Committee eine skeptische Bilanz der maschinellen Übersetzung vor. Der Bericht stellte optimistische Aussagen über Fortschritt und praktischen Nutzen in Frage und trug dazu bei, dass die amerikanische Forschungsförderung umgelenkt wurde. Er stoppte die Forschung nicht überall, und er bewies auch nicht, dass Übersetzung unmöglich sei.12
Ein einziges Jahr fasste also beides: den Anschein von Gesprächsverständnis und den institutionellen Vertrauensverlust in die Sprachtechnik.
Im scheinbaren Widerspruch liegt die Lehre. Eine Maschine kann vor Ort eine überzeugende Erfahrung erzeugen, ohne das allgemeine Problem zu lösen. Und ein Fach kann erhebliche Fortschritte machen, ohne schon die wirtschaftlichen oder betrieblichen Ergebnisse zu liefern, die es versprochen hat.
04 · Warum der erste Winter kam
Die KI-Forschung lernte, dass die naheliegenden Beispiele oft die einfachen waren. Ein mathematisches Rätsel, ein vereinfachtes Spielbrett oder ein eigens eingerichteter Raum liessen sich formal beschreiben. Gewöhnliche Wahrnehmung, Alltagswissen, Sprache und körperliches Handeln entzogen sich einer sauberen Beschreibung.
Shakey, zwischen 1966 und 1972 am Stanford Research Institute entwickelt, war ein bemerkenswerter fahrender Roboter. Er konnte eine begrenzte Umgebung wahrnehmen, Wege planen und einfache Gegenstände bewegen. Ein selbständiger Roboter für die unberechenbare Welt der Menschen war er nicht. Seine Leistung lag im schwierigen Zusammenspiel von Sehen, Planen und Bewegen, nicht darin, die Annahmen über seine Umgebung loszuwerden.13
1969 erschien Perceptrons von Marvin Minsky und Seymour Papert und legte Grenzen wichtiger Klassen früher Perzeptron-Modelle offen. Eine vereinfachte Rückschau behauptet oft, das Buch habe die neuronalen Netze im Alleingang erledigt. Das ist zu glatt. Bestimmte mathematische Grenzen, die Hardware, Forschungsmoden und Förderstrukturen wirkten zusammen; die Arbeit an lernenden Netzen ging weiter.14
In Grossbritannien schrieb James Lighthill 1972 eine kritische Bewertung der KI-Forschung. Sie erschien 1973 und wurde im selben Jahr in einer Fernsehdebatte ausgefochten. Programme und Forschungsprioritäten gerieten unter Druck. Auch amerikanische Geldgeber verschärften in Teilen des Fachs ihre Erwartungen. Historiker sprechen heute von einem ersten KI-Winter, meist angesetzt auf die Mitte der 1970er-Jahre. Aber «Winter» ist eine Metapher im Rückblick, kein weltweiter Schalter, den jemand umgelegt hätte.15
Das Aufschlussreichste daran ist nicht, dass die Begeisterung unvernünftig gewesen wäre. Viele frühe Systeme waren genial. Das Problem war, dass man ihre Erfolge leicht als Beleg für eine baldige Allgemeinheit missverstand. Die Aufgaben, die wir zuerst formalisieren können, stehen nicht unbedingt für die Arbeit, die die Maschine am Ende leisten soll.
Ein Benchmark kann bezwungen sein, und die Welt bleibt davon unberührt.
05 · Als Intelligenz zum Produkt aus Regeln wurde
Nach den ersten Enttäuschungen verschwand die künstliche Intelligenz nicht. Sie wurde nützlich, in engeren, besser umrissenen Aufgaben.
DENDRAL half, wissenschaftliche Daten in der Chemie auszuwerten. MYCIN erprobte regelbasierte medizinische Empfehlungen. In der Wirtschaft fassten Expertensysteme Fachwissen in Regeln und Schlussverfahren. XCON von der Digital Equipment Corporation, um 1980 eingeführt, um Computerbestellungen zu konfigurieren, wurde zum Sinnbild dieses Ansatzes: Software konnte ein kompliziertes Geflecht von Expertenregeln mit echtem betrieblichem Nutzen anwenden.16
Aber die Regeln mussten von irgendwoher kommen. Fachleute lieferten sie. Wissensingenieure übersetzten sie. Andere bereinigten Widersprüche, pflegten Ausnahmen nach, prüften Ergebnisse und unterhielten ein wachsendes Netz von Abhängigkeiten.
Dass man diese Software intelligent nannte, schaffte die menschliche Arbeit nicht ab, die ihre Intelligenz erst nützlich machte.
1982 startete Japan das Projekt Fifth Generation Computer Systems, ein ehrgeiziges nationales Vorhaben rund um Logikprogrammierung, Parallelrechnen und neue Rechnerarchitekturen. Es wurde weltweit als Wettbewerbssignal verstanden: KI war nicht mehr nur eine Frage für Universitäten, sondern eine der Industriepolitik. Das Projekt brachte Forschung und technische Ergebnisse hervor, seine weiterreichenden kommerziellen Ziele liessen sich dagegen schwerer erreichen.17
Auf den Boom der Expertensysteme folgte Ende der 1980er- und Anfang der 1990er-Jahre eine zweite Ernüchterung. Wartungskosten, geringe Flexibilität, sich verschiebende Hardwaremärkte und überzogene Erwartungen spielten alle mit. Wieder stand das Fach nicht still. Manche Firmen stiegen aus, andere Forschende arbeiteten weiter, und brauchbare Methoden wanderten in gewöhnliche Software.
Dieser Zyklus enthält eine Warnung für die Agentenplattformen von heute. Ein Prototyp, der den Normalfall beherrscht, ist noch kein Geschäftsprozess. Verlässlichkeit, Aktualisierungen, der Umgang mit Ausnahmen, Berechtigungen, Wiederherstellung und die Kosten menschlicher Aufsicht entscheiden darüber, ob ein scheinbar kluges System eingesetzt werden sollte.
06 · Was unter dem Winter überlebte
Die geläufige Geschichte springt von den Expertensystemen direkt zum Deep Learning. Dabei geht einige der wichtigsten Arbeit verloren.
Karen Spärck Jones’ Forschung zur Spezifität von Suchbegriffen von 1972 half, Grundsätze der statistischen Informationssuche zu begründen: Manche Wörter unterscheiden mehr als andere. Statistische und probabilistische Methoden kamen in Spracherkennung, Sprachverarbeitung, Klassifikation und Informationssuche voran, auch als die grossen KI-Ambitionen gerade neu bewertet wurden.1819
1986 zeigten David Rumelhart, Geoffrey Hinton und Ronald Williams, wie die Rückführung von Fehlern, die Backpropagation, mehrschichtige Netze so trainieren kann, dass sie nützliche innere Darstellungen lernen. Das war eine entscheidende Demonstration und Verbreitung, nicht die alleinige Erfindung der Idee. Frühere mathematische und rechnerische Arbeiten zählten mit.20
1989 wendeten Yann LeCun und Kollegen die Backpropagation auf das Erkennen handgeschriebener Postleitzahlen an. Spätere neuronale Systeme verarbeiteten Dokumente im kommerziellen Betrieb. Das war keine allgemeine Intelligenz. Es war die Brücke zwischen einer reizvollen Lerntheorie und wiederkehrenden, messbaren Aufgaben, deren Fehler und Kosten man untersuchen konnte.21
Die grössere Lehre übersieht man leicht: Nicht alles, was die Welt verändert, ist neu, wenn es berühmt wird. Eine Idee kann warten, auf passende Daten, Chips, Werkzeuge, Institutionen und Wirtschaftlichkeit. Manchmal ist der Durchbruch der Algorithmus. Manchmal ist es die Umgebung, in der dieser Algorithmus endlich praktikabel wird.
Der Fortschritt der KI gleicht eher vielen Zuflüssen als einem einzigen Strom.
07 · Die Maschine gewinnt im Schach, die Definition verschiebt sich
1997 besiegte IBMs Deep Blue Schachweltmeister Garri Kasparow in einem Match über sechs Partien. Das Ergebnis war historisch bedeutsam. Es war auch sehr speziell. Deep Blue verband gewaltige Suche, Schachwissen, Bewertungsmechanik, Ingenieurskunst und menschliche Vorbereitung. Um Kasparow im Schach zu schlagen, musste es nicht denken wie Kasparow.22
Nach dem Match liessen sich entgegengesetzte Schlüsse ziehen: Computer hatten eine Schwelle überschritten, die bisher menschlicher Intelligenz vorbehalten war. Oder Schach hatte sich als spezielle Rechenaufgabe entpuppt und nicht als das Mass des Geistes, für das wir es gehalten hatten.
In beiden Behauptungen steckt etwas Wahres, und keine klärt die philosophische Kernfrage.
2011 besiegte IBM Watson geübte menschliche Spieler in der Quizsendung Jeopardy!. Es verband Sprachanalyse, Suche, Rangierung und sorgfältige Ingenieursarbeit in einem System, das für die engen Regeln einer Quizshow gebaut war. Der Sieg war echt; die Architektur und die Grenzen der Aufgabe waren entscheidend.23
Das waren keine Umwege auf dem Weg zum Chatbot. Sie zeigten, dass sich verschiedene Formen intelligenzähnlicher Leistung mit verschiedenen Kombinationen von Methoden bauen lassen.
Die Torpfosten verschoben sich nicht einfach, weil man den Maschinen nichts gönnen wollte. Sie verschoben sich, weil der Erfolg uns zwang zu sehen, wie viel mehr zur Intelligenz gehört als die Aufgabe, die wir als ihr Stellvertreter gewählt hatten.
08 · Daten werden Teil der Erfindung
Das Projekt ImageNet, 2009 in einem Aufsatz von Jia Deng und Kollegen vorgestellt, half, eine viel grössere, hierarchisch beschriftete Sammlung zum Erkennen von Objekten in Bildern aufzubauen. Dafür mussten Kategorien gebildet, Bilder gesammelt und von Menschen annotiert werden. Die Daten waren kein objektives, natürlich gewachsenes Inventar der Welt. Forschende und Arbeitskräfte haben sie entworfen und zusammengetragen.24
2012 zeigten Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton, dass ein tiefes faltendes neuronales Netz, mit viel Rechenleistung trainiert, bei der ImageNet-Klassifikation ein spektakuläres Ergebnis erzielen konnte. Die Bedeutung reichte weiter als eine einzelne Netzarchitektur. Hier liefen Trainingsdaten, Grafikprozessoren, Optimierungsverfahren, eine Benchmark-Infrastruktur und wiederholbare Experimente zusammen.25
Man beachte, was sich daran änderte, was das Entwicklungsteam selbst schreiben musste. Bei einem Expertensystem hielt ein Mensch einen umfangreichen Bestand an Entscheidungsregeln fest. Bei einem trainierten neuronalen System legten die Ingenieure Architektur, Lernverfahren, Datensatz, Zielgrössen und Auswertung fest; die angepassten Darstellungen entstanden durch Optimierung.
Die Arbeit änderte ihre Form. Sie verschwand nicht.
Auch Verzerrungen verschwanden nicht, nur weil niemand die Regeln mehr von Hand schrieb. Was der Datensatz abbildete, was das Modell optimierte und was der Benchmark belohnte, blieben menschliche Entscheidungen, manchmal ausdrücklich, manchmal unsichtbar.
09 · Die Welt ist nicht mehr ein Benchmark nach dem anderen
2016 besiegte AlphaGo von DeepMind Lee Sedol mit vier zu eins Partien. Die Leistung beruhte auf Deep Learning, bestärkendem Lernen und Baumsuche. Oft wird sie als Beweis angeführt, dass das Lernen die klassische KI abgelöst habe. Die tatsächliche Architektur erzählt eine interessantere Geschichte: Verschiedene Methoden können einander stärken.26
2017 stellten acht Forschende in Attention Is All You Need die Transformer-Architektur vor. Den Anstoss gaben Sequenzmodellierung und maschinelle Übersetzung. Der Entwurf verzichtete in der zentralen Encoder-Decoder-Architektur auf rekurrente Berechnung und stellte die Aufmerksamkeit ins Zentrum. Diese Entscheidung half, das Training grosser Sprachmodelle wirksamer zu machen. Dass die allgemeine Intelligenz gelöst sei, verkündete der Aufsatz nicht.27
Die folgenden Jahre brachten mehrere Zweige hervor, nicht ein einziges, unvermeidliches Produkt. BERT, 2019 veröffentlicht aus Arbeiten, die 2018 erschienen waren, zeigte die Kraft bidirektionalen Vortrainings für Aufgaben des Sprachverstehens. GPT-3, 2020 beschrieben, zeigte verblüffende Fähigkeiten mit wenigen Beispielen, aus einem sehr grossen autoregressiven Sprachmodell. Forschung zur Skalierung hielt empirische Zusammenhänge zwischen Rechenaufwand, Daten, Modellgrösse und Fehlerwert fest, während spätere Arbeiten zum rechenoptimalen Training die verbreitete Annahme erschütterten, die Zahl der Parameter allein bestimme den Fortschritt.28293031
Anderswo leistete AlphaFold 2 einen grossen Beitrag zur Vorhersage von Proteinstrukturen; der wegweisende Aufsatz erschien 2021. 2022 enthielt die zugehörige Datenbank Vorhersagen für rund 200 Millionen Proteinstrukturen. Vorhersagen sind keine experimentell gemessenen Strukturen, und Proteinstrukturen vorherzusagen heisst nicht, die Biologie zu lösen. Der wissenschaftliche Nutzen ist trotzdem beträchtlich.32
Die Bilderzeugung mit Diffusionsmodellen eröffnete einen weiteren Weg zu brauchbaren generativen Systemen. Die moderne KI lief nicht ausschliesslich auf eine einzige Art von Sprachmodell zu. Sie wurde zu einer Familie industrieller und wissenschaftlicher Techniken, die sich die Recheninfrastruktur teilten, aber verschiedene Probleme lösten.33
Besser als «Welches Modell wurde intelligent?» ist die Frage: «Welche Fähigkeiten wurden in welchem Umfeld verlässlich genug, um zu zählen?»
10 · Als die Oberfläche zum Wendepunkt wurde
Die Öffentlichkeit erinnert sich an den 30. November 2022. OpenAI veröffentlichte ChatGPT als dialogorientierte Forschungsvorschau. Erfunden wurden an diesem Tag weder Transformer noch neuronale Netze noch Sprachmodelle. Es war eine Oberfläche, ein Trainingsrezept, ein Entscheid über die Verbreitung und ein kultureller Moment, der eine bisher spezialisierte Klasse von Systemen ungewöhnlich leicht befragbar machte.34
Forschung zu menschlichem Feedback und zum Befolgen von Anweisungen half, aus reiner Textvorhersage Modelle zu machen, die sich öfter wie Assistenten verhielten. Besonders wichtig ist hier die Arbeit zu InstructGPT von 2022. Menschliche Präferenzen konnten das Verhalten der Modelle formen, doch eine Optimierung auf Präferenzen verleiht nicht automatisch Wahrhaftigkeit, Fachkompetenz oder eine Verpflichtung gegenüber den tatsächlichen Interessen der Nutzer.35
GPT-4, im März 2023 vorgestellt, erweiterte die öffentliche Vorstellung davon, was ein Modell über Aufgaben und Eingabearten hinweg leisten kann, auch wenn der Entwickler selbst Schwächen dokumentierte, darunter selbstsicher falsche Antworten. Andere Gruppen machten Modellgewichte breiter zugänglich und stellten in Frage, wie zentralisiert diese Fähigkeiten bleiben würden. Zugang zu Gewichten ist allerdings nicht dasselbe wie voller Zugang zu Trainingsdaten, Rechenleistung, Dokumentation oder den Mitteln, das System unabhängig nachzubauen.3637
Die Oberfläche war wichtig, weil sie veränderte, wer etwas übernimmt. Frühere Systeme brauchten oft ein Forschungsteam oder eine eigene Anwendung. Ein Chatbot lud fast alle ein, durch blosses Tippen tausende mögliche Verwendungen auszuprobieren. Zum ersten Mal begegneten viele Menschen der KI nicht als enger Produktfunktion, sondern als Gesprächspartner für fast alles.
Das machte die Technik oberflächlich leichter verständlich und viel schwerer, sie gründlich zu beurteilen.
Wir erlebten ein bemerkenswertes Paradox: Je flüssiger die Systeme wurden, desto mehr Arbeit mussten die Nutzer leisten, um Beredsamkeit von Belegen zu unterscheiden, Vollständigkeit von Richtigkeit und hilfreiche Vorschläge von befugten Entscheidungen.
11 · Was die Benchmark-Kurven aus der KI-Geschichte weglassen
Fortschritt, gemessen an Genauigkeit und Tempo, ist echt. Aber er ist nicht die ganze Geschichte.
2018 dokumentierten Joy Buolamwini und Timnit Gebru erhebliche Unterschiede in den Fehlerraten kommerzieller Systeme zur Geschlechtsklassifikation. Ihre Studie Gender Shades erinnert daran, dass eine gute Durchschnittsleistung verdecken kann, wer die Fehler trägt. Die Befunde galten für die untersuchten Systeme, Datensätze und Aufgaben; man sollte sie nicht als allgemeine Fehlerraten auf jedes spätere Modell übertragen.38
2021 warnte der Aufsatz Stochastic Parrots von Emily Bender, Timnit Gebru, Angelina McMillan-Major und Shmargaret Shmitchell vor Risiken rund um die Grösse der Trainingsdaten, Umweltkosten, Undurchsichtigkeit und gesellschaftliche Schäden. Manche seiner Thesen darüber, was Sprachmodelle verstehen können, sind weiterhin umstritten. Seine historische Bedeutung hängt nicht davon ab, eine Seite dieser philosophischen Debatte für entschieden zu halten.39
Trainingsdaten werden gesammelt, lizenziert, gefiltert, annotiert und manchmal angefochten. Hinter Datensätzen stehen Urheber, Arbeitskräfte, Sprachen, Institutionen und ungleiche Verhandlungsmacht. Hinter dem industriellen Einsatz stehen Infrastruktur, Strom, Kühlung, Staatspolitik und Marktkonzentration. Hinter einem System, das als autonom vorgestellt wird, stehen oft menschliche Bewertungen, Sicherheitseingriffe, Werkzeugberechtigungen und Leute, die die Ausnahmen behandeln.
2024 trat die KI-Verordnung der Europäischen Union in Kraft, ein risikobasierter Rechtsrahmen, dessen Bestimmungen stufenweise gelten. In den Vereinigten Staaten bot das AI Risk Management Framework des NIST eine freiwillige Struktur für die Steuerung von Risiken. Das sind verschiedene Instrumente. Keines beendet den Streit. Dass es sie gibt, ist selbst eine historische Wende: Ob KI funktioniert, ist nicht mehr die einzige Frage. Es geht auch darum, was die Gesellschaft ihr erlaubt, wer ein Ergebnis anfechten kann und wer es korrigieren muss.4041
Hier wird die Geschichte der künstlichen Intelligenz zu einer Geschichte der Institutionen. Die Frage «Können wir es automatisieren?» bekommt eine notwendige Begleiterin: «In wessen Auftrag, mit wessen Daten, mit wessen Recht, nein zu sagen?»
12 · 2024–2026: mehr Schliessen, mehr Handeln, mehr Angriffsfläche
Ab 2024 betonten KI-Entwickler zunehmend Modelle, die darauf trainiert sind, für schwierige Aufgaben mehr Rechenzeit aufzuwenden, und Systeme, die Werkzeuge aufrufen und mehrstufige Arbeit erledigen können. OpenAI stellte seine o1-Modelle für das Schliessen im September 2024 vor. DeepSeek-R1, 2025 veröffentlicht, zeigte, wie schnell sich auf das Schliessen ausgerichtete Methoden über Labore und Landesgrenzen hinweg verbreiten. Die Etiketten Reasoning und Agent sind nützliche Produktbezeichnungen, keine anerkannten philosophischen Urteile über Geist oder Absicht.4243
Der gemessene Fortschritt ist beträchtlich. Laut dem AI Index 2026 der Universität Stanford stieg die Erfolgsquote führender Agenten im Computer-Benchmark OSWorld im Laufe von 2025 von rund 12% auf 66,3%. Derselbe Bericht hält fest, dass Roboter nur 12% realer Aufgaben im Haushalt bewältigten, obwohl sie in simulierten Umgebungen viel besser abschnitten. Verschiedene Benchmarks, Aufgaben, Daten und Versuchsanordnungen darf man nicht zu einer einzigen Zahl namens Intelligenz verschmelzen.44
Nach demselben Bericht stammten 2025 über 90% der bedeutenden Spitzenmodelle aus der Industrie, und die AI Incident Database verzeichnete für dieses Jahr 362 dokumentierte KI-Vorfälle, nach 233 im Jahr 2024. Die Zahl der Vorfälle spiegelt Meldeverhalten und Dokumentation ebenso wie die Ereignisse selbst; sie ist keine vollständige Erhebung aller Schäden durch KI. Aber sie zeigt, wie sich Fähigkeit, Konzentration und Angriffsfläche heute gemeinsam entwickeln.4546
Das heisst nicht, dass autonome Systeme nie funktionieren. Es heisst, dass man agentische Leistung im Detail beurteilen muss: nach Aufgabe, Umgebung, erteilter Befugnis, Korrigierbarkeit von Fehlern und Häufigkeit menschlicher Eingriffe. Eine Benchmark-Episode zu bestehen ist nicht dasselbe, wie die Lohnbuchhaltung einer Firma zu führen, Patientendaten zu bearbeiten oder ohne Aufsicht etwas in den produktiven Betrieb zu bringen.
Die Forscher von 1955 wollten Maschinen, die Sprache verwenden und sich selbst verbessern. 2026 ist dieser Ehrgeiz nicht mehr bloss Rhetorik. Aber die praktischen Fragen, die ihr Antrag beiseitelassen konnte, Kosten, Eigentum, Daten, Sicherheit, Souveränität, Umweltbedarf, Wiederherstellung und Verantwortlichkeit, sind heute untrennbar mit der Technik verbunden.
13 · Sieben Dinge, die uns diese Geschichte immer wieder sagt
1. Die Vorführung ist nicht der Einsatz. Die Übersetzungsschau von Georgetown, ELIZAs flüssiger Dialog, frühe fahrende Roboter, Siege in Quizshows und die Agenten-Benchmarks von heute lehren alle dieselbe Unterscheidung. Leistung in einer gebauten Umgebung lässt sich nicht stillschweigend auf die unkontrollierte Welt übertragen.
2. Das Lernen kam nicht nach dem Schliessen. Symbolische Methoden, neuronale Methoden, Statistik, Rückkopplung und Suche sind seit Jahrzehnten verflochten. Die Geschichte ist keine geordnete Abfolge sich ausschliessender Glaubensrichtungen.
3. Der Benchmark ist nicht der Geist. Schachkönnen, Bildklassifikation, Übersetzungsqualität, Benchmark-Mathematik und erledigte Computeraufgaben sind bedeutende Leistungen. Keine davon beweist für sich menschenähnliches Verstehen, Bewusstsein, Urteilskraft oder moralische Handlungsfähigkeit.
4. Die menschliche Arbeit wandert. Auf Regeln folgten Daten, auf Datensätze das Vortraining im grossen Stil, auf statische Ausgaben Agenten mit Werkzeugen. Auf jeder Stufe legten Menschen Ziele fest, wählten Belege aus, gaben Rückmeldungen, stellten Infrastruktur bereit und trugen die Verantwortung, wenn das System versagte.
5. Die Wirtschaft entscheidet, welche Erfindungen Geschichte werden. Schnellere Rechner, billigerer Speicher, Datensätze, die Übernahme durch Organisationen und das Geld von Investoren können eine alte Technik zum prägenden Durchbruch eines neuen Jahrzehnts machen. Eine Geschichte, die nur als Folge wissenschaftlicher Aufsätze erzählt wird, verdeckt das.
6. Ein Winter ist ein Urteil über Versprechen, nicht das Fehlen von Fortschritt. Wichtige Arbeit ging weiter, während Geld und Aufmerksamkeit abwanderten. Dass eine Schlagzeile verschwindet, beweist nicht, dass die Forschung dahinter gescheitert ist.
7. Fähigkeit und Befugnis sind zweierlei. Wer eine richtige Antwort geben kann, hat damit nicht das Recht, auf einen Datensatz zuzugreifen, sich als Fachperson auszugeben, das Geld anderer auszugeben oder zu handeln, ohne dass es einen Weg gibt, das anzufechten und zu reparieren.
14 · Die Frage, die wir von Anfang an hätten stellen sollen
Es gibt eine verlockende Art, diese Geschichte zu beenden. Man reiht Meilenstein an Meilenstein, legt eine Kurve mit wachsender Rechenleistung darüber und folgert, dass die Maschinen sich ihrem unvermeidlichen Ziel nähern.
Aber eine Zeitleiste kann eine schlechte Erklärung sein. Sie bringt Durchbrüche in eine Reihe und lässt den Weg geplant aussehen. Die Geschichte war nicht geplant. Forschende setzten auf konkurrierende Theorien. Kommerzielle Produkte hatten aus Gründen Erfolg, die keine Philosophie vorhergesagt hatte. Fördergeld verschwand und kehrte zurück. Ein Algorithmus konnte zwanzig Jahre lang übersehen werden und dann plötzlich die Hardware und die Daten finden, die er brauchte. Ein Spielzeug von Dialogsystem konnte mehr über menschliches Vertrauen verraten als eine weit kompliziertere wissenschaftliche Leistung.
Ada Lovelace warnte, dass neue Maschinen uns zuerst verleiten, ihre Kräfte zu überschätzen, und dann, aus Enttäuschung, zu unterschätzen, was sie wirklich leisten können.3 Fast zwei Jahrhunderte künstliche Intelligenz haben diesen Rhythmus nicht abgeschafft.
Die heutigen Systeme können Dinge, die die Organisatoren von Dartmouth verblüfft hätten. Das zählt. Der Fortschritt ist keine Täuschung. Er ist aber auch kein Freipass für die Annahme, das nächste System werde können, was das letzte nicht konnte, oder flüssige Antworten bedeuteten verlässliches Handeln.
Vielleicht handelt die Geschichte der KI darum nicht in erster Linie von dem Moment, in dem Maschinen intelligent werden. Sie handelt von dem immer wiederkehrenden Moment, in dem Menschen entscheiden, welche Fähigkeiten sie Intelligenz nennen, und davon, was geschieht, wenn diese Fähigkeiten das Labor verlassen.
Jede Generation hat versucht, die Frage mit einer neuen Vorführung zu klären.
Die folgenreichere Frage kommt danach.
Wer versteht die Maschine gut genug, um sie zu steuern, wer kann ihr widersprechen, wenn sie sich irrt, und wer kann sie noch abschalten?
Diese Frage wartete schon 1843. Sie wartet 2026 wieder.
Die historische Spur: ausgewählte Meilensteine
| Jahr | Meilenstein | Was sich änderte und was nicht |
|---|---|---|
| 1843 | Lovelaces Anmerkungen zu Babbages nie gebauter Analytical Engine | Programmierbare Symbolmaschine gedacht; noch keine funktionierende KI |
| 1936 | Turings Aufsatz zur Berechenbarkeit | Formale Grenzen und Möglichkeiten mechanischen Rechnens |
| 1943 | Neuronenmodell von McCulloch und Pitts | Mathematische Verbindung von Netzen, Neuronen und Logik |
| 1948 | Wieners Cybernetics | Rückkopplung und Steuerung als Rahmen für Lebewesen und Maschinen |
| 1950 | Turings Imitationsspiel | Ein Test für intelligent wirkendes Verhalten, nicht für Bewusstsein |
| 1954 | Übersetzungsvorführung von Georgetown und IBM | Eine funktionierende, stark eingeschränkte Sprachschau |
| 1955 / 1956 | Antrag von Dartmouth / Sommerprojekt | Ein Fach erhält seinen Namen, keine gemeinsame Theorie |
| 1958 / 1959 | Rosenblatts Perzeptron / Samuels Damespiel | Lernende Systeme neben symbolischer Arbeit |
| 1966 | ELIZA und der ALPAC-Bericht | Überzeugender Dialog neben institutioneller Skepsis |
| 1966–1972 | Roboterprojekt Shakey | Planen, Wahrnehmen und Bewegen im Verbund, unter Einschränkungen |
| 1973 | Lighthills Kritik und öffentliche Debatte | Hohe Erwartungen treffen auf strenge Prüfung |
| 1980er | Expertensysteme; Japans Fünfte Generation | Echter Nutzen für Spezialaufgaben; Grenzen bei Wartung und Allgemeinheit |
| 1986 / 1989 | Aufsatz zur Backpropagation / Handschrifterkennung | Lernende Darstellungen werden nachweislich nützlich |
| 1997 | Deep Blue gewinnt das Match gegen Kasparow | Überlegenheit der Maschine in einem klar umrissenen Spiel, kein allgemeines Denken |
| 2009 | Datensatz ImageNet vorgestellt | Grosse beschriftete Bildsammlungen tragen wiederholbare Benchmarks |
| 2011 | IBM Watson gewinnt Jeopardy! | Ausgefeiltes Beantworten von Fragen in engem Rahmen |
| 2012 | AlexNet verändert die Ergebnisse bei ImageNet | Grafikprozessoren und tiefe neuronale Netze entscheiden die Bilderkennung |
| 2016 | AlphaGo besiegt Lee Sedol | Deep Learning, verstärkt durch Suche und Spiel gegen sich selbst |
| 2017 | Transformer veröffentlicht | Modelle mit Aufmerksamkeit prägen die Sprach-KI neu |
| 2018–2020 | BERT, GPT-3 und Skalierungsstudien | Breites Vortraining und Übertragung über Aufgaben hinweg |
| 2021 / 2022 | Aufsatz zu AlphaFold 2 / Vorhersagen im grossen Stil freigegeben | Grosser Nutzen für die Wissenschaft; Vorhersagen bleiben Vorhersagen |
| 2022 | Diffusionssysteme, InstructGPT, ChatGPT | Generative Fähigkeiten werden der Öffentlichkeit zugänglich |
| 2023 | GPT-4; Forschungsmodell LLaMA | Multimodale Fähigkeiten und konkurrierende Zugangsstrategien |
| 2024 | EU-KI-Verordnung in Kraft; Fokus auf Reasoning-Modelle | Regulierung und Rechenaufwand bei der Anwendung rücken in den Vordergrund |
| 2025–2026 | Wettbewerb der Reasoning-Modelle; Agenten mit Werkzeugen | Bessere Leistung bei echten Aufgaben, anhaltende Lücken bei der Verlässlichkeit |
Methode und redaktionelle Anmerkung
Dieser Band ist eine historische Synthese, keine abschliessende Geschichte jedes Teilgebiets der KI. Die Daten stützen sich wo immer möglich auf Originalaufsätze, amtliche Archive und Unterlagen der Institutionen. Der Essay unterscheidet zwischen einem Forschungsaufsatz, einer öffentlichen Vorführung, einem kommerziellen Einsatz und einem späteren Rückblick. Seine wertenden Aussagen, besonders zu Hype, Vertrauen und den Grenzen von Benchmarks, sind redaktionelle Deutungen, die auf diesen Quellen beruhen, aber nicht von ihnen selbst behauptet werden. Umstrittene Punkte sind im Text als solche bezeichnet: die Ansprüche auf das erste Programm rund um Lovelace, die Urheberschaft der Backpropagation, Ursachen und Reichweite der KI-Winter und die Übertragung vom Benchmark auf die Welt.
Die Meilensteine lassen wichtige Beiträge von Einzelnen, Regionen und Disziplinen weg, darunter die sowjetische Kybernetik und viel Forschung aus Kontinentaleuropa, Kanada und China. Die Auswahl soll begriffliche Wendepunkte erklären, nicht ausschliessliche Verdienste zuteilen. Alle Beobachtungen zu Technik und Politik geben den Stand der Recherche vom 20. Oktober 2026 wieder. Die Quellen unten nennen zu jedem Eintrag, welche Art von Beleg er ist und was er nicht zeigt.
Quellen
Footnotes
-
McCarthy, Minsky, Rochester and Shannon, Dartmouth AI summer project proposal (1955). www-formal.stanford.edu; ergänzende Quelle: doi.org. Originalantrag (Archiv Stanford; neu abgedruckt im AI Magazine). Datiert 31. August 1955. Ein Antrag ist nicht das Ergebnis des Workshops von 1956. ↩ ↩2
-
Dartmouth project fiftieth-anniversary retrospective (2006 on 1956). doi.org. Rückblick von Beteiligten, 2006. Zeugnis aus fünfzig Jahren Abstand; mit dem Antrag abgeglichen. ↩ ↩2
-
Ada Lovelace, Notes to Sketch of the Analytical Engine (1843). psychclassics.yorku.ca; ergänzende Quelle: www.hsm.ox.ac.uk. Historische Primärquelle. Die Maschine wurde nie wie geplant gebaut; Etiketten wie «erstes Programm» oder «Vorläuferin der KI» sind umstritten. ↩ ↩2
-
Alan M. Turing, Computing Machinery and Intelligence (1950). academic.oup.com. Originalarbeit. Ein Verhaltenstest, kein validierter Test für Bewusstsein. ↩ ↩2
-
Alan M. Turing, On Computable Numbers (1936/1937). doi.org. Mathematische Originalarbeit. 1936 eingereicht; der Verlag datiert den Band auf 1937. ↩
-
Warren McCulloch and Walter Pitts, A Logical Calculus of the Ideas Immanent in Nervous Activity (1943). doi.org. Originalarbeit. Stilisierte mathematische Neuronen, keine heutigen trainierbaren Architekturen. ↩
-
Norbert Wiener, Cybernetics (1948). direct.mit.edu. Originalmonografie. Erstausgabe 1948; die Online-Ausgabe ist ein moderner Nachdruck. ↩
-
Georgetown–IBM machine translation demonstration (1954). aclanthology.org; ergänzende Quelle: www.ibm.com. Fachhistorische Studie; IBM-Archiv. Eine eng begrenzte Vorführung, keine allgemeine Übersetzung. ↩
-
Frank Rosenblatt’s perceptron (1958). news.cornell.edu. Rückblick der Universität. Mit dem Wissen von heute geschrieben. ↩
-
Arthur Samuel, Some Studies in Machine Learning Using the Game of Checkers (1959). doi.org. Originalarbeit von IBM. Kein Anspruch auf das «erste» lernende System überhaupt. ↩
-
Joseph Weizenbaum, ELIZA—A Computer Program for the Study of Natural Language Communication Between Man and Machine (1966). doi.org. Originalarbeit. Regelbasiert; ELIZA funktioniert technisch anders als heutige Sprachmodelle. ↩
-
ALPAC, Language and Machines: Computers in Translation and Linguistics (1966). www.nationalacademies.org; ergänzende Quelle: www.nationalacademies.org. Originalbericht des US National Research Council. Die Wirkung war je nach Geldgeber, Sprache und Land verschieden. ↩
-
SRI, Shakey the Robot (1966–1972). www.sri.com; ergänzende Quelle: www.darpa.mil. Forschungsrückblick; Archive der Institutionen. Kontrollierte Umgebung; Institutionen betonen gern ihre Pionierleistungen. ↩
-
Minsky and Papert, Perceptrons, and reassessments of AI winter (1969). www.open.edu; ergänzende Quelle: ai100.stanford.edu. Historische Übersichten. Vermeidet die Erzählung, ein einziges Buch habe die Forschung an neuronalen Netzen gestoppt. ↩
-
Lighthill debate/report at University of Edinburgh (1973). www.aiai.ed.ac.uk. Archiv von Bericht und Debatte (Universität Edinburgh). Bericht 1972 verfasst, 1973 veröffentlicht und debattiert; kein weltweiter Stopp der KI. ↩
-
DENDRAL, MYCIN and XCON expert-system era (1960s–1980s). doi.org; ergänzende Quelle: ai100.stanford.edu. XCON-Fallstudie; historische Übersicht. Eng begrenzte, gepflegte Anwendungen; früher Erfolg hiess nicht breite Intelligenz. ↩
-
Japanese Fifth Generation Computer Systems project (1982–1992). museum.ipsj.or.jp. Computermuseum der japanischen Informatikgesellschaft. Verfehlte kommerzielle Ziele heissen nicht, dass es keinen wissenschaftlichen Beitrag gab. ↩
-
Karen Spärck Jones, A Statistical Interpretation of Term Specificity (1972). doi.org. Originalarbeit zur Informationssuche. Ein einflussreicher Vorläufer, nicht der einzige Ursprung der statistischen Sprachverarbeitung. ↩
-
Speech Recognition with Continuous-Parameter Hidden Markov Models (1987). research.ibm.com. Forschungspublikation von IBM. Ein Forschungsstrang, keine vollständige Darstellung der statistischen KI. ↩
-
Rumelhart, Hinton and Williams, Learning Representations by Back-Propagating Errors (1986). doi.org. Originalarbeit. Nicht die erste Formulierung der Backpropagation. ↩
-
LeCun et al., Backpropagation Applied to Handwritten Zip Code Recognition (1989). direct.mit.edu. Originalarbeit. Eine eng begrenzte Aufgabe; der spätere kommerzielle Einsatz ging weiter. ↩
-
IBM, Deep Blue (1997). www.ibm.com. Geschichtsarchiv von IBM. Unternehmensquelle; nicht der erste Schachsieg eines Computers über einen Menschen. ↩
-
IBM, Watson and Jeopardy! (2011). www.ibm.com. Geschichtsarchiv von IBM. Eine eigens konstruierte Wettbewerbssituation, kein allgemeines Denken. ↩
-
Deng et al., ImageNet: A Large-Scale Hierarchical Image Database (2009). collaborate.princeton.edu. Original-Konferenzbeitrag. Der Umfang von 2009 unterscheidet sich von späteren ImageNet-Erweiterungen. ↩
-
Krizhevsky, Sutskever and Hinton, ImageNet Classification with Deep Convolutional Neural Networks (2012). papers.nips.cc. Original-Konferenzbeitrag. Benchmark-Ergebnisse hängen von Testdaten, Metrik und Jahr ab. ↩
-
DeepMind, AlphaGo versus Lee Sedol (2016). deepmind.google. Rückblick des Entwicklers. Quelle des Entwicklers; Aussagen nur zum Match. ↩
-
Vaswani et al., Attention Is All You Need (2017). arxiv.org. Originalarbeit. Erschienen 2017; spätere Anwendungen waren nicht vorbestimmt. ↩
-
Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding (2018/2019). aclanthology.org. Original-Konferenzbeitrag. Preprint 2018, Tagungsband 2019. ↩
-
Brown et al., Language Models Are Few-Shot Learners (GPT-3) (2020). arxiv.org. Originalarbeit. Abhängig von Prompts und Auswertung; kein Beleg für Wahrhaftigkeit. ↩
-
Kaplan et al., Scaling Laws for Neural Language Models (2020). arxiv.org. Original-Preprint. Empirische Anpassungen für einen bestimmten Bereich, keine Naturgesetze. ↩
-
Hoffmann et al., compute-optimal language-model training (Chinchilla) (2022). deepmind.google. Forschungszusammenfassung des Entwicklers. Quelle des Entwicklers; keine einzelne Parameterzahl bestimmt den Nutzen. ↩
-
Jumper et al., highly accurate protein structure prediction with AlphaFold; EMBL-EBI database expansion (2021/2022). www.nature.com; ergänzende Quelle: www.ebi.ac.uk. Originalarbeit; Datenbankfreigabe EMBL-EBI. Berechnete Vorhersagen sind keine experimentell bestimmten Strukturen. ↩
-
Rombach et al., High-Resolution Image Synthesis with Latent Diffusion Models (2022). openaccess.thecvf.com. Original-Konferenzbeitrag. Nicht gleichbedeutend mit allen Bildgeneratoren. ↩
-
OpenAI, Introducing ChatGPT (30 November) (2022). openai.com. Ankündigung des Anbieters. Quelle des Anbieters; belegt den Zeitpunkt, nicht die unabhängige Wirkung. ↩
-
Ouyang et al., Training Language Models to Follow Instructions with Human Feedback (2022). arxiv.org. Originalarbeit. Optimierung auf menschliche Präferenzen garantiert keine sachliche Richtigkeit. ↩
-
OpenAI, GPT-4 Research (2023). openai.com. Bericht des Entwicklers. Selbstauskunft. ↩
-
Meta AI, Introducing LLaMA (2023). ai.meta.com. Ankündigung des Entwicklers. Offene Gewichte sind kein offener Trainingsprozess und keine offenen Daten. ↩
-
Buolamwini and Gebru, Gender Shades (2018). proceedings.mlr.press. Begutachtete Arbeit. Die Unterschiede gelten für die untersuchten Systeme und den Zeitraum. ↩
-
Bender et al., On the Dangers of Stochastic Parrots (2021). doi.org. Begutachtete Arbeit. Die philosophischen Thesen sind umstritten; zitiert, nicht als Tatsache gesetzt. ↩
-
European Commission, AI Act Enters into Force (2024). commission.europa.eu. Mitteilung der Europäischen Kommission. In Kraft seit 1. August 2024; die Pflichten gelten gestaffelt, Termine können sich ändern. ↩
-
NIST, AI Risk Management Framework 1.0 (2023). www.nist.gov. Ressource der US-Normenbehörde. Ein freiwilliger Rahmen, keine Rechtspflicht und keine Zertifizierung. ↩
-
OpenAI, Learning to Reason with LLMs (2024). openai.com. Ankündigung des Entwicklers. «Reasoning» ist eine Produktbezeichnung, kein Beleg für Denken. ↩
-
DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning (2025). arxiv.org; ergänzende Quelle: www.nature.com. Preprint, später begutachtet in Nature. Die gemeldeten Benchmarks spiegeln Trainingsaufbau und Datum. ↩
-
Stanford HAI, AI Index: Technical Performance (2026). hai.stanford.edu. Jährlicher Forschungsindex, Technikkapitel. Zahlen gelten je Benchmark; Testsätze und Vergleichswerte ändern sich. ↩
-
Stanford HAI, 2026 AI Index: Top Takeaways (2026). hai.stanford.edu. Jährlicher Forschungsindex, Zusammenfassung. Die Definitionen von «Industrie» und «bedeutendem Modell» prägen den Anteil. ↩
-
Stanford HAI, AI Index: Responsible AI (2026). hai.stanford.edu. Jährlicher Forschungsindex, Kapitel verantwortungsvolle KI. Die Zahlen der AI Incident Database hängen von Meldungen und Aufnahmeregeln ab. ↩