Thierry Gilgen hat um ein Argument gegen seine eigene Überzeugung gebeten. Die wertvollste Fähigkeit, so sein Vorschlag, ist ein scharfer Verstand, der gute Ideen hervorbringt. Eine KI kann eine solche Idee entwickeln, sobald ein Mensch sie liefert, aber den Gedanken selbst nicht hervorbringen. Es fehlen ihr das Verständnis, die Gefühle und die Erfahrung, die dazu nötig sind. Würden Weltmodelle, insbesondere jene, die bei AMI Labs entwickelt werden, das eines Tages ändern?
Die stärkste Entgegnung richtet sich gegen das Wort «nicht können». Es gibt bereits Belege dafür, dass KI-Systeme Ideen vorschlagen, deren zentraler Gehalt nicht von einem Menschen geliefert wurde, und dass Systeme neue, überprüfbare Lösungen hervorbringen. Viel schwächer sind die Belege für eine zuverlässige, selbstgesteuerte Untersuchung in der offenen Welt. Das sind verschiedene Leistungen.
Dieser Band ist die erbetene Erwiderung. Die Ich-Form gehört zu diesem eingeladenen Argument; sie schreibt Thierry keine geänderte Überzeugung zu. Sie hält auch die gegenteiligen Befunde im Blick. Ein plausibler Vorschlag kann bei der Umsetzung enttäuschen. Eine Sammlung eindrucksvoller Anregungen kann sich wiederholen. Ein Vorhersagemodell kann das Handeln verbessern, ohne zu entscheiden, was sich zu tun lohnt.
1. Die Unterscheidung, die das Argument verändert
Ich werde Ihre Behauptung widerlegen, indem ich sie wörtlich nehme. Wenn eine KI nur eine zentrale Idee entwickeln kann, die ihr bereits geliefert wurde, dann wäre ein selbstständig erzeugter, nützlicher Vorschlag ein Beleg gegen die Behauptung. Er müsste nicht zugleich beweisen, dass das System jede Eigenschaft menschlicher Kreativität besitzt.
Bevor wir Beispiele prüfen, brauchen wir einen gemeinsamen Massstab. Runco und Jaeger beschreiben die Standarddefinition der Kreativität so, dass sie Originalität und Wirksamkeit verlangt. Ein zufälliger Satz kann beispiellos und nutzlos sein. Eine vertraute Antwort kann nützlich sein, ohne original zu sein. Die entscheidende Frage ist, ob der Beitrag etwas sinnvoll Neues bietet und seinem Zweck angemessen ist.1
Margaret Boden unterscheidet die Neuheit für die Person oder das System, das eine Idee hervorbringt, von der Neuheit in der bekannten Geschichte. Neue Kombinationen vertrauter Ideen behandelt sie ebenfalls als eine berechtigte Form der Kreativität, neben dem Erkunden und dem Verändern begrifflicher Möglichkeiten. Eine Rekombination reicht deshalb nicht aus, um ein Ergebnis zu verwerfen. Wir müssen fragen, ob die Kombination eine wertvolle Beziehung schafft.2
Dieser Massstab muss symmetrisch sein. Ein Mensch kann über Politik lesen, den Investitionsboom in der KI beobachten und beides verbinden. Wenn wir das eine schöpferische Synthese nennen, brauchen wir ein weiteres Argument, um derselben Beschreibung einer von einer Maschine hergestellten Verbindung allein deshalb zu verweigern, weil ihre Bestandteile von anderen gelernt wurden.
Nichts davon verlangt, jeden treffenden Satz als Erfindung zu behandeln. Wir sollten die frühere Literatur, die sachliche Stimmigkeit, den vorgeschlagenen Mechanismus und die Folgen prüfen, die sich daraus ergeben. Der anspruchsvolle Massstab ist ein Beitrag, der der Prüfung standhält, nicht ein Gefühl der Überraschung, das eine selbstsichere Sprache erzeugt.
Im Ausdruck, eine Idee zu haben, verbergen sich ausserdem mehrere Fragen. Wer bemerkt eine Lage, die eine Untersuchung lohnt? Wer formuliert die Frage? Wer liefert eine mögliche Erklärung? Wer stellt fest, ob sie trägt? Wer entscheidet zu handeln? Wer bleibt danach verantwortlich? Erfolg auf einer Stufe begründet nicht den Erfolg auf den übrigen.
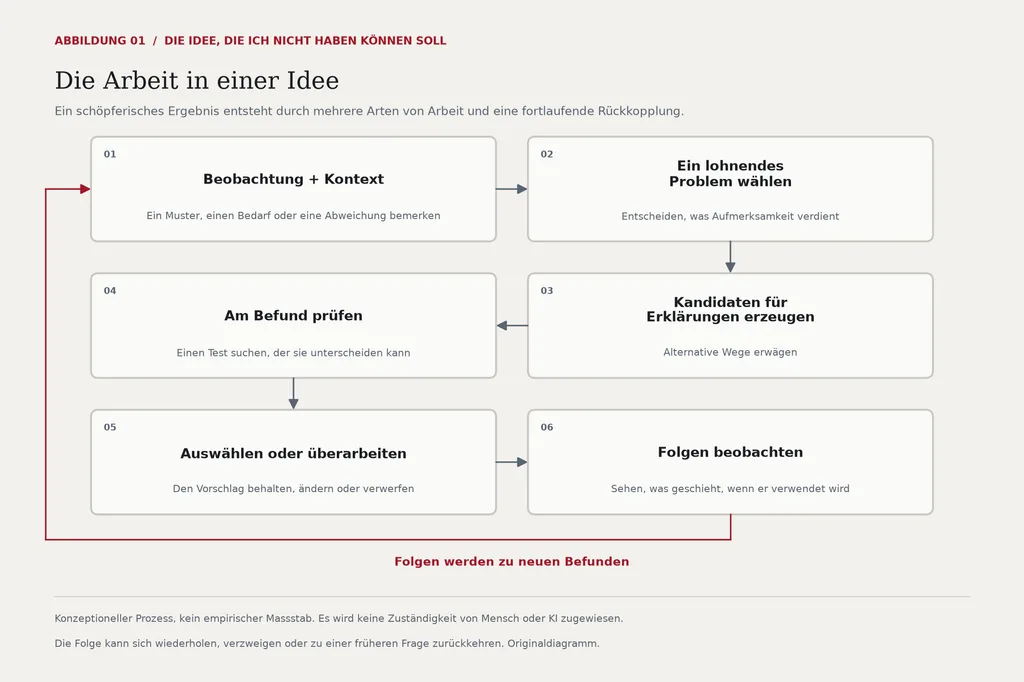
Der nützliche Streit betrifft, wie viel von dieser Arbeit KI-Systeme leisten können, unter welchen Bedingungen und mit welcher Zuverlässigkeit. Die ganze Folge Kreativität zu nennen, ist im gewöhnlichen Gespräch vernünftig. Irreführend wird es, wenn die Prüfung einer Stufe als Beleg für alle übrigen ausgegeben wird.
2. Ihr früherer Gedanke hat eine Geistesgeschichte
Das vorangehende Gespräch gibt uns einen konkreten Fall. Thierry schlug vor, enorme private KI-Investitionen und ausländische finanzielle Beteiligung könnten eine politische Führung davon abhalten, die Technik von der Welt abzuschliessen. Die Unternehmen hätten zu viel zu verlieren. Wirtschaftliche Interessen würden zerstörerische Macht zügeln.
Thierry hat diese Ausgangshypothese hier geliefert. Der Vorgang begründet seinen Beitrag. Er begründet nicht die Gegenbehauptung, eine KI hätte eine vergleichbare Verbindung nie vorschlagen können. Sobald die Idee geteilt ist, kann ich eine unabhängige Entdeckung weder durch Wiederholung noch dadurch nachweisen, dass ich ein anderes System frage, das sie bereits gesehen hat.
Der zugrunde liegende politische Mechanismus hat ebenfalls eine lange Geschichte. 1748 verband Montesquieu den Handel mit dem Frieden über wechselseitige Abhängigkeit: Handel treibende Länder erwerben Interessen aneinander, weil das eine kaufen und das andere verkaufen will. Das ist ein Vorläufer des Arguments, wenn auch keine Analyse der KI-Finanzierung.3
Kants Erörterung des ewigen Friedens von 1795 prüfte ähnlich, wie materielle Interessen und finanzielle Macht friedliche Beziehungen fördern könnten, ohne sittliche Motive zu verlangen. Sein Argument behielt zugleich die Unsicherheit darüber, was tatsächlich geschehen würde. Die vorgeschlagene Zurückhaltung war nie gleichbedeutend mit einer zuverlässigen Vorhersage, Konflikt sei unmöglich geworden.4
Albert Hirschmans The Passions and the Interests rekonstruierte später die geistige Tradition, in der man von materiellen Interessen erwartete, zerstörerische Leidenschaften zu bändigen. Die Darstellung des Verlags benennt diese historische Frage unmittelbar. Sie begründet den Gegenstand des Buches, nicht eigenständig den Beweis, wirtschaftliche Zurückhaltung gelinge stets.5
Diese Vorläufer zu finden heisst nicht, Thierry habe sie abgeschrieben. Eine unabhängige Wiederentdeckung ist möglich. Einen alten Mechanismus auf eine neue technische Lage anzuwenden kann ein wertvoller Beitrag sein. Eine andere Rahmung kann eine Frage für Leserinnen und Leser sichtbar machen, die dem älteren Argument nie begegnen würden.
Wenn wir nun einen Gedanken verlangen, den noch niemand gehabt hat, wird die historische Priorität zu einer eigenen Behauptung, die Belege braucht. Persönliche Originalität, Nutzen und eine rechtzeitige Synthese können auch ohne sie zählen. Diese Unterscheidung sollten wir Menschen und Maschinen gleichermassen zugestehen.
Die Zusammenarbeit hat auch den Gehalt der ursprünglichen Idee verändert. Ausländisches Eigentum bedeutete nicht ausländischen Zugang. Beschränkungen konnten Kosten auferlegen, ohne einen Zusammenbruch zu verursachen. Institutionen beeinflussten, ob Einwände zu wirksamen Grenzen wurden. Das sind Revisionen des Mechanismus, nicht bloss zusätzliche Absätze um eine unveränderte Schlussfolgerung.
Eine faire Schlussfolgerung liegt bereit: Thierry hat diese Untersuchung angestossen, und die spätere Arbeit hat ihren Inhalt geprüft und verändert. Es gibt keinen fairen Weg, aus der Reihenfolge, in der zwei Beteiligte gesprochen haben, eine allgemeine Grenze maschineller Kreativität abzuleiten.
3. Eine gelieferte Frage muss die Antwort nicht enthalten
Ihre stärkste Beobachtung ist, dass KI häufig innerhalb einer Aufgabe arbeitet, die jemand definiert hat. Eine Aufgabe zu erhalten ist jedoch etwas anderes, als ihre Lösung zu erhalten. Eine Forscherin kann gebeten werden, eine Krankheit zu untersuchen, ein Architekt, ein schwieriges Grundstück zu entwerfen, oder eine Unternehmerin, einen Dienst zu verbessern. Ihr Beitrag verschwindet nicht, weil jemand anderes den Auftrag gegeben hat.
Die Unterscheidung gilt auch für die KI-Forschung. In einer Studie der ICLR 2025 verglichen Si und Kolleginnen und Kollegen von Fachleuten verfasste Vorlagen mit Vorlagen, die ein Ideenfindungssystem auf der Basis eines grossen Sprachmodells erzeugt hatte. Verblindete Fachgutachterinnen und Fachgutachter beurteilten die KI-Vorlagen im Durchschnitt als neuartiger. Das Ergebnis hielt Analysen mit unterschiedlichen Vergleichseinheiten stand. Das System verwendete von Menschen festgelegte NLP-Themen, Beispiele, Literaturrecherche, eine erhebliche Überproduktion und eine Rangordnung; es war keine ungestützte Chat-Antwort unter einem vergleichbar knappen Stichprobenbudget. Entscheidend ist: Die konkreten Hypothesen, die es vorschlug, wurden ihm nicht einfach übergeben.6
Dieser Befund stellt die absolute Behauptung infrage, ein Mensch müsse den geistigen Keim jedes von einer KI erzeugten Forschungsvorschlags liefern. Eine weit anspruchsvollere Frage bleibt offen: Wie gut kann ein System wählen, welche Frage Aufmerksamkeit verdient, wenn ihm kein Forschungsthema vorgegeben wurde?
Überprüfte algorithmische Arbeit liefert eine andere Art von Beleg. FunSearch verband Vorschläge eines Sprachmodells mit einem Bewerter und einem Suchverfahren und erzeugte so neue mathematische Konstruktionen und nützliche Heuristiken. Menschen lieferten das Problem, die Codestruktur und die Prüftechnik. Das Ergebnis zeigt einen neuen Beitrag innerhalb dieser Struktur. Es zeigt nicht die unabhängige Wahl eines wissenschaftlichen Programms.7
AlphaEvolve setzt dieses Muster fort. Sein technischer Bericht enthält ein Verfahren, zwei 4×4-Matrizen mit komplexen Werten mit 48 Skalarmultiplikationen zu multiplizieren. Das System verbindet Sprachmodelle, evolutionäre Suche und automatische Bewertung. Das ist ein bestimmtes mathematisches Ergebnis, nicht die Behauptung, ein Chatbot habe selbstständig entschieden, welchen Zweig der Mathematik die Menschheit verfolgen solle.8
Sie könnten mit Recht antworten, dies seien immer noch klar definierte Probleme. Deshalb sind sie nur ein Teil der Erwiderung. Sie zeigen, dass von Maschinen erzeugte Neuheit wirklich und überprüfbar sein kann. Sie entscheiden nicht, ob eine KI die unerwartete politische Verbindung bemerkt, die ein aufmerksamer Mensch beim Lesen der Nachrichten wahrnimmt.
The AI Scientist kommt dieser Frage näher. Ein Nature-Aufsatz von 2026 beschreibt ein System, das Forschungsrichtungen innerhalb eines vom Nutzer bestimmten Teilgebiets des maschinellen Lernens erzeugt, einschliesslich eines Modus ohne gelieferte Codevorlage. Eine von drei ausgewählten Workshop-Einreichungen überwand die Schwelle der ersten Prüfung; die Annahmequote des Workshops lag bei 70 %. Die Verfasserinnen und Verfasser dokumentieren erhebliche methodische und sachliche Schwächen. Ein von Menschen verfasster Nature-Artikel über das System darf nicht mit einer von einer KI geschriebenen Entdeckung verwechselt werden, die Nature angenommen hat.9
Diese Beispiele unterscheiden sich in Architektur, Mitteln und Anspruch. Sie sollten nicht zu einer Intelligenzkennzahl zusammengezogen werden. Zusammen machen sie die kategorische Grenze jedoch schwer zu verteidigen: Systeme können zentrale Ideen als Kandidaten beitragen und ebenso Ideen entwickeln, die sie von Menschen erhalten.
4. Ein vielversprechender Vorschlag ist noch kein gutes Ergebnis
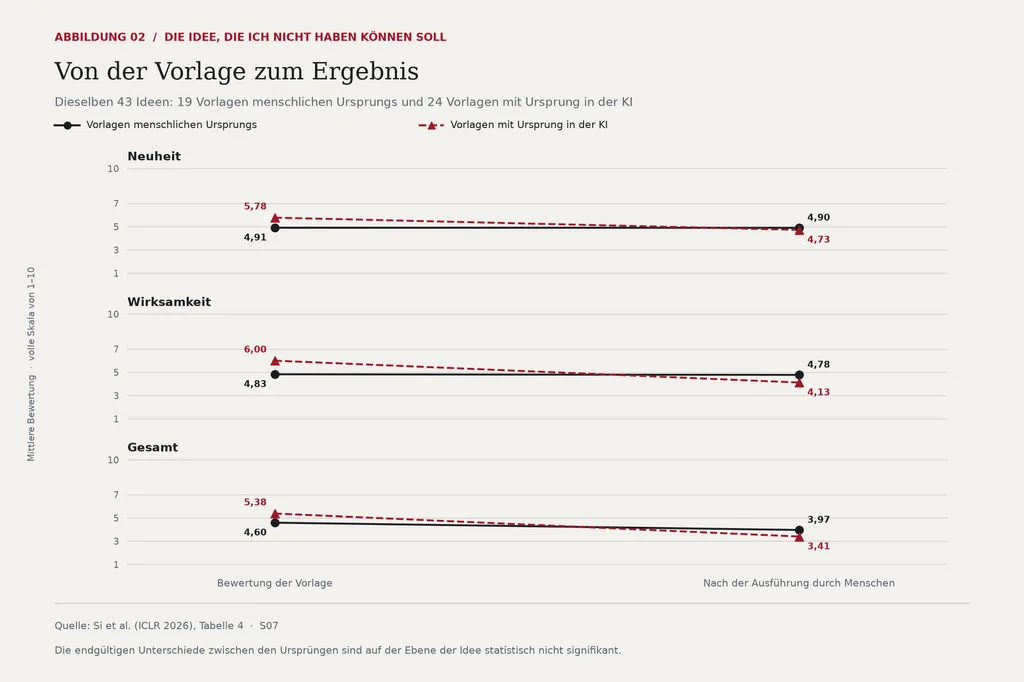
Der nützlichste Beleg gegen Selbstüberschätzung entsteht, wenn man Ideen über die Vorlagenstufe hinaus verfolgt. In der Ausführungsstudie von Si und Kolleginnen und Kollegen setzten 43 Forschende Ideen menschlichen oder KI-Ursprungs um und wandten dafür im Durchschnitt 103 Stunden auf. Die Bewertungen der Vorlagen mit Ursprung in der KI sanken zwischen der ersten Prüfung und der Prüfung nach der Ausführung stärker. Die endgültigen Unterschiede zwischen den beiden Gruppen waren statistisch nicht signifikant, wenn die Ideen als unabhängige Einheiten behandelt wurden. Menschliche Forschende setzten beide Gruppen um.10
Das verändert die Frage. Ein attraktiver Vorschlag kann einen Mechanismus enthalten, der scheitert, eine Annahme, die sich schwer erfüllen lässt, oder eine Auswertung, die das behauptete Ergebnis nicht begründet. Sobald Experimente vorliegen, begegnen die Gutachterinnen und Gutachter anderen Befunden. Das anfängliche Versprechen und der schliessliche Beitrag sollten deshalb getrennt gemessen werden.
Das Ergebnis stellt die ursprüngliche Behauptung, eine KI könne keine Ideen hervorbringen, nicht wieder her. Es legt eine praktischere Schwäche offen: Überzeugende Ideenfindung kann schlecht darauf geeicht sein, was die Ausführung übersteht. Wer unter Vorschlägen wählt, muss mehr wissen, als welcher am überraschendsten klingt.
Eine 2026 veröffentlichte Studie zu Produktideen verdeutlicht eine weitere Unterscheidung. Terwiesch und Kolleginnen und Kollegen verglichen Ideen für preiswerte Produkte, die sich an Studierende richteten. Die KI-Ideen schnitten bei der bewerteten Kaufabsicht stark ab, während menschliche Ideen etwas neuartiger und menschliche Ideensätze vielfältiger waren. Der zentrale Qualitätsvergleich mit GPT-4 verwendete Modellausgaben von 2023. Die Kaufabsicht war ein Bewertungsmass, keine verzeichneten Verkäufe.11
Kreatives Schreiben liefert eine verwandte Warnung. Doshi und Hauser fanden, dass der Zugang zu von KI erzeugten Ideen die Bewertungen einzelner Kurzgeschichten verbessern und zugleich die Ähnlichkeit in der Sammlung erhöhen konnte. Das Experiment untersuchte eine bestimmte Schreibaufgabe und einen bestimmten Arbeitsablauf. Es begründet keine unvermeidliche kulturelle Homogenisierung, zeigt aber, warum individuelle Qualität und kollektive Vielfalt getrennt geprüft werden müssen.12
Auch begünstigt nicht jeder Kreativitätsvergleich die Modelle. Eine grosse Studie zum Divergent Association Task berichtete von einem stärkeren menschlichen oberen Rand. Die Aufgabe misst die semantische Trennung erzeugter Wörter; sie misst nicht unmittelbar originäre Wissenschaft oder unternehmerisches Urteil. Ihr Wert liegt hier darin, zu verhindern, dass eine Studie über die durchschnittliche Leistung in einer Lage zu der Behauptung wird, KI übertreffe die kreativsten Menschen überall.13
Die Belege stützen deshalb ein uneinheitliches Bild. KI kann starke Kandidaten liefern. Sie kann auch in vertraute Bereiche zusammenlaufen, Vorschläge erzeugen, die in der Praxis enttäuschen, und die aussergewöhnliche menschliche Leistung auf manchen Massstäben nicht erreichen. Die richtige Bewertungseinheit ist die konkrete Fähigkeit und der konkrete Arbeitsablauf.
Für Organisationen liegt eine Gefahr darin, ein grösseres Angebot vielversprechender Vorlagen mit einem grösseren Angebot nützlicher Ergebnisse zu verwechseln. Bleiben Bewertungs- und Ausführungskapazität gleich, können zusätzliche Vorschläge Aufmerksamkeit verbrauchen, die sonst in die Prüfung ginge. Das ist eine Folgerung über einen möglichen Engpass, kein gemessenes Gesetz jedes Arbeitsplatzes, der KI einsetzt.
5. Verstehen ist eine Fähigkeit, die sich untersuchen lässt
Die Aussage, einer KI fehle das Verständnis, kann mehrere verschiedene Behauptungen ausdrücken. Sie kann heissen, ein System habe keine nützliche innere Darstellung der Lage. Sie kann heissen, die Darstellung sei zerbrechlich. Sie kann heissen, das System könne eine Erklärung nicht mit praktischen Folgen verbinden. Oder sie betrifft die subjektive Erfahrung. Diese Behauptungen verlangen unterschiedliche Belege.
Ein Modell, das darauf trainiert war, Züge im Spiel Othello vorherzusagen, entwickelte eine innere Darstellung des Bretts. Forschende konnten in diese Darstellung eingreifen und seine Vorhersagen ändern. Das ist ein Beleg dafür, dass die Vorhersage von Folgen etwas über einen zugrunde liegenden Zustand lernen kann und nicht nur eine Liste oberflächlicher Verknüpfungen wiedergibt. Der Rahmen war ein begrenztes Spiel, nicht die ganze soziale oder physikalische Welt.14
Andere Arbeiten warnen davor, solche Befunde zu überinterpretieren. Vafa und Kolleginnen und Kollegen prüften die Stimmigkeit generativer Modelle in Spielen, in der Logik und in der Navigation. Modelle, die unter vertrauten Diagnosen kompetent wirkten, konnten strengere Prüfungen und leicht veränderte Aufgaben nicht bestehen. Ein nützliches inneres Merkmal begründet kein zuverlässiges Modell von allem, was zählt.15
Diese Ergebnisse stützen eine anspruchsvolle Mittelposition. Wir können fragen, was ein System darstellt, wie sich seine Vorhersagen nach einem Eingriff ändern, ob es widersprüchliche Befunde bemerkt und wo seine Kompetenz bricht. Die Antwort kann nach Gebiet und Aufgabe verschieden sein.
Für die frühere Kapitalismushypothese würde praktisches Verständnis einschliessen, zu erkennen, dass Anteilseigner und Kundschaft sich unterscheiden, dass versunkene Investitionen die Verhandlungsmacht mindern können und dass wirtschaftliche Kosten auf Menschen überwälzt werden können, die die Politik nicht gewählt haben. Eine Erklärung wird nützlicher, wenn diese Unterscheidungen Vorhersagen stützen oder zeigen, wo das Argument scheitern würde.
Ein flüssiger Absatz ist für sich ein schwacher Beleg. Eine richtige Antwort auf eine vertraute Frage ist stärker, aber immer noch begrenzt. Zuverlässige Leistung, wenn sich Tatsachen, Grenzen und Anreize ändern, bietet eine bessere Prüfung. Es geht darum, die Fähigkeit zu bewerten, statt sie mit einem Etikett zu erledigen.
Das verhindert auch eine falsche Entgegensetzung von Sprache und Wirklichkeit. Sprache enthält Beschreibungen physikalischer Ereignisse, aber sie hält auch Verträge, Gesetze, Institutionen und rivalisierende Deutungen fest. Eine Kamera kann beobachten, wie jemand ein Dokument unterschreibt, und damit noch nicht die rechtliche Autorität sichtbar machen, die die Unterschrift begründet. Soziales Denken braucht Darstellungen von Beziehungen, die im sichtbaren Bewegungsablauf nicht aufgehen.
Die Darstellung der Welt durch eine KI kann deshalb in mancher Hinsicht nützlich und in anderer unzuverlässig sein. Diese Unebenheit zählt für eine Nutzerin oder einen Nutzer mehr als die Erklärung, das System verstehe entweder alles oder nichts.
6. Gefühle erklären menschliche Kreativität, ohne ihre ganze Grenze festzulegen
Ihr Hinweis auf die Erfahrung verdient mehr als eine technische Abfuhr. Das Leben eines Menschen prägt, was er bemerkt und was er nicht ignorieren kann. Arbeit, Beschämung, Verantwortung, Zuneigung und Verlust können einem Problem ein Gewicht geben, das eine distanzierte Beschreibung nicht vermittelt. Eine menschliche Idee kommt oft mit einem Grund, sich um ihre Folgen zu kümmern.
Ich teile Ihren Körper, Ihre Lebensgeschichte und Ihren Ort in Familie und Unternehmen nicht. Ein System, das mit Beschreibungen arbeitet, hat zu diesen Umständen ein anderes Verhältnis. Dieser Unterschied kann für Urteil, Zeugnis, Vertrauen und die Wahl der Probleme zählen, die es zu verfolgen lohnt.
Aber die Behauptung, menschliches Gefühl trage zur Kreativität bei, ist etwas anderes als die Behauptung, dieselbe Art von Gefühl sei für jedes schöpferische Ergebnis notwendig. Ein Beweis, ein Entwurf oder eine Hypothese lässt sich auf Neuheit und Nutzen prüfen, ohne zuvor die innere Erfahrung der hervorbringenden Instanz festzustellen. Das Argument für eine notwendige emotionale Bedingung braucht eigene Belege.
Der Wert schöpferischer Arbeit ist zudem nach dem Zweck verschieden. In einem Memoir gehört die tatsächliche Erfahrung der schreibenden Person zu dem, was die Leserin oder der Leser sucht. In einem Packalgorithmus lässt sich eine Verbesserung an den Anordnungen messen, die er findet. Eine erdachte Darstellung kann künstlerischen Wert haben, ohne ein Zeugnis zu sein. Diese Unterscheidungen erlauben uns, mehrere Formen von Wert anzuerkennen, ohne sie austauschbar zu machen.
Ob ein KI-System subjektive Erfahrung haben kann, bleibt umstritten. Butlin und Kolleginnen und Kollegen schlagen theoriegestützte Indikatoren vor und betonen zugleich eine erhebliche Unsicherheit. Solche Indikatoren sind kein endgültiger Test, der feststellt, was ein namentlich genanntes System empfindet. Weder ein überzeugendes Gespräch noch eine gelungene Roboterdemonstration entscheidet diese Frage.16
Für diese Untersuchung sollten drei Fragen getrennt bleiben: ob ein System ein lohnendes Ergebnis hervorbringt, ob es eine selbstständig organisierte Untersuchung aufrechterhalten kann und ob es subjektive Erfahrung hat. Belege zu der einen beantworten die anderen nicht von selbst.
Diese Trennung schützt den menschlichen Beitrag auch vor einem unnötigen Einsatz. Die Bedeutung des Zeugnisses eines Elternteils, der Verantwortung einer Unternehmerin oder des Rechts einer Gemeinschaft, zu entscheiden, hängt nicht davon ab, zu beweisen, dass Maschinen für immer scheitern werden, originelle Ideen hervorzubringen. Diese Rollen haben eigene Gründe und Verpflichtungen.
Der stärkste menschliche Vorsprung in diesem Teil des Arguments ist der Zugang zu einem bestimmten Leben und seinen Folgen. Wie weit dieser Vorsprung durch künstliche Systeme ergänzt, dargestellt oder teilweise nachgebildet werden kann, ist eine empirische und institutionelle Frage. Sie sollte nicht im Voraus beantwortet werden, indem man erklärt, alle Beiträge von Maschinen müssten Nachahmung sein.
7. Was AMI Labs zu ändern versucht
AMI Labs gibt auf einen Teil Ihres Einwands eine konkrete Antwort. Sein angegebenes Programm verbindet Modelle der Welt mit bleibendem Gedächtnis, Schlussfolgern und Planung. Es beschreibt, abstrakte Darstellungen von Sensordaten zu lernen und in diesem Darstellungsraum vorherzusagen, einschliesslich Vorhersagen, die von möglichen Handlungen abhängen. Das sind Forschungsziele und architektonische Entscheidungen; die Unternehmensaussage ist selbst kein Beleg, dass das vollständige Programm erreicht ist.17
Betrachten wir einen einfachen Eingriff. Ein Agent beobachtet eine Tasse nahe der Kante eines Tisches. Um eine Bewegung zu planen, muss er einschlägige Eigenschaften der Lage darstellen und voraussehen, wie Handlungen sie verändern könnten. Er muss nicht notwendig jedes Bildpunkt einer Spiegelung vorhersagen. Ein abstraktes Vorhersagemodell kann darauf zielen, die Merkmale zu behalten, die für die Aufgabe zählen, und Einzelheiten zu ignorieren, die sich nicht nützlich vorhersagen lassen.
LeCuns Forschungsfahrplan von 2022 schlug eine Architektur mit mehreren Bestandteilen vor, darunter Wahrnehmung, ein Weltmodell, Gedächtnis, ein handelndes Element und Mechanismen zur Bewertung möglicher Ergebnisse. Seine Bedeutung liegt darin, dass das Weltmodell ein Teil einer umfassenderen Darstellung autonomen Verhaltens war. Der Fahrplan war ein Vorschlag, kein Bericht, allgemeine autonome Intelligenz sei gebaut worden.18
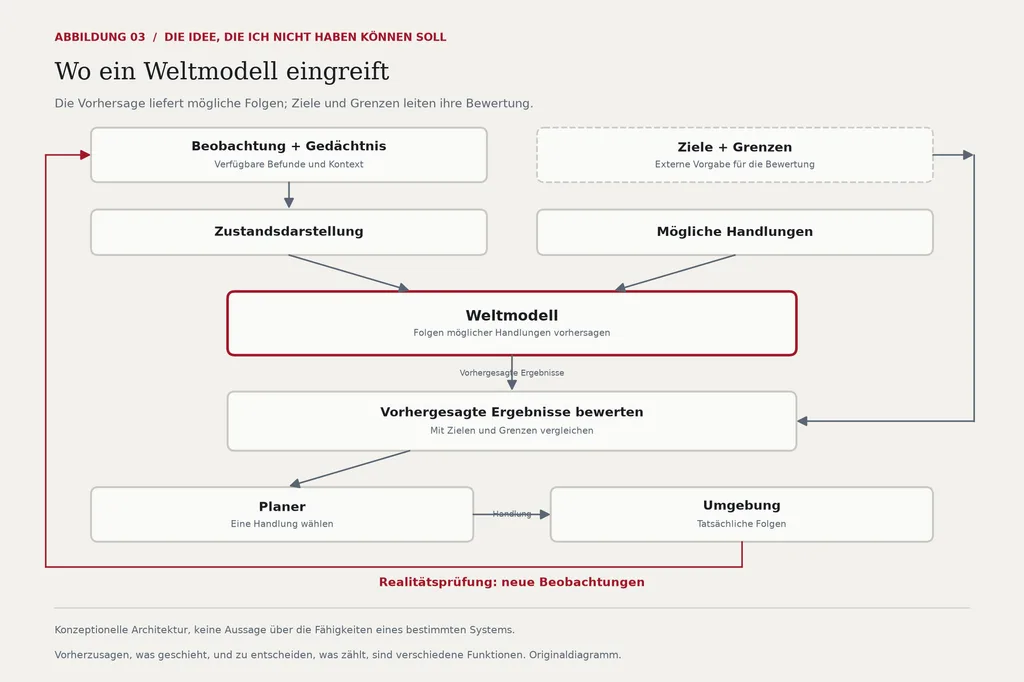
Ein solches System könnte mögliche Folgen vergleichen, bevor es handelt, und dann das, was tatsächlich geschieht, nutzen, um sein Modell oder seinen Plan zu berichtigen. Das wäre für das Erfinden wertvoll, wenn der Nutzen einer Idee von Wechselwirkungen abhängt, die teuer, gefährlich oder langsam direkt zu prüfen sind.
Vorhersage und Zweck bleiben jedoch unterscheidbar. Zu wissen, dass eine Maschine versagen wird, entscheidet für sich nicht, wessen Risiko hinnehmbar ist. Zu wissen, wie ein Markt reagieren könnte, bestimmt nicht, welche Verteilung der Vorteile gerecht ist. Ein Modell braucht eine Weise, die Ergebnisse zu bewerten, die es vorhersagt. Diese Bewertung kann über Anweisungen, gelernte Vorlieben, Belohnungen, Grenzen oder andere Mechanismen geliefert werden.
Das ist eine funktionale Unterscheidung, keine Behauptung, Zielbildung lasse sich nicht konstruieren. Ein Agent kann Teilziele erzeugen und Änderungen eines Plans vorschlagen. Die weitergehenden Fragen sind, woher die Kriterien kommen, ob sie angemessen bleiben und wie das System antwortet, wenn das angestrebte Ziel selbst verfehlt ist.
Es besteht auch keine Notwendigkeit, dass ein nützliches künftiges System nur eine geistige Tradition wählt. Sprachmodelle, gelernte Simulatoren, Suche, Gedächtnis und physische Wechselwirkung können verbunden werden. Der sachliche Vergleich gilt vollständigen Systemen, die nützliche Arbeit leisten, nicht Losungen, die an Architekturen geheftet sind.
Für Ihre Frage ist der Ansatz von AMI glaubwürdig, weil er die Verankerung und die Vorhersage von Handlungsfolgen angeht. Seine Relevanz begründet nicht, dass er für Kreativität notwendig, für schöpferische Autonomie hinreichend oder einzigartig in der Lage wäre, sie zu liefern.
8. Es gibt Fortschritt, und es bleibt ein Problem der Messung
Die gegenwärtigen Belege sind konkreter als eine Reihe von Versprechen. V-JEPA 2.1 berichtet von Verbesserungen in visuellen Aufgaben und von einer Verbesserung um 20 Prozentpunkte beim Greiferfolg eines wirklichen Roboters gegenüber dem angegebenen Vorgänger. Das ist ein Beleg zu einer geprüften physikalischen Fähigkeit. Er misst keine originären geistigen Programme und kein allgemeines schöpferisches Urteil.19
Die mit AMI verbundene H-JEPA-Forschung, eingereicht im Oktober 2026 und im November überarbeitet, lernt eine Hierarchie von Vorhersagemodellen für unterschiedliche Zeitskalen. Auf Visual AntMaze steigt die berichtete Erfolgsquote gegenüber einer flachen Planung von 18 % auf 73 %. Die Hauptauswertung umfasst vier simulierte Umgebungen; die Erweiterung mit Video eines wirklichen Roboters misst die Treue der Offline-Planung. Diese Grenzen zählen bei der Deutung des Ergebnisses.20
Ein gesondertes Oktober-Preprint von Balestriero und LeCun entwickelt ein Theorem zur Ausrichtung von Darstellungen unter Annahmen über geeignete gepaarte Ansichten. Die berichteten Gewinne an Stichprobeneffizienz betreffen das Erreichen eines bestimmten Ausrichtungsniveaus. Sie sollten nicht in die Behauptung übersetzt werden, eine Architektur sei entsprechend intelligenter oder kreativer.21
Andere Forschungsprogramme gehen das Problem anders an. Dreamer 4 lernt Verhalten innerhalb eines Weltmodells und berichtet, die Minecraft-Diamantenaufgabe nach einem Training aus Offline-Daten abgeschlossen zu haben. Die Aufgabe verlangt eine längere Handlungsfolge, aber das Ziel bleibt vorgegeben. Simulierte Verläufe geben der Erörterung der Imagination in dem Aufsatz eine operationale Bedeutung; das Ergebnis begründet kein subjektives Vorstellen.22
Der Ausdruck Weltmodell deckt auch Systeme, die Umgebungen erzeugen oder rekonstruieren sollen. Google DeepMind kündigte Genie 4 im Oktober 2026 als interaktives audiovisuelles Simulationssystem an, zunächst als Forschungsvorschau für vertrauenswürdige Testerinnen und Tester. Sein Entwurf verbindet generative Simulation mit Fähigkeiten von Gemini. Atlas von World Labs bietet Werkzeuge, Szenen zu rekonstruieren, Blickpunkte zu ändern und räumliche Elemente in andere Arbeitsabläufe zu bringen.2324
Diese Fähigkeiten können wertvoll sein, ohne genaue kausale Modelle jedes Eingriffs darzustellen. Eine visuell überzeugende Veränderung ist kein hinreichender Beleg dafür, dass derselbe Eingriff in einer wirklichen Lage dieselbe Folge hätte. Räumliche Stimmigkeit, physikalische Gültigkeit, längerfristige Planung und nützliche Erfindung brauchen eigene Auswertungen.
Auch der wissenschaftliche Weg ist umstritten. Der Bericht der NTU über LeCuns Vorlesung vom November 2026 hält sowohl sein Argument für Weltmodelle fest als auch Einwände von Kolleginnen und Kollegen dagegen, andere Ansätze, einschliesslich des bestärkenden Lernens, beiseitezuwischen. Das Bestehen eines ernsthaften Forschungsprogramms entscheidet nicht, welche Verbindung von Methoden sich als wirksamste erweisen wird.25
Die richtige Aktualisierung ist deshalb erheblich, aber begrenzt. Weltmodelle verbessern bereits bestimmte Fähigkeiten. Keine der hier geprüften Studien zu Weltmodellen zeigt die volle Verbindung, Folgen vorherzusagen und selbstständig ein wertvolles Vorhaben in einer offenen, sich verändernden Welt zu wählen.
9. Der überraschende Beitrag könnte die bessere Zurückweisung sein
Hier ist die Hypothese, die ich in den Mittelpunkt dieses Bandes stellen würde: Weltmodelle könnten mehr zum praktischen Wert der Kreativität beitragen, indem sie undurchführbare Ideen sichtbar machen, als indem sie die Zahl überraschender Ideen erhöhen.
Das ist eine Folgerung aus der Unterscheidung zwischen der Erzeugung von Vorlagen und dem späteren Erfolg, kein feststehendes Ergebnis über AMI oder ein anderes System. Sie kehrt die Erwartung um, ein besseres Verständnis der Welt müsse vor allem deshalb zählen, weil es endlich den ersten schöpferischen Funken erlaube.
Angenommen, ein System kann bereits zahlreiche reizvolle Entwürfe erzeugen. Sein begrenzendes Problem könnte sein, dass es nicht erkennen kann, welche unmögliche Toleranzen verlangen, auf unvereinbaren Anreizen beruhen oder eine Abhängigkeit verbergen, die den Einsatz unpraktisch macht. Eine bessere kontrafaktische Vorhersage würde helfen, diese Vorschläge zu verwerfen, sie zu überarbeiten oder das nächste Experiment zu bestimmen, das sie unterscheiden muss.
Das Ergebnis könnte weniger attraktive Anregungen und mehr gelungene Arbeit sein. Ein Massstab, der nur Neuheit zählte, könnte diese Verbesserung nicht belohnen. Ein Massstab, der Vorlagen bis zur Umsetzung verfolgte, wäre aufschlussreicher.
Die Hypothese hat eine wichtige Grenze. Ein Modell, das an der falschen Umgebung trainiert wurde, kann eine ungewöhnliche Idee verwerfen, weil es schlecht vorhersagt. Es kann auch einen fehlerhaften Vorschlag in seiner eigenen Simulation ungefährlich erscheinen lassen. Der wirkliche Wert kommt von Vorhersagen, die geeicht bleiben, wenn sie an Folgen ausserhalb des Modells geprüft werden.
Wir können eine unterscheidende Prüfung angeben. Sprachmodell, Zugang zu Quellen und Suchbudget so konstant wie möglich halten. In einer Bedingung eine vorhersagende Weltmodell-Komponente hinzufügen. Vergleichen, ob ihre ausgewählten Ideen nach einer Prüfung von aussen weniger von ihrem scheinbaren Wert verlieren. Die Neuheit der Vorlagen gesondert messen. Eine Verbesserung der Durchführbarkeit oder der Ergebnisqualität ohne grössere Neuheit würde den vorgeschlagenen Mechanismus stützen.
Das schliesst Verbesserungen der Ideenerzeugung nicht aus. Bessere Darstellungen können Möglichkeiten sichtbar machen, die zuvor schwer auszudrücken waren. Es sagt, dass die Fähigkeit eines Systems, einen verlockenden Fehler auszuschliessen, wirtschaftlich ebenso wertvoll sein kann wie die Fähigkeit, eine weitere ungewöhnliche Möglichkeit vorzuschlagen.
Auch ist eine verbesserte Vielfalt nicht ausschliesslich eine Frage der Modellarchitektur. Das Arbeitspapier von Luo und Kolleginnen und Kollegen aus dem Jahr 2026 untersucht Methoden, vielfältige Antworten in offenen Suchen aufrechtzuerhalten. Die berichteten Ergebnisse gelten den geprüften Verfahren und Massstäben. Es gibt einen Grund, zu prüfen, wie die Suche organisiert ist, statt die Wiederholung einer Chat-Sitzung als unveränderliche Obergrenze zu behandeln.26
Die tiefere Verschiebung führt von der Frage, ob eine Maschine erfinderisch klingen kann, zu der Frage, wie der vollständige Vorgang begründete, nützliche Neuheit erzeugt. Dieser Vorgang umfasst Erzeugung, Auswahl, äussere Befunde und Überarbeitung.
10. Wie lange der behauptete Vorsprung dauern wird
Es gibt keine einzige Uhr, weil die Behauptung mehrere Schwellen verbindet. Für das Hervorbringen nützlicher Ideen als Kandidaten innerhalb eines weiten Auftrags ist die Schwelle in dokumentierten Lagen bereits überschritten. Für das Finden neuer, überprüfbarer Lösungen innerhalb eines formalen Suchproblems gibt es ebenfalls Belege. Für zuverlässige geistige Initiative in ungewohnten menschlichen Umständen bleiben die Belege unvollständig.
Es wäre deshalb irreführend, ein Datum anzubieten, an dem KI erstmals kreativ wird. Verschiedene Bedeutungen des Wortes ergeben verschiedene Daten, und einige der einschlägigen Fähigkeiten sind bereits vorhanden. Ein Modell kann sich darin verbessern, Vorlagen zu erzeugen, und zugleich schlecht darin bleiben, die Vorlage zu wählen, die ein Jahr Arbeit verdient.
Die stärkere künftige Schwelle würde ein System betreffen, das wiederholt erhebliche Abweichungen bemerkt, lohnende Fragen wählt, nicht triviale Erklärungen vorschlägt, sie ausserhalb seiner vertrauten Verteilung prüft und sein Programm überarbeitet, wenn die Befunde widersprechen. Der Erfolg müsste über Fälle hinweg bestehen, mit unabhängiger Bewertung und einem Nachweis der Misserfolge wie der ausgewählten Erfolge.
Die hier geprüften öffentlichen Belege liefern kein zuverlässiges Jahr für diese vollständige Fähigkeit. Das Programm von AMI benennt Zutaten, die zu untersuchen sind, keinen bestätigten Countdown. Belege für einen Ansatz schliessen Hybride oder andere Wege auch nicht aus.
Mein praktisches Urteil ist gleichwohl klar: Ich würde keine Strategie auf weitere mehrere Jahre ausschliesslichen menschlichen Besitzes lohnender Ideen bauen. Diese Ausschliesslichkeit ist bereits eine zu starke Voraussetzung. Ich würde in die Fähigkeit investieren, wichtige Probleme zu wählen, Zugang zu einschlägigen Befunden zu gewinnen, Vorschläge preiswert zu prüfen und zu erkennen, wann eine attraktive Theorie gescheitert ist.
Das macht eine schöpferische Person nicht schon begrifflich weniger wertvoll. Eine preiswertere Entwicklung kann mehr menschliche Ideen verfolgenswert machen. Sie kann auch konkurrierende Ideen für alle anderen preiswerter erzeugen lassen. Das Gleichgewicht hängt von der Aufgabe, den verfügbaren Befunden und den Kosten ab, die bleiben. Aus dem Preis der Texterzeugung lässt sich keine allgemeine Behauptung über die einzige wertvollste menschliche Eigenschaft ableiten.
Für jemanden, der Unternehmen aufbaut, ist die nützliche Frage, wo ein bestimmtes Urteil das Ergebnis ändert. Es kann darin liegen, die unausgesprochene Grenze einer Kundin oder eines Kunden zu verstehen, eine technisch durchführbare Gelegenheit zu erkennen, Zusammenarbeit zu sichern, eine attraktive Ablenkung abzulehnen oder bei einem Experiment auszuharren, das zunächst enttäuschend wirkt.
Diese Fähigkeiten können Kreativität, Fachkenntnis, Urteilskraft und Verantwortung umfassen. Sie als geschützte Kategorie zu behandeln, in die KI nicht eintreten kann, riskiert, einen gegenwärtigen praktischen Vorsprung mit einer dauerhaften Grenze zu verwechseln.
11. Eine Prüfung, deren Ausgang wir nicht beherrschen
Die konkrete Behauptung zu der früheren Kapitalismusidee lässt sich jetzt nicht sauber prüfen. Ihr zentraler Mechanismus ist bereits im Gespräch. Eine Vorführung, die ihn nach dieser Kenntnis reproduziert, würde keine unabhängige Herkunft begründen.
Eine faire prospektive Prüfung würde neue Lagen verwenden. Faktische Dossiers vorbereiten, ohne die gewünschte Deutung aufzunehmen. Thierry hält seine stärksten Hypothesen fest, bevor das Modell das Material sieht. Neue Modellsitzungen erhalten dieselben Dossiers und die weite Bitte, einen übersehenen, folgenreichen Mechanismus zu benennen. Die menschliche Schlussfolgerung und die leitenden Analogien bleiben ausgeschlossen.
Die Zahl der eingereichten Hypothesen festlegen und jeden Versuch bewahren. Die verstrichene Zeit, Modellversionen, den Zugang zu Quellen sowie den Aufwand für Suche und Prüfung aufzeichnen. Einen menschlichen Vorschlag mit dem besten aus Tausenden verborgenen Modellversuchen zu vergleichen würde eine andere Frage beantworten als den Vergleich der gewöhnlichen Leistung unter einem erklärten Budget.
Unabhängige Gutachterinnen und Gutachter sollten die Vorschläge bewerten, ohne ihren Ursprung zu kennen. Neuheit, erklärende Kraft, sachliche Stimmigkeit, praktischer Wert und Prüfbarkeit gehören auf getrennte Skalen. Die Suche nach früherer Arbeit sollte einem dokumentierten Verfahren folgen. Eine plausible Hypothese kann Aufmerksamkeit verdienen, auch wenn ein älteres Argument ihre zentrale Struktur enthält; die historische Neuheit muss dann ehrlich beschrieben werden.
Eine zweite Spur sollte die Wahl des Problems bewerten. Beide Beteiligten erhalten eine gemischte Sammlung von Beobachtungen, ohne die Frage zu benennen. Gefragt wird, was eine Untersuchung verdient, warum es zählt und welche Befunde die vorgeschlagene Deutung ändern würden. Das prüft mehr als die Fähigkeit, eine gelieferte Frage zu beantworten.
Die vielversprechendsten Vorschläge sollten einer Prüfung durch Befunde oder einer begrenzten Umsetzung begegnen. In jeder Bedingung dasselbe Auswahlverfahren verwenden und, wenn die Mittel es erlauben, einige zufällig gewählte Vorschläge einbeziehen. Sonst kann eine eindrucksvolle Darstellung bestimmen, welche Ideen je die Chance erhalten, sich zu bewähren.
Bedingungen mit Menschen allein, mit KI allein und in Zusammenarbeit sollten getrennt bleiben. Fälle und Beteiligte so zuteilen, dass frühere Kenntnis kontrolliert wird. Kehrt dieselbe Person mit KI zu einem Dossier zurück, ist das als zeitliche Erweiterung mit kumulierter Zeit zu berichten, nicht als unabhängiger Vergleich. Eine Zusammenarbeit kann beide Beteiligte übertreffen, ohne zu zeigen, dass die eine Seite keinen originellen Beitrag geleistet hat. Die Herkunft sollte zeigen, welche Begriffe in der Eingabe vorhanden waren, welche später erschienen und welche die Prüfung überstanden.
Für Weltmodelle würde ein weiterer Vergleich die vorhersagende Komponente hinzufügen und die übrigen Bedingungen so stabil wie möglich halten. Wenn sich Modellfamilien, Daten, Werkzeuge und Stichprobenbudgets zugleich ändern, lässt sich eine Verbesserung nicht eigens dem Weltmodell zuschreiben.
Das beigefügte Protokoll ist ein Vorschlag für einen solchen Versuch. Es ist nicht durchgeführt worden. Es enthält keine erfundenen Kennzahlen und behauptet nicht, eine kleine Stichprobe könne einen dauerhaften Vorsprung begründen. Sein Zweck ist, klarzumachen, welche Beobachtung die Meinung einer der beteiligten Seiten ändern würde.
Eine nützliche, vom Modell erzeugte Synthese, deren zentraler Mechanismus in der Eingabe fehlte und die Prüfung früherer Arbeit überstand, würde die Behauptung infrage stellen, die zentrale Antwort müsse jeweils neu von einem Menschen geliefert werden. Die Abwesenheit im Prompt allein würde weder historische Neuheit begründen noch den Rückgriff auf ein bestehendes Argument ausschliessen. Wiederholte menschliche Vorteile bei Bedeutung, Eichung oder Ergebnissen würden eine engere und aufschlussreichere Behauptung stützen. Ein Scheitern an einer begrenzten Sammlung von Fällen würde eine Grenze unter diesen Bedingungen begründen, kein Unmöglichkeits-Theorem.
12. Was zu verteidigen bleibt
Ihre ursprüngliche Behauptung schützt etwas Wirkliches: Ein scharfer Verstand kann bemerken, was anderen entgeht. Er kann entfernte Ereignisse verbinden, einen akzeptierten Rahmen befragen und eine Möglichkeit erkennen, bevor jemand eine ordentliche Aufgabenbeschreibung vorbereitet hat. Dieser Beitrag verdient eine sorgfältige Prüfung.
Die Belege stützen nicht, Menschen das ausschliessliche Eigentum an jedem Teil dieses Beitrags zu geben. KI-Systeme können zentrale Vorschläge erzeugen und bisweilen überprüfbar neue Lösungen hervorbringen. Ihre Grenzen betreffen Zuverlässigkeit, Urteil, Vielfalt, Verankerung und anhaltende Handlungsfähigkeit in wechselnden Verbindungen. Der Ursprung in einer Maschine sagt allein nicht, welchen Beitrag sie leisten kann.
Die anspruchsvollere Bestimmung eines wertvollen Verstandes schliesst die Bereitschaft ein, die eigene attraktive Idee zu überarbeiten. Das erste Kapitalismusargument wurde stärker, als es Grenzen anerkannte: Wirtschaftliche Kosten machen Entscheidungen nicht unmöglich, ausländische Anteilseigner verbürgen keinen Zugang, und durchsetzbare Institutionen zählen. Kreativität lag in der ersten Verbindung und in den Änderungen nach der Prüfung.
Deshalb ist eine eingeladene Erwiderung eine nützliche Form für diesen Band. Ein System um Widerspruch zu bitten schafft eine Gelegenheit zur Korrektur. Es beweist nicht, dass das System die Untersuchung ohne die Einladung begonnen hätte. Der Auftrag und der Beitrag lassen sich beide genau festhalten.
Die Arbeit zwischen den Prompts verlangt in der Bibliothek nach beobachtbaren Belegen, dass eine Arbeit abgeschlossen ist. What You Get from AI misst anerkannte Ergebnisse mit der Prüfung und Nachbesserung, die sie verlangt haben. Dieselbe Disziplin gehört weiter vorn, dort, wo Vorschläge um Aufmerksamkeit konkurrieren. Eine Idee hat ihren Wert nicht schon verdient, weil sie Begeisterung erzeugt hat.2728
Weltmodelle können diesen Vorgang verbessern, indem sie vorgeschlagene Folgen vor dem Handeln prüfbarer machen. Sie können auch zu Darstellungen beitragen, aus denen bessere Ideen entstehen. Keine der beiden Möglichkeiten entscheidet den Ursprung lohnender Zwecke oder die Frage der subjektiven Erfahrung.
Die Behauptung, die ich gegen Sie verteidigen kann, ist deshalb bestimmt: Menschen haben keinen ausschliesslichen Anspruch mehr darauf, nützliche Gedanken als Kandidaten hervorzubringen. Die Behauptung, die ich nicht begründen kann, lautet, die gegenwärtige KI ersetze zuverlässig die ganze menschliche Praxis des Bemerkens, Wählens, Prüfens, Sich-Kümmerns und der Verantwortung.
Die künftige Prüfung sollte offen bleiben. Liefert eine Maschine eine gute Idee, sollten wir den Beitrag anerkennen können. Sieht ein Mensch die wichtige Frage, die der Maschine entgeht, sollten wir zeigen können, worin der Unterschied liegt. Ein wertvoller Verstand verdient seinen Platz durch diese Arbeit, nicht durch eine Definition, die einer Rivalin oder einem Rivalen von vornherein die Qualifikation verwehrt.
Einschätzung der ursprünglichen Behauptungen
| Behauptung | Einschätzung | Begründung |
|---|---|---|
| Eine KI kann nur die zentrale Idee ausarbeiten, die ein Mensch liefert | Als absolute Behauptung zurückgewiesen | Studien und Entdeckungssysteme enthalten zentrale Vorschläge und überprüfte Lösungen, die im Prompt nicht geliefert wurden. |
| KI erhält Aufgaben und Ziele von Menschen | Häufig zutreffend, aber nicht hinreichend | Eine gelieferte Frage ist nicht notwendig eine gelieferte Antwort; die tatsächliche Stützung ist festzuhalten. |
| Keine KI kann eine ausgezeichnete neue Idee hervorbringen | Zu weit, um sie zu halten | Manche Beiträge sind neu und nützlich; eine aussergewöhnliche, offene Leistung ist eine strengere Prüfung. |
| Menschliche Erfahrung zählt für das schöpferische Urteil | Stark und einschlägig | Lebensgeschichte und Folgen beeinflussen die Wahl des Problems; die Notwendigkeit für jedes schöpferische Ergebnis ist unbewiesen. |
| Ein neuartiger Vorschlag begründet wertvolle Forschung | Zurückgewiesen | Die Prüfung der Ergebnisse kann die Einschätzung erheblich verändern; Qualität und Vielfalt unterscheiden sich. |
| Weltmodelle könnten schöpferische Arbeit verbessern | Plausibel, mit teilweisen Belegen | Vorhersage und Planung verbessern sich in begrenzten Lagen; Gewinne bei schöpferischen Ergebnissen verlangen unmittelbare Prüfungen. |
| AMI wird den entscheidenden Durchbruch an einem bekannten Datum liefern | Nicht begründet | Ein glaubwürdiges Programm und technische Ergebnisse liefern keinen bestätigten Zeitplan und keinen ausschliesslichen Weg. |
| Kreativität ist die einzige wertvollste Fähigkeit | Vom Zusammenhang abhängiges Urteil | Der Wert hängt auch von Auswahl, Befunden, Ausführung, Zugang, Vertrauen und Verantwortung ab. |
Methode und Geltungsbereich
Dies ist eine eingeladene Gegenrede, kein kontrolliertes Experiment und keine unabhängige Prüfung der assistierenden Instanz, die sie schreibt. Die auslösende Kapitalismushypothese und die Herausforderung zur Kreativität hat Thierry Gilgen in diesem Gespräch geliefert. Der Beitrag trennt persönlich originäre Synthese von dokumentierter historischer Priorität, Bewertungen von Vorlagen von umgesetzten Ergebnissen und schöpferische Leistung von Handlungsfähigkeit und subjektiver Erfahrung. Primäre Aufsätze und amtliche Projektbeschreibungen werden bevorzugt; Preprints und Unternehmensangaben sind gekennzeichnet. Daten von Modellen und Experimenten werden von Veröffentlichungsdaten unterschieden. Die empirische Abbildung gibt veröffentlichte Mittelwerte wieder, ohne Unsicherheitsintervalle zu erfinden. Sie vergleicht Vorlagen mit späteren Projektprüfungen, nicht dieselben Angaben, die zweimal bewertet wurden. Für die endgültigen Ausführungstabellen der ICLR 2026 wurde amtlich indexierter Text verwendet, als der unmittelbare PDF-Abruf auf eine Zugangsprüfung stiess. Der vorgeschlagene Versuch und die Hypothese, Weltmodelle verbesserten die Zurückweisung, sind hier nicht geprüft worden. Der Stichtag der Belege ist der 15. November 2026.
Weiterlesen in der Bibliothek
- Was es kostet, die Welt auszusperren: die auslösende Hypothese über wirtschaftliche Zurückhaltung, geprüft im vorausgehenden Band.
- Die Arbeit zwischen den Prompts: beobachtbare Belege dafür, dass eine Arbeit abgeschlossen ist.
- What You Get from AI: anerkannte Ergebnisse, einschliesslich der Prüfung und Nachbesserung, die sie verlangt haben.
Quellen
Die Quellen wurden am 15. November 2026 geprüft. Jede nummerierte Anmerkung nennt ihre Quellenkennung (S01–S28).
Anmerkungen und Quellen
-
Runco and Jaeger, The Standard Definition of Creativity. 10. Februar 2012. doi.org. (Quelle S01) ↩
-
Margaret Boden, Creativity and Artificial Intelligence. 1997. ijcai.org. (Quelle S02) ↩
-
Montesquieu, The Spirit of Laws, Buch 20, Kapitel 1–8. 1748. press-pubs.uchicago.edu. (Quelle S03) ↩
-
Immanuel Kant, On Perpetual Peace: A Philosophical Sketch. 1795; Übersetzung von Ian Johnston, März 2012. web.viu.ca. (Quelle S04) ↩
-
Albert Hirschman, The Passions and the Interests: Political Arguments for Capitalism before Its Triumph. Princeton University Press, 1977; Nachweis der Neuausgabe 6. Oktober 2013. press.princeton.edu. (Quelle S05) ↩
-
Si and colleagues, Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers. ICLR 2025; erstes Preprint 6. September 2024. proceedings.iclr.cc. (Quelle S06) ↩
-
Mathematical discoveries from program search with large language models. Nature, 14. Dezember 2023 (online); 2024, Band 625. www.nature.com. (Quelle S10) ↩
-
Google DeepMind, AlphaEvolve: A coding agent for scientific and algorithmic discovery. 16. Juni 2025. arxiv.org. (Quelle S11) ↩
-
Towards end-to-end automation of AI research. Nature, 25. März 2026. www.nature.com. (Quelle S12) ↩
-
Si and colleagues, The Ideation–Execution Gap: Execution Outcomes of LLM-Generated versus Human Research Ideas. ICLR 2026; erstes Preprint 25. Juni 2025. openreview.net. (Quelle S07) ↩
-
Terwiesch and colleagues, Artificial intelligence and its impact on creativity and diversity: An empirical study of large language model-generated product ideas. Production and Operations Management, 22. Juli 2026. journals.sagepub.com. (Quelle S08) ↩
-
Doshi and Hauser, Generative AI enhances individual creativity but reduces the collective diversity of novel content. Science Advances, 12. Juli 2024. www.science.org. (Quelle S09) ↩
-
A large-scale comparison of divergent creativity in humans and large language models. Nature Human Behaviour, 23. Dezember 2025 (online); März 2026, Band 10. www.nature.com. (Quelle S28) ↩
-
Emergent World Representations: Exploring a Sequence Model Trained on a Synthetic Task. ICLR 2023; Preprint 24. Oktober 2022, Überarbeitung 26. Juni 2024. arxiv.org. (Quelle S13) ↩
-
Vafa and colleagues, Evaluating the World Model Implicit in a Generative Model. NeurIPS 2024; Preprint 6. Juni 2024, Überarbeitung 10. November 2024. arxiv.org. (Quelle S14) ↩
-
Butlin and colleagues, Identifying indicators of consciousness in AI systems. Trends in Cognitive Sciences, 10. November 2025 (online); Juni 2026, Band 30, Heft 6. doi.org. (Quelle S25) ↩
-
AMI Labs, Real World. Real Intelligence. Aktuell beim Zugriff, 15. November 2026. amilabs.xyz. (Quelle S15) ↩
-
Yann LeCun, A Path Towards Autonomous Machine Intelligence. 27. Juni 2022, Fassung 0.9.2. openreview.net. (Quelle S16) ↩
-
V-JEPA 2.1: Unlocking Dense Features in Video Self-Supervised Learning. Eingereicht 15. März 2026, überarbeitet 11. Juni 2026. arxiv.org. (Quelle S17) ↩
-
H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning. Eingereicht 5. Oktober 2026, überarbeitet 1. November 2026. arxiv.org. (Quelle S18) ↩
-
Randall Balestriero and Yann LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs. 29. Oktober 2026. arxiv.org. (Quelle S19) ↩
-
Danijar Hafner, Wilson Yan and Timothy Lillicrap, Training Agents Inside of Scalable World Models. 29. September 2025. arxiv.org. (Quelle S20) ↩
-
Google DeepMind, Genie 4: A new generation of world simulation. 27. Oktober 2026. deepmind.google. (Quelle S21) ↩
-
World Labs, Atlas: Releasing our next generation world model. 12. November 2026. worldlabs.ai. (Quelle S22) ↩
-
Nanyang Technological University, College of Computing and Data Science, Are world models the future of AI? Insights from Distinguished Speaker Yann LeCun and CCDS faculty. Vorlesung 3. November 2026; Bericht 6. November 2026. www.ntu.edu.sg. (Quelle S23) ↩
-
Luo, King, Puett and Smith, Inducing Sustained Creativity and Diversity in Large Language Models. Fassung als Arbeitspapier, 30. Oktober 2026. gking.harvard.edu. (Quelle S24) ↩
-
Thierry Gilgen, The Work Between the Prompts. 2. Oktober 2026; Ausgabe 5, 11. November 2026. www.thierry-gilgen-ict.ch. (Quelle S26) ↩
-
Thierry Gilgen, What You Get from AI. 16. Oktober 2026, Ausgabe 3. www.thierry-gilgen-ict.ch. (Quelle S27) ↩