Diese Woche bin ich an einem LinkedIn-Beitrag hängen geblieben.
Er beschrieb NVIDIAs RTX Spark als den Moment, in dem die klassische PC-Architektur endet: CPU, GPU und Arbeitsspeicher verschmelzen zu einem einzigen System, ein Petaflop lokale KI-Leistung, grosse Modelle ohne Cloud-Server, persönliche Agenten, die dauerhaft auf dem Gerät leben.
Das war dramatisch formuliert.
Teilweise zu dramatisch.
Aber der Instinkt dahinter stimmte.
Mit dem Personal Computer passiert gerade etwas Wichtiges.
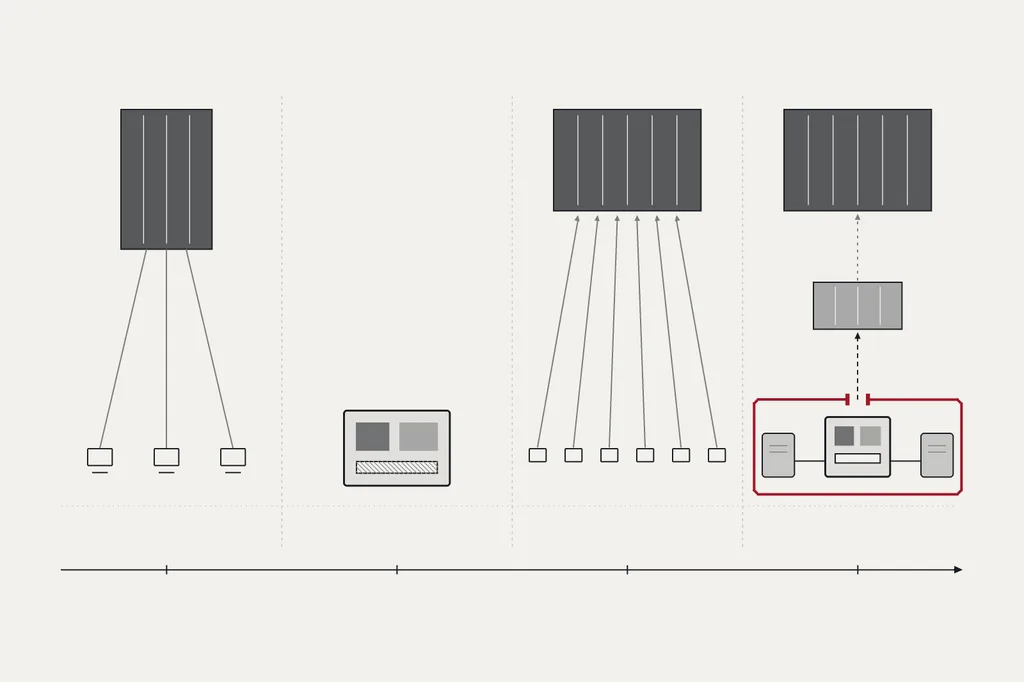
Fast fünfzehn Jahre lang schien die Richtung klar. Wir haben das Rechnen vom Schreibtisch weggeholt und in das Rechenzentrum von jemand anderem verlegt. Aus Servern wurden Cloud-Regionen. Aus Software wurden Dienste. Aus Speicher wurden Konten. Die leistungsfähigste künstliche Intelligenz wurde zu einem API-Aufruf.
Die Maschine vor uns blieb wichtig, aber immer mehr als Fenster auf eine Infrastruktur, die woanders steht.
KI hat diese Verschiebung beschleunigt. Das Klügste, was mein Laptop tun konnte, geschah oft gar nicht auf meinem Laptop.
RTX Spark zeigt in die Gegenrichtung.
Nicht zurück in die Neunzigerjahre. Nicht weg von der Cloud. Nicht hin zu einer Fantasie technologischer Abschottung.
Sondern zu einer anderen Arbeitsteilung.
Das Training kann in riesigen KI-Fabriken bleiben. Frontier-Modelle lassen sich weiterhin aufrufen, wenn man sie braucht. Aber Speicher, Kontext, Inferenz, Werkzeuge und dauerhaft laufende Agenten können zunehmend dort sitzen, wo der Mensch arbeitet, dem sie dienen.
Das verändert die Leistung.
Es verändert auch den Besitz.
Und Besitz verändert die Frage der Souveränität.
Zuerst die Geschichte richtigstellen
Die Social-Media-Version presst mehrere getrennte Entwicklungen in einen einzigen dramatischen Moment.
RTX Spark wurde nicht gestern vorgestellt. NVIDIA hat die Plattform am 31. Mai 2026 an der GTC Taipei rund um die COMPUTEX angekündigt. Neu aktuell wurde sie im September, weil aus der Ankündigung ein Produkt wird: An der IFA 2026 bestätigte NVIDIA, dass die ersten Windows-PCs mit RTX Spark im Oktober kommen, und zeigte weitere Teile des Stacks rund um lokale Agenten, darunter NVIDIA PAIR, das Inferenz-Anfragen über mehrere Rechner im lokalen Netzwerk verteilt.12
Auch die Architektur verdient Genauigkeit.
RTX Spark kombiniert eine Blackwell-RTX-GPU mit einer Arm-basierten Grace-CPU mit 20 Kernen und unterstützt bis zu 128 GB kohärenten, gemeinsam genutzten LPDDR5X-Speicher. NVIDIAs Entwicklerdokumentation nennt für das Spitzenmodell eine 256-Bit-Speicherschnittstelle mit rund 300 GB/s Bandbreite.3
Das heisst nicht, dass CPU, GPU und 128 GB RAM buchstäblich zu einem einzigen Stück Silizium geworden sind. Es heisst, dass CPU und GPU über eine gemeinsame, kohärente Speicherarchitektur arbeiten. Früher gehörte der Arbeitsspeicher der CPU, und die separate GPU hatte ihren eigenen, physisch getrennten Grafikspeicher.
Der Unterschied ist wichtig.
Beim Petaflop ebenso.
NVIDIA wirbt mit bis zu einem Petaflop FP4-KI-Leistung. Das ist spezialisierte Tensor-Leistung mit geringer Genauigkeit, nicht ein Petaflop beliebiger Rechenarbeit. Für quantisierte Inferenz ist das eine wichtige Fähigkeit. Man sollte die Marketingzahl aber nicht mit einem allgemeinen Mass für Anwendungsleistung verwechseln.1
Auch die Aussage, das System könne Modelle mit 120 Milliarden Parametern und sehr langem Kontext ausführen, ist eine Plattformangabe von NVIDIA, noch kein unabhängiger Benchmark auf Seriengeräten. Technisch ist es plausibel, dass quantisierte Modelle der 120B-Klasse in diese Speicherklasse passen: Der Checkpoint von OpenAIs gpt-oss-120b etwa ist rund 60,8 GiB gross und wurde so ausgelegt, dass er auf einen Beschleuniger mit 80 GB passt.4 Doch Modellgrösse, Kontextlänge, KV-Cache, Quantisierung, Batch-Grösse und Inferenz-Engine verändern alle, was «läuft lokal» in der Praxis bedeutet.
Die gleiche Vorsicht gilt beim Gaming. NVIDIA sagt, RTX Spark schaffe in AAA-Titeln bei 1440p über 100 Bilder pro Sekunde. Aktuelle PC-Berichterstattung weist darauf hin, dass diese Zahl stark auf DLSS und Frame Generation beruhen kann und weniger auf reiner Rasterleistung.5
Und «kein Monatsabo» ist keine Eigenschaft des Chips.
Wenn ich ein Open-Weight-Modell, lokale Werkzeuge und lokalen Speicher nutze, dann ja: Die Inferenz kann laufen, ohne dass ich einem Modellanbieter jedes Token bezahle. Aber auch ein lokaler Agent kann Abo-Software, lizenzierte Modelle, Cloud-Suche, gehostete E-Mail, SaaS-APIs, entfernten Speicher oder den Sprung zu einem Frontier-Modell nutzen.
Die richtige Aussage ist interessanter als die virale:
RTX Spark macht einen viel grösseren Teil nützlicher Maschinenintelligenz wirtschaftlich und technisch möglich, und zwar auf Hardware, die dem Nutzer gehört.
Das genügt.
Die Zahl, die zählt, heisst 128 GB
Vermarktet wird der Launch mit einem Petaflop.
Ich komme immer wieder auf den Speicher zurück.
KI hat eine brutale Eigenschaft: Wenn das Modell und sein Arbeitszustand nicht dort Platz haben, wo der Beschleuniger effizient darauf zugreifen kann, ist die theoretische Rechenleistung nicht mehr die interessante Grenze.
Jahrelang drehten sich Gespräche über Consumer-GPUs vor allem darum, wie viel Grafikspeicher eine Karte hat. Acht Gigabyte. Zwölf. Sechzehn. Vierundzwanzig. Reichlich für Spiele, oft schmerzhaft wenig für grosse lokale Modelle.
Gemeinsamer Speicher verändert diese Geometrie.
Die Spitzenkonfiguration von RTX Spark kann einer kohärenten CPU/GPU-Architektur bis zu 128 GB zur Verfügung stellen.3 Die Systeme mit AMD Ryzen AI Max+ haben bereits gezeigt, warum das wichtig ist: AMD liefert Systeme mit 128 GB Speicher aus und positioniert sie ausdrücklich für Modelle der 128B-Klasse, in neuerer Kommunikation rund um «Agent Computers» sogar für noch grössere lokale Modelle, sofern Quantisierung und Software mitspielen.6 Apples aktueller M5 Ultra treibt dieselbe Grundidee am Workstation-Ende viel weiter, mit bis zu 512 GB gemeinsamem Speicher und 1,2 TB/s Speicherbandbreite.7
Die Idee des gemeinsamen Speichers ist also nicht neu.
Neu ist, wie normal es wird, einen Personal Computer um den Speicherbedarf von KI herum zu bauen, statt lokale KI als Nebenbeschäftigung für ungenutzte GPU-Kapazität zu behandeln.
Das hat Folgen, die über das Laden eines grossen Sprachmodells hinausgehen.
Ein nützlicher Agent braucht mehr als Gewichte. Er braucht vielleicht einen langen Kontext, Embeddings, Bild-Encoder, Sprachmodelle, Suchindizes, Werkzeugzustand, mehrere gleichzeitig laufende Modellinstanzen, spekulatives Decoding, Caches und womöglich mehrere Subagenten auf einmal.
Speicher wird zur strategischen Ressource, weil er bestimmt, wie viel von diesem Arbeitsbestand nahe am Beschleuniger bleiben kann.
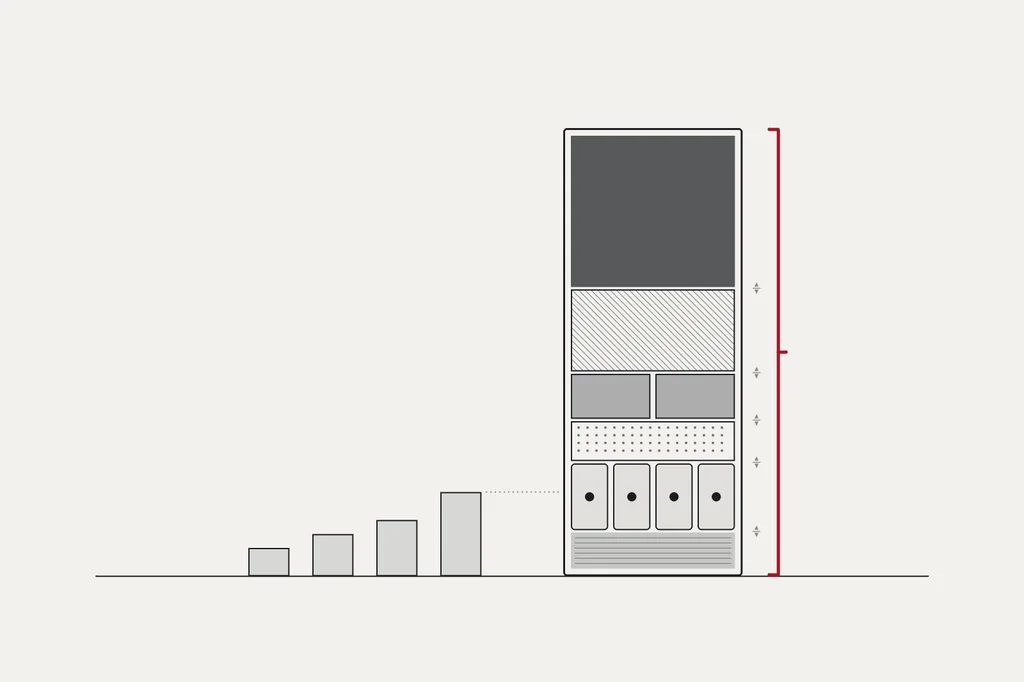
Das Modell, das hineinpasst, kann nützlicher sein als das auf dem Papier klügere Modell, das für jede Interaktion übers Netz muss.
Deshalb zählen 128 GB vielleicht mehr als die Launch-Folie, auf der ein Petaflop steht.
Das Petaflop sagt, wie schnell der Chip rechnen kann.
Der Speicher sagt, wie viel Intelligenz dort tatsächlich wohnen kann.
Der PC wird zum Gastgeber für Agenten
Eine herkömmliche Anwendung wartet.
Ich starte sie. Ich klicke etwas an. Sie verarbeitet eine Anfrage. Ich schliesse sie.
Ein nützlicher Agent ist anders gebaut.
Er beobachtet. Er erinnert sich. Er empfängt Ereignisse. Er arbeitet, während ich etwas anderes tue. Er zerlegt vielleicht eine Aufgabe in Teilprobleme. Er ruft Werkzeuge auf, durchsucht Dateien, schreibt Code, öffnet Dokumente, fragt Modelle an, wartet auf eine Antwort und macht später weiter.
Deshalb ist der physische Ort des Agenten erstaunlich wichtig.
Ein Agent, der neben meinen Dateien, Anwendungen, dem Mikrofon, lokalen Datenbanken und Geräten lebt, kann mit weniger Verzögerung beobachten und handeln, ohne ständig rohen Kontext nach aussen zu schicken. Er kann begrenzte Arbeit fortsetzen, wenn das öffentliche Internet ausfällt. Er kann sensible Zwischenstände von einem fremden Inferenzdienst fernhalten. Er kann aber auch weit gefährlicher werden, wenn er dieselben Rechte erhält wie das Benutzerkonto, unter dem er läuft.
Die Industrie hat die zweite Hälfte dieses Satzes bemerkt.
Microsoft macht die Ausführung von Agenten zur Aufgabe des Betriebssystems. Die Microsoft Execution Containers (MXC) sollen es Entwicklern ermöglichen festzulegen, worauf ein Agent zugreifen darf, und Windows setzt diese Grenzen zur Laufzeit durch. Dazu kommen eigene Agentenidentitäten und Richtlinien, damit autonome Software nicht die vollen Rechte des Menschen übernehmen muss.89
NVIDIAs OpenShell setzt an einer ähnlichen Grenze an. Es steckt Agenten in Sandboxes, verweigert standardmässig jeden Zugriff, kontrolliert, wie weit sie ins Dateisystem und ins Netz reichen, vermittelt Zugangsdaten und leitet Inferenz nach Richtlinien weiter. Das wichtige Konstruktionsprinzip: Die Einschränkung wird ausserhalb des Denkprozesses des Agenten durchgesetzt. Man bittet das Modell nicht höflich, sich an die Regel zu halten; die Umgebung verhindert die Handlung.10
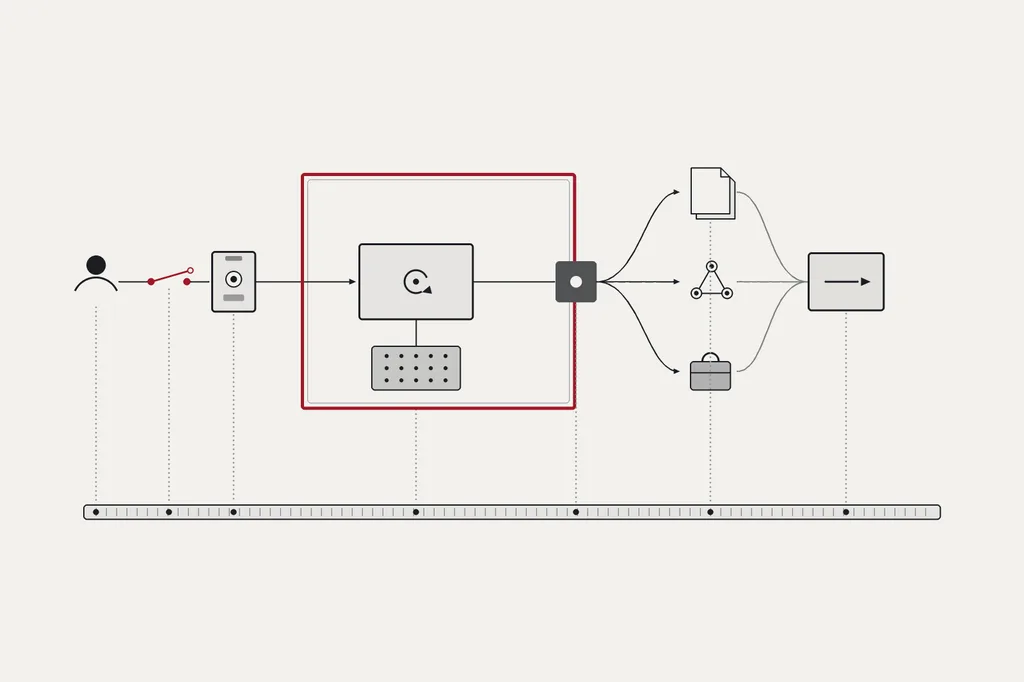
Das ist eine viel grössere Veränderung als eine «KI-Taste».
Das Betriebssystem kannte bisher Benutzer, Prozesse, Dateien und Anwendungen.
Jetzt beginnt es, Agenten als eigenständig handelnde Akteure zu kennen.
Identität, Berechtigungen, Isolation, Protokollierung und Widerruf müssen also neu gedacht werden, für Software, die über längere Zeit Ziele verfolgt.
Der KI-PC ist darum nicht einfach ein PC mit schnellem neuronalem Beschleuniger.
Er ist eine Maschine, die umgebaut wird, um Akteure zu beherbergen, denen wir etwas übertragen haben.
Vom Personal Computer zum persönlichen Rechennetz
Die interessanteste NVIDIA-Ankündigung im September ist vielleicht gar nicht der Laptop.
Vielleicht ist es PAIR.
Der NVIDIA Personal AI Router verbindet kompatible RTX-PCs, DGX-Spark-Systeme und unterstützte Macs im selben lokalen Netzwerk und macht sie zu einem Ort, an den man lokale Inferenz-Anfragen schicken kann. PAIR legt ihren Speicher nicht zu einer riesigen GPU zusammen, und es verteilt auch nicht ein einzelnes Modell über das ganze Haus. Es leitet unabhängige Anfragen an den geeigneten Knoten weiter, der gerade frei ist.11
Genau deshalb ist es für Agenten relevant.
Ein einzelner Chat läuft oft der Reihe nach ab. Ein Arbeitsablauf mit mehreren Agenten ist von Natur aus parallel.
Ein Agent prüft ein Repository, ein anderer analysiert Dokumente, ein dritter testet eine Hypothese, ein vierter prüft Quellen. Wenn alle hinter demselben lokalen Inferenzserver anstehen, wird das Agentensystem umso langsamer, je ehrgeiziger es wird.
Wenn sich diese Anfragen auf ungenutzte Rechner verteilen lassen, ändert sich die Architektur.
NVIDIA zeigte eine Aufgabe mit fünf Subagenten, die auf drei gekoppelten Rechnern in 8 Minuten und 48 Sekunden erledigt war, gegenüber 18 Minuten auf einem einzelnen RTX-Spark-Laptop. Das ist eine Demonstration des Herstellers, kein allgemeingültiges Leistungsergebnis. Aber sie zeigt, welche Topologie gemeint ist.11
Vom Heimnetz aus gesehen ist das ein kleiner Schritt. Vom Personal Computer aus gesehen ein grosser.
Der Personal Computer war früher eine Kiste.
Die Cloud machte diese Kiste dann fast bedeutungslos für die Frage, wo gerechnet wird.
Das neue Modell lokaler KI kann den Raum selbst zu einer kleinen Rechenumgebung machen: Laptop, Workstation, Mini-PC, NAS, vielleicht ein eigener KI-Knoten, und alle tragen Kapazität bei, innerhalb einer einzigen lokalen Richtliniengrenze.
IDC hat an der IFA 2026 dasselbe Muster gesehen. Hersteller zeigten dort KI-NAS-Systeme und gekoppelte Mini-PCs für Agenten, RAG und lokale Modelle. Die Schlussfolgerung war nicht, dass jedes Zuhause ein Rechenzentrum wird. Sondern dass lokale KI-Infrastruktur zu einer eigenen Produktkategorie wird.12
Das ist eine bedeutsame Verschiebung.
Das Endgerät ist nicht mehr bloss Kunde einer Infrastruktur.
Es kann selbst Infrastruktur werden.
Intelligenz mieten oder Kapazität besitzen
Cloud-KI hat eine wunderbare wirtschaftliche Abstraktion geschaffen.
Ich muss den Beschleuniger nicht besitzen. Ich muss ihn nicht kühlen, nicht patchen, nicht ersetzen und nicht auslasten. Ich schicke eine Anfrage und bezahle den Dienst.
Dieses Modell ist ausserordentlich effizient, wenn die Nachfrage unsicher ist, die Last in Schüben kommt, sich das beste Modell jeden Monat ändert oder die nötige Fähigkeit zu gross ist, um sie wirtschaftlich selbst zu besitzen.
Aber die Abstraktion hat ihren Preis.
Jedes nützliche Token bleibt Produktionskapazität von jemand anderem.
Jeder dauerhaft laufende Agent wird zum wiederkehrenden Kunden fremder Inferenz-Infrastruktur.
Jede Hintergrundprüfung, Klassifizierung, Planungsschleife, Zusammenfassung, jedes Embedding, jede Werkzeugentscheidung und jeder neue Versuch kann zu einem gezählten Ereignis werden.
Die lokale Maschine verändert die Buchhaltung.
Wenn ich die Hardware gekauft habe, ist eine weitere lokale Inferenz-Anfrage nicht gratis. Sie verbraucht Strom, Lebensdauer der Hardware, Speicherplatz, Ingenieurzeit und Gelegenheiten. Das System verliert an Wert. Modelle können ihm entwachsen. Der Speicher kann zum Engpass werden. Ein kaputter Treiber kann einen Tag kosten.
Aber die Grenzkosten sehen anders aus.
Eine gekaufte Maschine gibt mir einen Block Kapazität, den ich laufend einsetzen kann, ohne mich zu fragen, ob weitere zehntausend interne Modellaufrufe eine weitere API-Rechnung rechtfertigen.
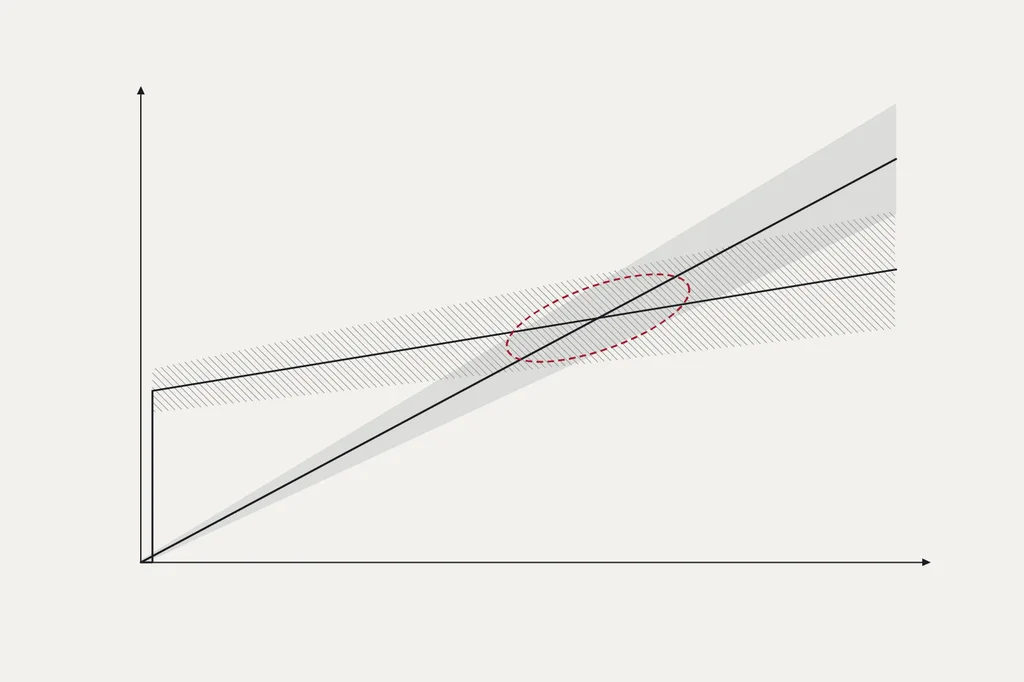
Das zählt vor allem bei agentischen Systemen, denn Agenten erzeugen Anfragen.
Ein Mensch stellt vielleicht eine Frage.
Ein fähiger Agent beantwortet sie womöglich mit fünfzig Modellaufrufen, drei gestarteten Subagenten, zehn abgerufenen Dokumenten, einer doppelten Prüfung des Ergebnisses und der Überwachung eines künftigen Ereignisses.
Die Rechnung für eine Antwort und die Rechnung für übertragene Arbeit sind nicht dieselbe.
Hier trifft lokale Rechenleistung auf den Gedanken, den ich in The Compounding Class verfolgt habe.
Zugang zu einer Antwort ist etwas anderes als die Fähigkeit, Maschinenarbeit in Auftrag zu geben. Und diese Fähigkeit ist wiederum etwas anderes, als die Infrastruktur zu besitzen, auf der diese Arbeit läuft.
Lokale KI-Hardware verkürzt den Abstand zwischen diesen Ebenen.
Sie macht aus einem Teil der Maschinenintelligenz statt einer Dienstleistungsausgabe ein produktives Gut.
Nicht für alle.
Nicht für jede Arbeitslast.
Aber genug, um die Grenze zu verschieben.
Das Ende der Cloud ist das nicht
Man ist versucht, die Geschichte als Pendel zu erzählen.
Grossrechner. PC. Cloud. Lokale KI.
So ordentlich verläuft Geschichte selten.
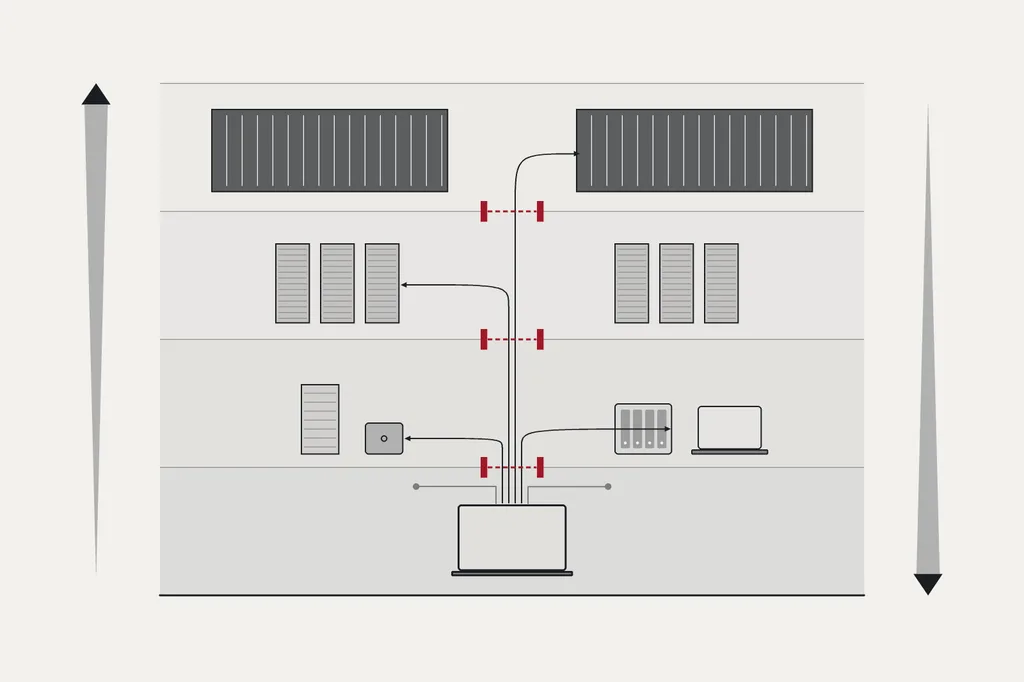
Wahrscheinlicher ist eine Zukunft, in der sich Schichten addieren.
Gartners Prognose vom September 2026 beschreibt die KI-Infrastruktur von Hyperscalern und Dienstleistern weiterhin als grössten einzelnen Posten der KI-Ausgaben, und der Ausbau der Rechenzentren geht in ausserordentlichem Umfang weiter.13
Gleichzeitig bauen die Hersteller von Endgeräten mehr Speicher und mehr Beschleuniger in persönliche Maschinen ein.
Beides kann vernünftig sein, weil es verschiedene Probleme löst.
Ein Frontier-Modell zu trainieren, bleibt Sache des Rechenzentrums. Millionen Nutzer zu bedienen, profitiert von gebündelter Infrastruktur. Eine seltene, äusserst schwierige Denkaufgabe kann ein Cloud-Modell rechtfertigen, das weit stärker ist als alles, was sich sinnvoll auf einem Laptop betreiben lässt. Unternehmen ziehen vielleicht zentral gesteuerte private Cluster vor. Endgeräte brauchen den Sprung in die Cloud, wenn Akku, Speicher oder Latenz an Grenzen stossen.
Apples Architektur Private Cloud Compute drückt genau diese Aufteilung von der anderen Seite her aus: lokal verarbeiten, wo es geht, und ausgewählte, schwierigere Anfragen in geschützte Cloud-Infrastruktur verschieben, wenn das Gerät nicht reicht.14
NVIDIA und Microsoft bauen aus ähnlichen Gründen Routing in ihren Agenten-Stack ein. OpenShell kann Modellanfragen nach Richtlinien weiterleiten, PAIR kann sie auf lokale Knoten verteilen, und Cloud-Endpunkte bleiben verfügbar, wo es erlaubt ist.1011
Die Zukunft sieht deshalb weniger nach «Cloud gegen PC» aus und mehr nach einer Hierarchie der Intelligenz.
Es gewinnt die nächstgelegene Rechenleistung, die genügt.
Ein kleines Modell erledigt die Routine.
Ein grösseres lokales Modell übernimmt private oder länger dauernde Arbeit.
Nahe, eigene Maschinen nehmen parallele Aufträge auf.
Private Infrastruktur trägt die Arbeitslasten einer Organisation.
Frontier-Systeme in der Cloud erhalten die Aufgaben, die sie wirklich rechtfertigen.
Das ist keine Dezentralisierung im ideologischen Sinn.
Es ist Nähe als technische Entscheidung.
Was lokale Rechenleistung zurückgibt
Hier gibt es echte Gewinne an Souveränität.
Der erste ist Kontinuität.
Wenn ein Modell, seine Gewichte, seine Inferenz-Engine und die nötigen Werkzeuge bereits auf der Maschine sind, verschwindet die Fähigkeit nicht sofort, bloss weil eine API ausfällt oder sich ein Preis ändert. Manche Funktionen laufen ohne externen Modellanbieter weiter.
Der zweite ist Datennähe.
Ein Vertrag, eine Codebasis, ein Familienarchiv, ein Forschungskorpus oder ein Kundendokument muss die lokale Umgebung nicht verlassen, nur um zusammengefasst, eingeordnet oder durchsucht zu werden. Das beseitigt nicht jedes Datenrisiko, aber es schaltet eine ganze Klasse von Übertragungen standardmässig aus.
Der dritte ist Latenz.
Der Umweg zu einem entfernten Modell fällt weg, wenn die Aufgabe lokal Platz hat. Das zählt bei Sprache, beim Programmieren, bei Bildverarbeitung, beim Zusammenspiel mit Anwendungen und bei Agenten, die viele kleine Entscheidungen treffen.
Der vierte ist Kostenkontrolle.
Kapazität lässt sich als Investition planen, nicht nur als gezählte Inferenz. Organisationen können selbst entscheiden, wo bei wiederkehrenden Arbeitslasten die Gewinnschwelle liegt.
Der fünfte ist freie Modellwahl.
Open-Weight-Modelle lassen sich in einer bekannten Version behalten, testen, feinjustieren, ersetzen und weiter betreiben, auch wenn ein Anbieter seine öffentliche API-Strategie ändert.
Der sechste ist Hoheit über die Ausführung.
Wenn Agenten-Laufzeit, Richtlinien und Daten lokal sind, lässt sich die Grenze der Befugnisse technisch um die Umgebung des Nutzers ziehen statt um den Dienst des Anbieters.
Das sind bedeutende Verbesserungen.
Souveränität sind sie für sich allein noch nicht.
Lokal ist nicht souverän
Eine Maschine kann unter meinem Schreibtisch stehen und im Betrieb trotzdem zu einer Lieferkette gehören, die ich nicht kontrolliere.
RTX Spark zeigt dieses Paradox sehr schön.
Die Plattform ist lokal.
Ihre Abhängigkeiten sind global.
NVIDIA liefert die Blackwell-GPU-Architektur, CUDA und den KI-Software-Stack. MediaTek sagt, es habe Know-how bei CPU, Speichercontroller, Energieversorgung und Konnektivität beigesteuert, und verweist ausdrücklich auf seine Fertigungspartnerschaft mit TSMC.15 Die CPU basiert auf der Arm-Architektur. Das Betriebssystem ist Windows. Treiber, Firmware, Compiler, Modellformate, Inferenz-Engines und Plattformen für die Verteilung von Modellen bleiben Teil des nutzbaren Systems.
Das Ergebnis gibt mir vielleicht mehr Kontrolle darüber, wo Intelligenz läuft, und macht zugleich das Software-Ökosystem eines einzelnen Herstellers noch wichtiger dafür, wie sie läuft.
Genau darum geht es in Open Is Not Sovereign.
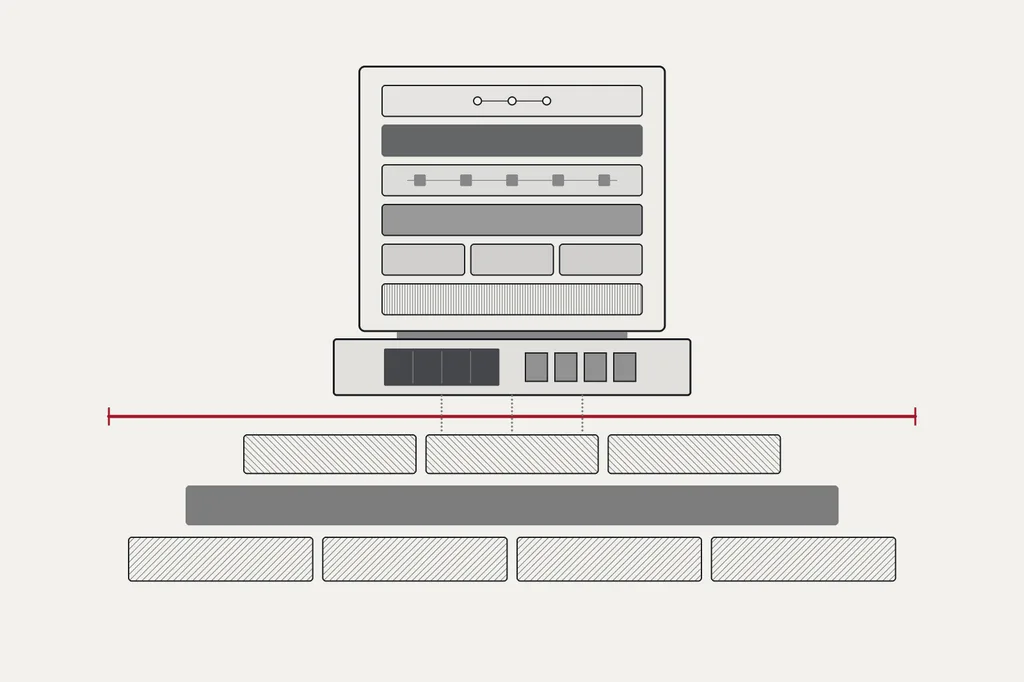
Ein Modell kann offene Gewichte haben und trotzdem von einer konzentrierten Laufzeitumgebung abhängen.
Ein Computer kann physisch mir gehören und trotzdem schwer ausserhalb eines einzigen Beschleuniger-Ökosystems zu betreiben sein.
Ein lokaler Agent kann ohne Cloud-API auskommen und trotzdem von einer Identitätsschicht von Microsoft, signierten Treibern, Modellregistern und Software-Updates abhängen.
Eine Maschine kann während eines Internetausfalls weiterlaufen und trotzdem für meine Organisation nicht in vernünftiger Zeit ersetzbar sein, wenn der Nachschub an Hardware ausbleibt.
Souveränität ist keine Ortsangabe.
Sie ist eine Eigenschaft des ganzen Systems.
Die richtige Frage lautet deshalb nicht:
Läuft diese KI lokal?
Sondern:
Wenn sich morgen ein wichtiger Lieferant, ein Dienst oder eine Software-Schicht ändert: Welche Fähigkeiten könnte ich dann noch betreiben, reparieren, ersetzen und verstehen?
RTX Spark verbessert einige Antworten auf diese Frage.
Alle beantwortet es nicht.
NVIDIA greift die Mitte des PCs an
Jahrzehntelang hatte der leistungsstarke Windows-PC eine fast rituelle Architektur.
Intel oder AMD lieferte die CPU.
NVIDIA oder AMD lieferte die GPU.
Der Arbeitsspeicher sass auf der Seite der CPU, der Grafikspeicher auf der Seite der Grafik. PCIe verband die beiden Welten.
Betriebssystem und Anwendungen waren überwiegend x86.
RTX Spark greift diese Ordnung von mehreren Seiten zugleich an.
Die CPU basiert auf Arm. Die GPU ist in dieselbe kohärente Plattform integriert. Der Speicher ist gemeinsam. CUDA läuft nativ. Dasselbe Gerät wird gleichzeitig fürs Gaming, für kreative Arbeit und für agentische Inferenz angepriesen. Und die Plattform kommt über ASUS, Dell, HP, Lenovo, Microsoft und MSI auf den Markt, weitere folgen.12
Das heisst nicht, dass Intel und AMD verschwinden.
AMD hat mit Ryzen AI Max bereits eine starke Antwort: x86-Kompatibilität, viel gemeinsamer Speicher und eine leistungsfähige integrierte Grafik machen lokale KI möglich, ohne den gewohnten Windows-Befehlssatz zu verlassen.6
Apple hat die strategische Kraft vertikaler Integration schon Jahre früher gezeigt: die Chiparchitektur, das Speichermodell, das Betriebssystem, die Entwicklerwerkzeuge und das Hardwaredesign selbst besitzen und dann die ganze Maschine als ein Produkt optimieren. Die aktuellen Apple-Chips treiben diesen Ansatz weiter in die lokale KI hinein.7
Qualcomm hat Windows mit Snapdragon bereits in Richtung Arm geschoben.
Was NVIDIA verändert, ist der Schwerpunkt des Wettbewerbs.
Zum ersten Mal versucht das Unternehmen, das zur dominierenden Plattform für KI-Beschleunigung geworden ist, auch die ganze Rechenbasis des Hochleistungs-PCs zu besitzen: CPU, GPU, Verbindung, Speicherarchitektur, Compiler und Laufzeit sowie den Agenten-Stack.
Die alte Frage war, welche CPU ins Zentrum des PCs gehört.
Die neue Frage ist vielleicht, ob der PC überhaupt noch ein einziges Zentrum hat.
Das eigentliche Produkt ist der Stack
Einen Chip kann man im Prinzip nachbauen.
Einen Stack nicht so leicht.
RTX Spark ist interessant, weil NVIDIA kein Blockdiagramm verkauft. NVIDIA versammelt CUDA, TensorRT, RTX-Grafik, Werkzeuge für Windows on Arm, Optimierungen für llama.cpp und vLLM, Integrationen für lokale Agenten, OpenShell, PAIR und Gerätedesigns der Hersteller um dieselbe Plattform.121011
Strategisch ist das wichtig.
Ein technisch überlegener Beschleuniger mit schlechter Modellunterstützung ist ein Benchmark-Ergebnis.
Eine Plattform, für die Entwickler bauen, verpacken, absichern, überwachen und ausliefern können, wird zur Infrastruktur.
Hier kann NVIDIAs Stärke zur Abhängigkeit anderer werden.
CUDA ist wertvoll, weil es funktioniert, weil Entwickler es kennen, weil Bibliotheken darauf zielen und weil Modelle routinemässig dafür optimiert werden.
Jeder dieser Gründe ist berechtigt.
Zusammen erzeugen sie Pfadabhängigkeit.
Je vollständiger die Plattform wird, desto leichter fällt die Wahl.
Je leichter die Wahl fällt, desto teurer wird der Ausstieg.
Das macht die Wahl nicht falsch.
Es macht den Ausstieg zu einem Teil des Designs.
Müsste ich lokale KI-Infrastruktur für eine Organisation beurteilen, würde mich deshalb mehr interessieren als Tokens pro Sekunde. Ich würde fragen, ob sich die Modelle mitnehmen lassen, ob die Datenformate portabel sind, ob sich die Richtlinien der Agenten anderswo nachbauen lassen, ob die Inferenz-API standardisiert genug ist, um sie umzuleiten, ob die Mitarbeitenden einen zweiten Stack verstehen und ob sich ein defektes Gerät durch etwas ersetzen lässt, das nicht dieselbe Abhängigkeit teilt.
Die schnellste Maschine ist nicht unbedingt die souveränste.
Souverän ist das System, dessen Fähigkeit einen Wechsel der Maschine überlebt.
Mit Agenten wird Souveränität persönlich
Es gibt noch einen weiteren Grund, warum das wichtig ist.
Je näher KI an den einzelnen Menschen rückt, desto weniger abstrakt wird die Frage der Souveränität.
Ein Cloud-Chatbot weiss, was ich eintippe.
Ein dauerhaft laufender persönlicher Agent kennt vielleicht meine Dateien, Termine, Kontakte, Vorlieben, Konten, Geräte, Nachrichten, Projekte und Gewohnheiten. Und er kann bei manchen davon handeln.
So ein Agent ist nicht bloss ein Werkzeug für mehr Produktivität.
Er wird zur Schnittstelle zu meinem digitalen Leben.
Mehr von dieser Intelligenz lokal laufen zu lassen, kann ein wichtiger Schutz sein. Der rohe persönliche Kontext kann hinter einer Grenze bleiben, die ich kontrolliere. Heikle Suchen müssen nicht immer wieder über einen externen Dienst laufen. Ein privates Modell kann mit Informationen arbeiten, die ich einem allgemeinen Assistenten nie bewusst hochladen würde.
Aber Nähe vergrössert nicht nur die Privatsphäre, sondern auch die Befugnisse.
Ein lokaler Agent kann näher an Zugangsdaten, privaten Schlüsseln, Quellcode, lokalen Anwendungen und angemeldeten Sitzungen sein, als es ein Cloud-Chatbot je war.
Darum sind Agentenidentität, Sandboxing und Protokollierung keine optionalen Zusätze zum KI-PC.
Sie gehören zu dem, was die Kategorie überhaupt tragfähig macht.
Der persönliche KI-Computer wird erst dann zum Werkzeug der Souveränität, wenn der Mensch die Befugnisse des Agenten weiterhin festlegen, seine Handlungen beobachten, ihn widerrufen, ersetzen und ohne ihn wieder weitermachen kann.
Sonst haben wir die Abhängigkeit nur von einem Cloud-Konto in eine Kiste auf dem Schreibtisch verschoben.
Das wäre Nähe ohne Handlungsfähigkeit.
Was das für die Schweiz bedeutet
Das Schweizer Gespräch über Souveränität beginnt oft zu weit oben im Stack.
Wir fragen, wo die Cloud-Region liegt, wo die Daten gespeichert sind, ob der Anbieter schweizerisch ist und ob der Vertrag die richtige Gerichtsstandsklausel enthält.
Diese Fragen sind wichtig.
Lokale KI schafft darunter eine weitere Möglichkeit.
Eine Anwaltskanzlei, ein Ingenieurbüro, ein Archiv, ein Industriebetrieb, eine Forschungsgruppe, eine Bank, ein Spital oder eine öffentliche Institution kann zunehmend nützliche KI-Arbeit leisten, ohne jedes Dokument und jeden Zwischenschritt des Denkens in einen gemeinsam genutzten, entfernten Inferenzdienst zu schicken.
Das kann die Angriffsfläche nach aussen verkleinern und die Kontinuität verbessern.
Für kleinere Organisationen ist die radikalere Veränderung wirtschaftlich. Arbeitslasten, die früher einen Server im Rack oder eine gemietete GPU verlangten, passen zunehmend in eine Workstation, einen Mini-PC oder einen leistungsstarken Laptop. Die technische Schwelle, um nützliche KI-Kapazität selbst zu besitzen, sinkt.
Für ein kleines Land, das von spezialisierten Unternehmen, vertraulichem Wissen und teurer Arbeit lebt, ist das strategisch attraktiv.
Aber die Schweiz sollte Beschaffung nicht mit Souveränität verwechseln.
Wer Tausende lokale KI-Computer kauft, schafft damit keine eigene Halbleiterindustrie. Keine Alternative zu CUDA. Keine Garantie auf Ersatzhardware in einem Lieferengpass. Und keine lokale Modellkompetenz von selbst.
Die nützliche Frage für Politik und Architektur ist enger und praktischer:
Welche kritischen KI-Fähigkeiten können wir lokal betreibbar, übertragbar und wiederherstellbar machen, auch wenn die weitere Lieferkette international bleibt?
Das ist erreichbar.
Und es ist ernsthafter, als so zu tun, als hiesse Unabhängigkeit, jeden Transistor selbst herzustellen.
Die Cloud machte Rechenleistung unsichtbar. Agenten machen sie wieder sichtbar.
Cloud-Computing hat einer ganzen Generation beigebracht, nicht mehr an Maschinen zu denken.
Das war einer seiner Triumphe.
Eine Instanz bereitstellen. Einen Endpunkt aufrufen. Ein Abo abschliessen. Skalieren, wenn nötig. Der physische Computer verschwand hinter einer Abstraktion.
KI kehrt einen Teil dieser Abstraktion um, weil Intelligenz Anforderungen an den Ort stellt.
Speicher zählt.
Latenz zählt.
Privatsphäre zählt.
Energie zählt.
Identität zählt.
Die physische Nähe zwischen dem Agenten und den Systemen, auf die er einwirken kann, zählt.
Und sobald ein Agent ununterbrochen arbeiten soll, wird die Frage, wem die Maschine gehört, die ihn am Leben hält, wirtschaftlich wieder bedeutsam.
Darum finde ich, dass RTX Spark mehr Aufmerksamkeit verdient als ein weiterer Prozessor-Launch.
Nicht, weil NVIDIA den klassischen PC an einem Abend beendet hätte.
Hat es nicht.
Nicht, weil ein Petaflop im Laptop die Cloud überflüssig machen würde.
Tut es nicht.
Und nicht, weil ein lokal laufendes Modell seinen Besitzer souverän macht.
Tut es nicht.
RTX Spark ist wichtig, weil es mehrere Entwicklungen zusammenführt, die bisher getrennt verliefen, und sie als eine Produktkategorie lesbar macht:
viel gemeinsamer Speicher;
beschleunigte lokale Inferenz;
persönliche Agenten;
Eingrenzung durch das Betriebssystem;
lokales Routing von Rechenleistung;
und eine PC-Branche, die zunehmend bereit ist, KI als ansässige Arbeitslast zu behandeln statt als entfernten Dienst.
Der klassische Personal Computer hat meine Anwendungen ausgeführt.
Der nächste beherbergt vielleicht meine übertragene Maschinenarbeit.
Das ist eine andere Beziehung zum Gerät.
Und eine andere Beziehung zu den Unternehmen dahinter.
Der Computer kehrt heim
Die Cloud hat den Computer zu einem Fenster auf die Maschine von jemand anderem gemacht.
Agentische KI könnte ihn wieder zu einer Maschine machen, die es sich zu besitzen lohnt.
Nicht, weil die Zukunft offline wäre.
Nicht, weil jedes Modell unter den Schreibtisch passt.
Nicht, weil lokale Hardware uns von Abhängigkeiten befreit.
Sondern weil eine immer wichtigere Schicht der Intelligenz wieder nahe bei dem Menschen, der Organisation und den Daten leben kann, die ihr ihre Befugnis geben.
Das gibt uns Wahlmöglichkeiten, die wir nicht hatten, solange jeder nützliche Modellaufruf die Grenze eines Anbieters überqueren musste.
Wir können einen Teil des Kontexts lokal behalten.
Wir können einen Teil der Kapazität besitzen.
Wir können manche Arbeit ohne API fortsetzen.
Wir können entscheiden, welche Aufgaben die Cloud verdienen, statt die Cloud einfach vorauszusetzen.
Wir können Agenten bauen, deren Richtliniengrenze der Umgebung gehört, der sie dienen.
Und wir können anfangen, Rechenleistung nicht nur als Versorgungsleistung zu sehen, die wir mieten, sondern als Fähigkeit, die wir manchmal besitzen wollen.
Souverän wird die Maschine dadurch noch immer nicht.
Bei Souveränität ging es nie um die Maschine.
Es geht darum, darüber echte Wahlfreiheit zu bewahren.
Die Frage, die ich zu RTX Spark stellen würde, ist deshalb nicht, ob es die Zukunft des PCs ist.
Die bessere Frage ist, welche Zukunft möglich wird, wenn die Intelligenz, die für uns arbeitet, nicht mehr ganz auf dem Computer von jemand anderem leben muss.
Zum ersten Mal im Zeitalter der Cloud steht die Antwort vielleicht auf dem Schreibtisch.
Anmerkung zur Recherche
Systeme mit RTX Spark wurden im Mai 2026 angekündigt. Zum Recherchestand am 30. September 2026 sagt NVIDIA, dass die ersten Systeme im Oktober kommen. Verkaufspreise, unabhängige Benchmarks von Seriengeräten, das thermische Verhalten unter Dauerlast, die Akkulaufzeit, die Software-Kompatibilität und die reale Leistung bei den Angaben zu 120B-Modellen und langem Kontext sind noch lückenhaft. Leistungsangaben von Herstellern sind in diesem Band als solche gekennzeichnet und nicht als unabhängig nachvollzogene Ergebnisse zu lesen.
Das übergeordnete Argument hängt nicht davon ab, dass RTX Spark in jedem Benchmark das schnellste Produkt wird. AMD, Apple, DGX Spark und andere lokale KI-Systeme zeigen bereits, dass Inferenz auf Endgeräten mit viel Speicher ein Branchentrend ist. RTX Spark wird hier als besonders sichtbares Zusammentreffen von Windows, CUDA, gemeinsamem Speicher und Agenten-Infrastruktur behandelt.
Quellen
Architektur, technische Daten, Verfügbarkeit und Sicherheitsfunktionen stützen sich vor allem auf Unterlagen und Ankündigungen der Hersteller. Leistungsangaben von NVIDIA, AMD, Apple und den PC-Herstellern sind Herstellerangaben, keine unabhängigen Benchmarks. Zum Recherchestand waren Seriengeräte mit RTX Spark noch nicht breit im Handel; Preise, Dauerleistung, Akkuverhalten und Software-Kompatibilität bleiben offen. Das Material von Gartner und IDC ist Prognose oder Messebeobachtung, keine Auslieferungsstatistik. Recherchestand: 30. September 2026, Europe/Zurich.
Footnotes
-
NVIDIA, NVIDIA and Microsoft Reinvent Windows PCs for the Age of Personal AI, 31. Mai 2026. https://nvidianews.nvidia.com/news/nvidia-microsoft-windows-pcs-agents-rtx-spark ↩ ↩2 ↩3 ↩4
-
NVIDIA, Sparks Fly: NVIDIA Accelerates Local AI at IFA 2026, 3. September 2026. https://blogs.nvidia.com/blog/local-ai-ifa-next-gen-agents-nv-pair-rtx-spark/ ↩ ↩2 ↩3
-
NVIDIA, Windows on Arm Porting Guide — System Overview, abgerufen am 30. September 2026. https://docs.nvidia.com/rtx-spark/rtx-spark-porting-guide/latest/overview.html ↩ ↩2
-
OpenAI, gpt-oss-120b & gpt-oss-20b Model Card, 5. August 2025. https://openai.com/index/gpt-oss-model-card/ ↩
-
PCWorld, Nvidia’s RTX Spark PCs launch in October with bold 100fps gaming promises, 3. September 2026. https://www.pcworld.com/article/3225974/nvidias-rtx-spark-pcs-launch-in-october-with-bold-100fps-gaming-promises.html ↩
-
AMD, FAQs: AMD Variable Graphics Memory, VRAM, AI Model Sizes, Quantization, MCP and More!, 29. Juli 2025; AMD, Agent Computers, abgerufen am 30. September 2026. https://www.amd.com/en/blogs/2025/faqs-amd-variable-graphics-memory-vram-ai-model-sizes-quantization-mcp-more.html und https://www.amd.com/en/products/processors/consumer/agent-computers.html ↩ ↩2
-
Apple, Apple introduces M6 and M5 Ultra for a big leap in performance and AI compute, 25. August 2026. https://www.apple.com/newsroom/2026/08/apple-introduces-m6-and-m5-ultra-for-a-big-leap-in-performance-and-ai-compute/ ↩ ↩2
-
Microsoft, Build 2026: Furthering Windows as the trusted platform for development, 2. Juni 2026. https://blogs.windows.com/windowsdeveloper/2026/06/02/build-2026-furthering-windows-as-the-trusted-platform-for-development/ ↩
-
Microsoft, Windows Agentic — Build and run agents locally on Windows, abgerufen am 30. September 2026. https://developer.microsoft.com/en-us/windows/agentic ↩
-
NVIDIA, NVIDIA OpenShell — Open, Secure Runtime for AI Agents, abgerufen am 30. September 2026. https://www.nvidia.com/en-us/ai/openshell/ ↩ ↩2 ↩3
-
NVIDIA, NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network, 3. September 2026. https://developer.nvidia.com/blog/nvidia-pair-virtual-inference-router-expands-available-compute-on-your-local-network/ ↩ ↩2 ↩3 ↩4
-
IDC, IDC on the Ground at IFA 2026: AI Set the Design Agenda for Every Device Category, September 2026. https://www.idc.com/resource-center/blog/idc-on-the-ground-at-ifa-2026-ai-set-the-design-agenda-for-every-device-category/ ↩
-
Gartner, Gartner Forecasts Worldwide AI Spending to Grow 49.5% in 2026, 16. September 2026. https://www.gartner.com/en/newsroom/press-releases/2026-09-16-gartner-forecasts-worldwide-ai-spending-to-grow-49-point-5-percent-in-2026 ↩
-
Apple Security Research, Expanding Private Cloud Compute, 8. Juni 2026. https://security.apple.com/blog/expanding-pcc/ ↩
-
MediaTek, MediaTek Collaborates with NVIDIA on RTX Spark to Power the Next Wave of Windows PC Experiences, 1. Juni 2026. https://www.mediatek.com/press-room/mediatek-collaborates-with-nvidia-on-rtx-spark-to-power-the-next-wave-of-windows-pc-experiences ↩